close

IT 基建

IT 基建人工智能企業趨勢

Nvidia 130 億美元收購 Hugging Face 據報受查 開源模型平台中立性成隱憂

科技領袖在伺服器機櫃間握住發光方塊,象徵雲端與數據中心的創新控制與AI應用.

Nvidia 早前同意以接近 130 億美元(約港幣 1,014 億元)收購開源 AI 模型託管平台 Hugging Face,據報美國司法部(DOJ)正向各方查詢交易會否影響 AI 市場競爭,包括對 Nvidia 競爭對手的影響。收購預計於 2027 年上半年完成;依賴該平台取得模型的企業,或需考慮如何為模型部署預留備援。

模型託管平台角色引起競爭疑慮

Hugging Face 提供開源平台,讓開發者託管及測試新 AI 模型,亦出售 AI 基建。報道指司法部的疑慮似乎源於這個平台角色,查詢涉及交易會如何改變 Nvidia 競爭對手的處境。

Tom’s Hardware 分析認為,收購可能被視為 Nvidia 為自家產品鎖定重要分銷渠道。Nvidia 已確認交易完成後,Hugging Face 會繼續支援多家晶片及 AI 供應商;不過截至該媒體刊出時,Nvidia 未有回應其就司法部疑慮提出的查詢。

Nvidia 行為早受司法部調查

司法部早前亦曾審視 Nvidia 收購 SchedMD。SchedMD 的軟件用於與國家安全有關的超級電腦,Nvidia 承諾會繼續支援該軟件。這項審視屬於一項為期 3 年、針對 Nvidia 行為的較大型調查。

官員亦曾在該調查中研究,Nvidia 有否以增加 AI 晶片配額,吸引客戶同時購買其網絡硬件及 Groq 晶片。Nvidia 於 2025 年 12 月以 200 億美元(約港幣 1,560 億元)收購 AI 晶片公司 Groq;這部分調查與 Hugging Face 交易分開。

模型託管平台易手,企業可預留自行託管備援

交易尚未完成,Nvidia 承諾繼續支援多家供應商的具體範圍仍有待釐清。企業 IT 團隊可先盤點哪些系統直接從 Hugging Face 取得模型,以及是否使用其推理或基建服務,再按依賴程度安排備援。

團隊亦可考慮把正在使用的模型權重及相關檔案保存於內部儲存,並檢視推理架構能否在不同晶片及雲端環境運行。對依賴外部平台的工作流程,定期測試轉至自行託管或其他平台的步驟,可讓團隊在需要切換時更有準備。

來源:Reuters
閱讀文章
IT 基建企業趨勢業界消息

HP、ASUS、Acer 部分產線遷回中國 主流 PC 物料成本已追上售價

自動化倉儲工作站,筆記型電腦放在輸送帶上,背景為工廠倉庫與分揀裝置.

據知情人士透露,HP、ASUS、Acer 等 PC 廠商正把部分產線由泰國及越南遷回中國,重新起用中國代工廠,以應對記憶體等零部件成本急升,並提高生產效率。這令廠商近年把產能分散到中國以外地區的「中國+1」策略出現部分回調。對準備換機的企業而言,除了預算,供應商的生產地及零件配置也可能需要重新確認。

記憶體價急升,主流 PC 物料成本漲約 6 成

一名晶片業高層向《日經亞洲》表示,記憶體及其他零部件價格明顯上升,PC 廠商愈來愈難自行消化成本,因此開始把部分生產轉回中國。AI 需求令記憶體晶片供應緊張,傳統 PC 代工巨頭亦把產能轉向利潤率較高、增長較快的 AI 數據中心伺服器業務,為中國代工廠留下市場空間。

一名遊戲 PC 廠商高層表示,DRAM 價格在一年內上升最少 8 倍,CPU、印刷電路板及被動元件成本亦同步上升。據報道引述的數字,售價 500 至 699 美元(約港幣 HK$3,900 至 HK$5,452)的主流 PC,物料成本由 2025 年第一季約 435 美元(約港幣 HK$3,393)升至 2026 年第三季 699 美元(約港幣 HK$5,452),增幅約 6 成,已追上該售價區間上限。

售價低於 500 美元的入門 PC,物料成本同期由 275 美元(約港幣 HK$2,145)升至 471 美元(約港幣 HK$3,674)。出貨量亦見下滑:市場調查機構 Omdia 數據顯示,2026 年 7 至 9 月全球 PC 出貨量按年下跌 21%,並預計零部件供應持續緊張下,第四季將下跌 24%;另一機構 Counterpoint Research 則預測第四季下跌 27%,2027 年全年市場大致持平。

「中國+1」部分回調,Dell 亦評估遷回

《日經亞洲》在 2023 年曾報道,全球第三大 PC 製造商 Dell 要求供應商減少使用中國製零部件,並推動生產轉往越南;HP 亦計劃把部分產能移出中國。今次部分產線轉回中國,令這個方向出現一定程度逆轉。

據知情人士透露,Dell 亦正評估把部分生產遷回中國。上述晶片業高層認為,如果成本環境沒有改善,廠商可能進一步增加中國產能。

HP、Dell 及 ASUS 沒有回應相關報道。Acer 表示會動態調整供應鏈管理,以增強供應鏈韌性及保持競爭力,多元化選擇製造商及供應商一直是其策略,但沒有直接確認遷廠;遷廠規模、涉及的產品線及時間表均未披露。

中國代工廠接手採購,晶片選擇權增加

Acer 已把更多零部件採購職責下放給中國代工廠,包括處理器及記憶體。一名 PC 業高層稱,HP、Dell、Lenovo 及 ASUS 亦採取類似做法。另有晶片供應商高層認為,中國代工廠現時比部分小型 PC 品牌更有權決定各型號採用哪些晶片。

有中國代工廠向 PC 廠商推銷時,以合作可較穩妥取得中國產記憶體晶片作賣點。2 名知情人士稱,中國代工企業華勤技術及龍旗科技的代表今年頻繁拜訪 HP、ASUS 及 Acer。

另有 3 名知情人士表示,Apple 主要代工商立訊精密與六聯智能合資成立專門設計及製造 PC 的 LuxPC Union,過去一年已取得 HP、Dell 及 ASUS 訂單。

企業 PC 採購要預留加價與配置變動

物料成本上升後,企業換機預算可能需要預留加價或交貨期變化的空間。IT 及採購主管安排大批採購時,可先向供應商確認報價有效期和供貨承諾,再按實際報價調整預算。

代工廠承擔更多採購職責,亦可能令同一型號不同批次的記憶體或晶片配置出現差異。企業可要求供應商列明關鍵元件規格,以便在建立標準化系統映像及測試驅動程式時核對。對需要評估供應鏈地緣風險的企業,也可查詢個別商用型號的實際生產地,重新檢視產地分佈。

準備下一輪換機時,除了比較每部電腦的報價,也可一併確認交貨和配置條件。

閱讀文章
IT 基建資訊及通訊科技雲端服務

Cloudflare 第三季記錄 14 宗停電斷網 企業分散電訊商未必能分散風險

資料中心伺服器機櫃與冷卻風扇在走道中.

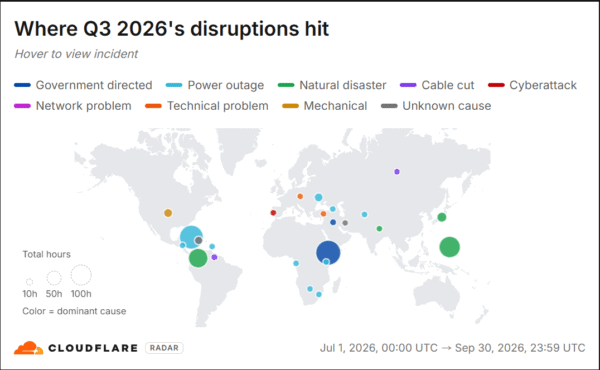
Cloudflare 旗下網絡流量監測平台 Cloudflare Radar 在 2026 年第三季記錄 49 宗斷網,其中 14 宗與停電有關,遍及 10 個國家,是僅次於政府下令斷網的第二大成因。洪都拉斯一個互連設施停電,令全國 HTTP 流量下跌 63%;美國鳳凰城一個數據中心冷卻系統失效,則令網域及寄存服務商 Namecheap 多項服務中斷。事故顯示企業業務持續性可能受供應商背後的電力、冷卻及互連設施影響。

第三季 49 宗斷網,停電成第二大成因

Cloudflare Radar 在 7 至 9 月記錄的 49 宗斷網中,政府下令斷網佔 19 宗,包括伊拉克為考試而斷網的 18 宗;停電佔 14 宗,天災則佔 5 宗。

TechnologyChecker.io 根據 Cloudflare Radar API 數據自行統計,停電相關事件由第二季的 1 宗增至第三季的 14 宗;剔除政府下令斷網後,2026 年及 2025 年第三季各有 30 宗事件。該統計的 9 月數字屬暫定。

部分事件持續時間較短:14 宗在 1 小時內恢復正常流量,16 宗在不足 3 小時內恢復。Cloudflare 指美國、日本及葡萄牙等網絡韌性一向較強的國家也有斷網事件。

地區分布的電力中斷與網路故障圖,顯示全球各地的停電及網路中斷熱點.

互連設施停電,洪都拉斯流量跌 63%

Cloudflare 指洪都拉斯一個互連設施在 9 月 10 日停電,影響至少 11 家主要供應商。斷網維持約 3 小時,期間全國 HTTP 流量下跌 63%。Cloudflare 認為事件顯示集中的流量交換點可以成為單點故障。

跨境供應商 Telecomunicaciones de Guatemala 和流動網絡商 Celtel 未受影響,Cloudflare 推測兩者在洪都拉斯的連線可能較依賴境外基建。這意味企業即使選用不同電訊商,若它們的流量仍經同一設施交換,分散供應商未必能分散風險。

Cloudflare 第三季停電事件圖示,顯示多次網路流量與異常波動與停電期間的影響.

冷卻故障波及 Namecheap 多項服務

8 月 13 日,鳳凰城數據中心營運商 RadiusDC 的設施出現冷卻系統故障,Cloudflare 觀察到 Namecheap 的網絡流量幾乎完全消失。Namecheap 表示一場大風暴令冷卻系統失效,設施溫度升至危險水平;RadiusDC 要求它暫停服務,Namecheap 因而主動關掉超過 5,000 部伺服器,以保護硬件。

RadiusDC 一份客戶通告則把設施高溫歸因於隔夜風暴造成的多次市電波動,惟 Namecheap 本身只提及風暴令冷卻系統失效,未有確認這個成因。

事故影響寄存、EasyWP、Private Email、DNS 管理、URL 轉址管理及客戶支援系統,但 DNS 解析未受影響。由於支援系統也受波及,Namecheap 改用後備 Microsoft Teams 帳戶處理客戶支援。

Namecheap 的服務分階段恢復。按其狀態頁,由 8 月 13 日 12:35 UTC 發出緊急公告至 8 月 14 日 17:00 UTC 標示解決,歷時約 28 小時 25 分鐘。Namecheap 行政總裁 Hillan Klein 公開道歉,並承諾檢討事故成因、現有保障及程序的失效之處、應對過程和所需改變。

停電可令網絡中斷數日,後備線路有助恢復

電網故障也可令網絡長時間受影響。古巴第三季有 4 次停電相關斷網,包括 9 月 18 至 20 日連續 3 日停電;各次事件的流量跌幅介乎 18% 至 59%。

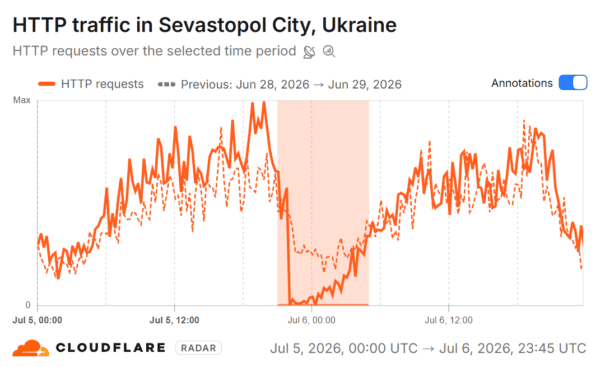
烏克蘭塞瓦斯托波爾(Sevastopol)在 7 月 5 日停電後斷網 8 小時,HTTP 流量下跌 98%;8 月 12 日無人機襲擊能源設施再造成停電,斷網 10 小時,流量最多下跌 95%。

關島受超強颱風 Bavi 吹襲時,強風吹倒主要輸電線。關島電力局(Guam Power Authority)表示,一度只有約 25% 的配電饋線仍在運作;網絡流量用了多日才恢復。同期 Rostelecom 稱俄羅斯遠東地區的骨幹光纖在 9 月 19 日遭蓄意破壞,並表示已透過後備線路恢復連線。

企業應追問供應商的電力、冷卻及互連依賴

企業 IT 及營運主管可向雲端、寄存和數據中心供應商查問後備發電與冷卻冗餘的設計,以及風暴或市電波動時的處理程序,包括甚麼情況下可能需要暫停服務。採購網絡服務時,也可確認不同供應商是否共用同一互連設施,以及有否經其他地點或境外的後備路徑。

企業亦可考慮將網域註冊、DNS、網站和電郵分散至不同供應商,減少單一設施故障同時影響多項服務的風險。Namecheap 事故中連客戶支援系統亦受波及,企業可準備獨立於主要供應商的後備溝通渠道,讓事故期間仍有途徑聯絡相關人員。

來源:Cloudflare Blog、TechnologyChecker.io

閱讀文章
IT 基建企業趨勢資訊及通訊科技

Starlink 由衛星走向手機電訊 SpaceX 傳洽租 8 萬站點衝擊三大電訊商

SPACEX 設施外觀,清晰可見的公司標誌與現代化工廠建築.

SpaceX 據報正洽談租用至少 8 萬個美國基地台站點,對象包括大型通訊基建公司 Crown Castle。知情人士指,相關協議將鞏固 SpaceX 建立美國第 4 個全國性流動電訊商的路向。消息傳出後,AT&T 及 T-Mobile 股價在周五收市各跌近 8%,Verizon 跌約 1.2%。Starlink 由衛星網絡走向手機電訊的計劃,正延伸至地面基建,但站點租約尚未公開確認,建網容量及投資回報亦受到分析師質疑。

8 萬站點接近 T-Mobile 鐵塔數目

這次洽談涉及站點使用權,而非收購 8 萬座基地台。SpaceX 正與至少一家大型通訊基建公司商談,Crown Castle 是其中一家;該公司與 American Tower、Vertical Bridge 均屬美國主要鐵塔業主。交易價值據報可能達數十億美元,但截至發稿時仍未有公開確認已簽約。

Crown Castle 行政總裁 Chris Hillabrant 在業績電話會議上被問到是否正與 SpaceX、Amazon 等衛星電訊商洽談租約時,只表示可以假設公司正與所有相關方商談,並拒絕透露個別客戶詳情。American Tower 不予置評,SpaceX 及 Vertical Bridge 未即時回應傳媒查詢。

8 萬個站點已接近大型流動網絡的鐵塔數目。BNP Paribas 分析師 Sam McHugh 指,T-Mobile 約有 8.5 萬座鐵塔,另有約 6 萬個小型基站。美國無線基建協會(Wireless Infrastructure Association)數字則顯示,美國去年共有 15.85 萬座專用基地塔;8 萬個站點約相當於其中一半,但站點亦可設於天台等位置,不能直接當作鐵塔數目比較。

Starlink 擬結合衛星與地面網絡

地面站點是 SpaceX 手機電訊計劃的另一部分。美國聯邦通訊委員會(FCC)已批准 SpaceX 發射 1.5 萬枚可直接連接手機的衛星;SpaceX 早前亦同意向 Grain Management 購買最多 14 MHz 配對的 800 MHz 全國低頻頻譜。《華爾街日報》估計頻譜交易約值 80 億美元(約港幣 624 億元),Grain 未公布作價,交易仍待 FCC 批准。

Elon Musk 在業績電話會議上表示,SpaceX 會建設地面網絡,讓 SpaceX 及 Starlink 獲准營運的地方有廣泛連接。公司早前亦提出利用家用上網設備,在用戶安裝點附近發射流動訊號;但研究機構 MoffettNathanson 指,用戶所在地未必就是網絡維持穩定覆蓋所需的位置。租用專門站點可能有助補足這類覆蓋缺口。

SpaceX 總裁 Gwynne Shotwell 表示,以自有頻譜提供的美國服務目標為 2028 年初。SpaceX 美國自家服務的時間表曾推遲一次,現時的站點洽談亦不等於網絡已建成或服務已推出。

電訊股受壓,鐵塔業主股價上升

站點消息傳出後,美國 3 大電訊商在盤後交易各跌約 5%;到 10 月 23 日收市,AT&T 及 T-Mobile 各跌近 8%,Verizon 跌約 1.2%。鐵塔業主股價則上升,Crown Castle 在消息公布後的盤後交易最多升約 10%。有外國財經媒體將電訊股受壓解讀為市場擔心 SpaceX 進軍地面無線網絡會加劇競爭。

電訊股早前已因 SpaceX 下跌一次:10 月 9 日 SpaceX 宣布頻譜交易及取得衛星批准後,AT&T、Verizon 及 T-Mobile 股價分別下跌 9.8%、8.7% 及 13.3%。Bernstein 分析師 Laurent Yoon 認為,SpaceX 最終能否租用接近 8 萬個站點仍不確定,但洽談規模顯示其投入已超出單純累積頻譜。

由零建網回報成疑,收購或成替代路線

站點數目接近現有電訊商,仍不等於網絡容量相同。上述 BNP Paribas 分析師認為,SpaceX 網絡初期用戶少時,服務或可與現有電訊商相若,但承載數以百萬計用戶時便無法匹敵。他亦質疑由零複製鐵塔、頻譜及分銷網絡的回報,認為收購電訊商,或促使現有電訊商提供流動虛擬網絡營辦商(MVNO)協議,是較清晰的路線;在收購選項中,他認為 T-Mobile 最可信,但這只是分析師的看法,並非已披露的交易計劃。

有外國媒體引述 TD Cowen 估計,建設全國地面網絡可能需要超過 800 億美元(約港幣 6,240 億元),並需多年投資。對在美國有業務的企業而言,SpaceX 進場或會影響日後流動及物聯網合約的議價空間,衛星與地面網絡結合亦可能增加車隊、偏遠據點的連接選擇。不過 SpaceX 以自有頻譜提供服務的目標仍是 2028 年初,現階段宜把它列為採購規劃的觀察選項,而非已可替代現有電訊服務的供應商。

來源:Bloomberg、ZeroHedge、Yahoo Finance、NBC News

閱讀文章
IT 基建人工智能雲端服務

馬來西亞首相稱 SoftBank 擬投 500 億美元 企業算力選址仍待容量細節

SoftBank 旗艦銀行分行外牆招牌清晰可見.

馬來西亞首相宣布 SoftBank 創辦人孫正義擬在當地投資 500 億美元(約港幣 3,900 億元),涵蓋 AI 及數據中心。區域算力供應或增,企業選址仍要核對延遲、電力及資料主權條件。

馬來西亞首相安華(Anwar Ibrahim)近日宣布,SoftBank 創辦人孫正義(Masayoshi Son)計劃在馬來西亞投資 500 億美元(約港幣 3,900 億元),涵蓋 AI、新興技術及數據中心。消息由馬方公布,未見 SoftBank 確認;若計劃實行並增加數據中心容量,東南亞的雲端及算力選址可能多一個區域選項,但企業仍需按實際供應條件評估。

孫正義選砂拉越與半島投資 AI 基建

據 Bloomberg 報道,安華在馬六甲一場活動上公布消息,指投資地點選定砂拉越、古晉及馬來西亞半島,他早前亦已與孫正義開網上會議討論相關事宜。這筆資金目前屬計劃投資,報道未提及時間表及各地金額分配。500 億美元涵蓋多個領域,不能全數視為數據中心投資。對企業採購而言,投資總額亦不足以判斷日後有多少算力可供使用;具體項目及容量安排,才是評估新增供應的依據。

企業評估區域算力要先核對部署條件

假如部分資金用於增加數據中心供應,企業日後可能多一個算力及託管選擇,亦可能增加議價或備援空間。IT 團隊可先按工作負載訂立選址條件,比較候選地點與用戶之間的實際網絡延遲,再判斷該地點適合即時應用,還是較適合訓練及批次工作,避免單憑投資規模決定部署地點。

評估供應商時,企業亦可詢問電力供應及擴容安排,並核對資料存放地點是否符合公司與客戶的資料主權要求。這些條件需要逐個項目確認;現階段可把馬來西亞這項計劃列入中長期選址觀察,待容量、服務及交付安排清晰後再比較,不宜單憑今次公布改動現有部署。

來源:Bloomberg

閱讀文章
IT 基建人工智能雲端服務

SpaceX 稱籌 400 億美元搶 Nvidia GPU Elon Musk 預言逾 200 家算力租賃商倒閉

Elon Musk-like figure holds a glowing microchip in a server room.

馬斯克(Elon Musk)日前在 X 發文,稱 SpaceX 已完成 400 億美元(約港幣 3,120 億元)債務融資,用來購買 2027 年上半年交付的 Nvidia GPU,並把融資能力歸功於投資級信用評級,以及 Starlink 衛星上網和火箭發射收入。他同時聲稱,過去幾星期,除 AI 數據中心外沒有可觀收入的公司,幾乎已完全無法在債務市場融資,並預測 200 多家 neocloud(專門出租 AI GPU 算力的新雲端業者)會大批倒閉整合。這番說法把算力競賽的焦點,由晶片採購推向供應商的融資能力。

400 億美元購 GPU,靠衛星與火箭收入融資

交易是否真的已完成,目前只有他本人的說法,未見貸款方聲明或公開文件證實;「完成」具體指甚麼、投資者是否已同意定價,亦仍不清楚。他表示,融資主要是可提前贖回的債務(callable debt),用來支付 2027 年第一及第二季交付的 GPU,對 2026 年第四季影響不大。

他把 SpaceX 能夠取得資金,歸功於公司的投資級評級,以及 Starlink 和火箭發射業務收入。按他的解釋,SpaceX 借得到錢,靠的是 AI 以外的收入來源,而非單靠未來算力需求。截至發稿時,最終貸款方名單、利率、年期,以及 GPU 型號與數量均未披露。

AI 收入增至約 9 倍,SpaceX 仍大舉借貸

SpaceX 本身的 AI 業務亦已迅速擴大。CNBC 引述公司最新業績指,第三季 AI 業務收入由一年前的 8.13 億美元(約港幣 63.4 億元),增至 75.6 億美元(約港幣 589.7 億元),達原來約 9 倍,成為公司最大業務部門。另有外國媒體報道,公司同期總收入約 145.8 億美元(約港幣 1,137.2 億元),按年增約 160%。

SpaceX 預期第四季資本開支達 350 億至 400 億美元(約港幣 2,730 億至 3,120 億元);上述 400 億美元融資則主要支付明年上半年交付的 GPU,兩個數字不宜混為一談。單看支出規模,第四季預計資本開支已遠高於第三季總收入,反映收入急升也未必足以支撐擴張速度;但收入並非現金流,這個比較不能直接當作融資缺口。

外國傳媒引述 SpaceX 財務總監 Bret Johnsen 在業績電話會議上的說法指,公司正與金融機構商討進一步借貸,並有信心在維持投資級評級下,有節制地推進計劃。

較早的融資方案亦把保住評級列為重點。交易完成前的報道指,融資計劃透過特殊目的實體(SPV)進行,讓債務不計入 SpaceX 資產負債表,由 Goldman Sachs 牽頭與 Apollo Global Management 等投資者商談;當時計劃約 100 億美元(約港幣 780 億元)來自銀行貸款,另有 300 億美元(約港幣 2,340 億元)為投資級債務。有報道指,採用這種表外安排,是要避免重演 AI 初創 xAI 去年最終須把約 130 億美元(約港幣 1,014 億元)債務計入帳目的情況;惟最終條款至今仍未確認。

馬斯克預言逾 200 家 neocloud 倒閉整合

他在帖文中把融資市場收緊與 neocloud 前景連在一起:沒有 AI 數據中心以外可觀收入的公司,過去幾星期幾乎已無法借貸,因此他預測 200 多家 neocloud 會大批倒閉整合,只有少數能夠生存;他亦表示 SpaceX 不會收購任何一家。這是他的市場預測,並非已發生的倒閉潮。

資金需求則有更廣泛的市場背景。Morgan Stanley 早於 6 月預測,AWS、Microsoft、Google 及 Meta 的 2026 年資本開支合計達 7,000 億美元(約港幣 5.46 兆元),2027 年超過 1 兆美元(約港幣 7.8 兆元);Goldman Sachs 預計這些公司借貸額由今年的 2,500 億美元(約港幣 1.95 兆元),增至明年的 4,000 億美元(約港幣 3.12 兆元)。Morgan Stanley 另預計今年全球 AI 相關債券發行超過 5,700 億美元(約港幣 4.45 兆元)。外國傳媒報道,投資者已因新債供應龐大,要求 AI 基建相關公司債提供更高孳息。

若借貸成本持續上升,其他業務收入可能成為大型雲端商和 SpaceX 的融資緩衝;相較之下,純靠出租 GPU、同時要借貸擴張的業者,可能承受較大壓力。這有助理解上述預測背後的邏輯,但不能據此判定哪一家 neocloud 會遭淘汰,也不能把小型供應商一概視為不穩定。

企業租 GPU 算力,先查供應商收入與債務

對 CIO 及 IT 主管而言,這次融資消息帶來的採購問題,是供應商能否持續履約。比較 GPU 租用價格和交付期時,可一併詢問對方收入是否只靠出租算力、現有融資來源,以及未來 1 至 2 年擴張依靠甚麼資金;若對方無法清楚交代,便應把這項不確定性納入長約及預付款決策。

合約亦宜寫明供應商遭收購、停業或服務中斷時,資料取回、遷移及退款如何處理。對長期訓練或推理工作負載,企業可評估分散至多家供應商,或保留轉往大型雲端平台的後備方案,減少單一供應商出問題時整項工作停頓的風險。

來源:Bloomberg、CNBC

閱讀文章
IT 基建企業趨勢金融科技

黃仁勳稱 AI 晶片可用 8 年作抵押 企業 GPU 折舊不宜照搬廠商說法

著名科技領袖微笑面對鏡頭,背後有NVIDIA標誌與紅色背景.

Nvidia 行政總裁黃仁勳(Jensen Huang)接受訪問時表示,Nvidia 的 AI 運算系統可使用 8 年或以上,投資者和貸款機構一般假設的 4 年更換周期,已不能反映實際可用年期。他又稱,以 Nvidia 運算資產作承保的風險是「所有資產中最低」,日後貸款機構或可接受這些設備作抵押。這番話與 Nvidia 推動 GPU 抵押融資的商業利益直接相關,而從已知的貸款條款看,市場仍傾向把 GPU 當作高折舊設備定價。對估算折舊、融資及租用成本的企業而言,「8 年」宜視為廠商說法,不宜直接當作會計依據。

Nvidia 稱 AI 晶片可用 8 年,承保風險「最低」

他在 GTC Berlin 會場外接受財經媒體訪問時,主張傳統上與 GPU 掛鈎的 4 年周期,已追不上 Nvidia 運算系統的實際使用年期。他的理據是同一套系統可服務多個客戶、多種工作負載及應用,所以剩餘價值「非常非常高」,只是金融市場還未把這種價值計入融資決定。

Nvidia 另一項理據來自軟件。公司表示,CUDA 軟件層會在硬件部署後持續提升效能,令舊晶片保持生產力的時間比傳統會計模型預期的長。

惟轉述這次訪問的報道都沒有交代「8 年」指哪一代產品,亦沒有說明是物理壽命還是經濟可用年期。兩者對折舊和抵押估值的意義很不同,企業引用這個數字時要先分清。

保值說法,是 Nvidia 推抵押融資的前提

這番說法有明確的商業背景。Nvidia 早前(2026 年 8 月)宣布與 Apollo、BlackRock、Blackstone、Brookfield、Goldman Sachs 及 KKR 合作設立獨立運算融資平台,目標是逐步動用逾 5,000 億美元(約港幣 3.9 兆元)第三方資金為 AI 基建融資,對象包括信貸評級或現金不足以直接購買晶片的公司。

這套計劃的關鍵假設,是 GPU 能像傳統硬資產般長期保值,不會像消費電子產品般快速貶值。Nvidia 正把自家 GPU 包裝成可投資的基建資產,有評論認為此舉可維持舊款硬件的需求,令公司收入持續。因此「8 年」和「最低風險」這兩個說法,應視為與 Nvidia 商業利益直接掛鈎的廠商立場。

評論亦指出一個結構性矛盾:充當抵押品的晶片由 Nvidia 生產,推出新一代產品、令舊晶片抵押價值下跌的也是 Nvidia。另有報道指 Nvidia 會在抵押品價值不如預期時承擔最多 25% 的差額,惟另一報道指這項條款未見於公司自己的公告,條款細節仍未能確定。TechCrunch 評論指,這類擔保會帶來「wrong way」風險:需求轉弱時,Nvidia 的責任反而增加。

H100 租金上升,不等於所有舊晶片保值

市場數據有部分支持保值說法。黃仁勳引述的數字顯示,H100 1 年期合約租金由 2025 年 10 月約每 GPU 小時 1.70 美元(約港幣 HK$13),升至 2026 年 3 月約 2.35 美元(約港幣 HK$18),約 5 個月升約 38%,原因是超大規模雲端商搶建產能,造成供應緊張。以每月 720 小時(24 小時 × 30 日)全天租用一張 H100 計,月租約由 1,224 美元(約港幣 HK$9,500)升至 1,692 美元(約港幣 HK$13,200)。

有報道指 A100 及 H100 的剩餘價值高於預期,B200 的租用或轉售價更據報相當於原價 158%,惟該報道沒有列出出處。業內人士指出,舊加速器的價值取決於狀況、供應、系統配置及預期工作負載。尖端 GPU 用了幾年後,通常由前沿模型訓練轉到利潤較低的推論工作,這直接影響其轉售及抵押價值。評論亦提醒,新一代產品對二手價的影響視乎規格形態、保養、買家限制及供應而定。

所以租金上升反映的是現階段供應緊張,未必等於長期保值。

貸款條款仍把 GPU 當高折舊設備定價

貸款機構的做法與「最低風險」並不一致。FedWatch Advisors 創辦人 Ben Emons 指折舊是「關鍵風險」,晶片可能比預期貶值更快;若中國以低價晶片傾銷,抵押品價值或跌得比債務年期更快。他估計投資者會把 GPU 當作高折舊設備,按在資本結構中的位置要求約 11% 至 17% 的回報。

據 GPU 平台 Spheron 引述 SemiAnalysis 等整理(該平台與議題有商業利益,數字亦屬二手整理),貸款機構一般要求償債覆蓋率至少 1.3 倍,以及已簽署的 3 至 6 年承購合約,現貨租約不計。H100、B200 級硬件的貸款成數上限約 60% 至 70%,營運商要自付約 20% 至 30% 股本;非超大規模企業的 SPV 融資額度約 2,000 萬至 5 億美元,年息約 8% 至 15%。貸款年期按承購合約長度配對,並非按硬件壽命;該平台形容這類貸款本質上是以貶值快、二手市場不深的硬件借錢。

借款人方面,CoreWeave 等 AI 雲端商已以 Nvidia GPU 及數據中心資產借入數以十億美元計資金。據美國銀行證券(Bank of America Securities)報告,這類借款人多屬非投資級別公司,例如 AI 初創及新興雲端商;若它們倒閉,基金經理要收回二手晶片,並可能要在下跌的市場轉售。

投資者 Michael Burry 則批評整個融資計劃是「華爾街噱頭」,涉及不透明的私募信貸安排。他在 2025 年底亦指,Nvidia 每 2 至 3 年更新一代產品,超大規模雲端商假設伺服器可用 5 至 7 年並不現實,並估計 2026 至 2028 年間折舊可能被低估約 1,760 億美元(約港幣 1.37 兆元)。與「8 年」說法對照,貸款市場的合約年期、成數和息率,反映市場仍未把 GPU 當作低風險資產。

企業訂折舊與租用預算,不宜照搬 8 年

財務主管訂 GPU 折舊年期時,較穩妥的做法是參考貸款市場以 3 至 6 年合約配對的做法,以及 Burry 所指 2 至 3 年一代的更新周期,並用較短年期做壓力測試,不宜直接採用廠商的 8 年說法。

決定購買還是租用前,先評估工作負載幾年後能否在舊一代晶片上以推論等用途運行;只用於前沿訓練的設備,剩餘價值風險較高。使用 GPU 雲端或融資方案時,要向供應商問清合約年期、貸款成數、息率,以及剩餘價值擔保有否寫入合約,同時評估供應商本身是否非投資級別借款人,一旦倒閉服務如何延續。租用預算亦應預留租金波動空間,H100 1 年期合約租金短短數月升約 38%,就是例子。

來源:Benzinga、TechCrunch

閱讀文章
IT 基建人工智能資訊保安

Red Hat、Nvidia 主張 AI 代理不應自守邊界 隔離權限改由平台層管

高科技數據中心硬件,包括伺服器和連接的存儲裝置.

Red Hat 近日在柏林 Nvidia GTC 宣布擴大與 Nvidia 的合作,以雙方的 AI 平台 Red Hat AI Factory with NVIDIA 為核心,結合開源代理沙盒 OpenShell,以及在 BlueField 資料處理器(DPU)上運行的 Sentry 安全框架,把 AI 代理的安全控制放在代理之外,部分監察及隔離能力更移到主機之外。雙方亦推出模型存取參考設計,以閘道管理權限、配額及成本。這套分工意味企業部署自主代理時,可能需要把原由應用團隊處理的邊界控制,交由平台、基礎設施及保安團隊共同管理。

代理不應自守邊界,控制移到代理之外

方案針對兩類風險:代理越出獲授權範圍,以及攻擊者透過提示注入(prompt injection)或供應鏈攻擊入侵代理。代理本身出錯或遭入侵時,企業便不能只靠代理內部的指令及邏輯,限制它接觸哪些資源。

Nvidia 企業軟件副總裁 John Fanelli 在聲明中指出,代理不應自行執行邊界控制,相關控制應放在代理之外的運行環境(runtime)及底層基礎設施。今次設計可理解為把控制分配到不同層次:OpenShell 限制代理運行時的行為,Sentry 從獨立硬件層監察及隔離工作負載;另一項模型存取參考設計則管理代理可用哪些模型、使用多少資源。

OpenShell 在核心層設界,代理不接觸密鑰

OpenShell 是開源的代理沙盒運行環境,Red Hat 與 Nvidia 都是主要貢獻者。兩家公司稱它可提供標準化防護措施(guardrails)、運作可見度及運行時安全。

據 Tech Times 報道,OpenShell 以 Rust 編寫,採用 Apache 2.0 授權,政策引擎在代理程序以外運行;它透過 Linux Landlock 限制檔案系統存取、seccomp BPF 過濾程序可使用的系統呼叫,再以網絡命名空間(network namespaces)隔離代理的網絡環境。檔案系統及程序政策在建立沙盒時鎖定,網絡及推理政策則可在沙盒運行期間更新,毋須重新啟動。模型供應商的 API 密鑰存放在沙盒外的主機,由 OpenShell gateway 轉發請求;代理只接收模型回應,不會接觸底層密鑰。

身份與密鑰管理亦已有相關整合。IBM 早前在 9 月底的網誌指出,Nvidia 當時發布 Open Agent Safety Platform,而處於公開預覽階段的 IBM Agent Identity 及 HashiCorp Vault 亦已與 OpenShell 整合,為代理提供經驗證身份及最低所需存取權。

這種政策分工讓企業可把建立沙盒前必須確定的限制,與運行後可調整的網絡及模型政策分開審批。例如應用團隊提出所需資源,再由平台及保安團隊決定開放哪些權限,而非讓每個代理自行維護一套邊界。

Sentry 在 DPU 監察,防線獨立於主機

在 OpenShell 軟件層之下,Nvidia Sentry 安全框架在 BlueField DPU 上運行,透過 DOCA Argus 從獨立的硬件安全域監察工作負載。Red Hat 技術網誌指出,Argus 會檢查選定的主機記憶體結構,觀察程序、檔案及網絡活動,主機毋須安裝監察軟件。整合的保安系統可利用 Argus 警報觸發 BlueField 政策,隔離受影響的工作負載,警報亦可接入企業的 SIEM、SOAR 及 XDR 平台。

Red Hat 稱 Sentry 可在數毫秒內隔離受入侵的代理。這層設計的重點是把 AI 工作負載與網絡、安全服務分開:前者在伺服器 CPU 上運行,後者在 BlueField 的 Arm 處理器上執行。系統設定為限制主機存取時,即使攻擊者入侵主機,這種分隔仍有助保護基礎設施控制。

架構建基於 Red Hat OpenShift 4.22 現有的 BlueField-3 支援,惟 Sentry 部署需要哪一代 BlueField 硬件,公布資料未有說明。把監察及網絡功能移到 DPU,可減輕主機 CPU 負擔,騰出更多算力給 AI 工作負載;但企業評估這項取捨時,亦要把 DPU 硬件需求,以及網絡和保安團隊的設定工作納入部署規劃。

模型存取交閘道管,集中管理配額與成本

模型存取是另一項獨立參考設計。雙方以 Nvidia Inference Hub 參考設計為基礎,結合模型即服務(Model-as-a-Service,MaaS)存取控制、AI Gateway,以及 vLLM、llm-d、Nvidia Dynamo 和 NIM 微服務等推理技術,把存取管治與模型執行分開。

設計提供自助模型探索、細緻存取政策、速率限制及訂閱權益追蹤,支援配額管理及成本分攤。企業可據此評估由 IT 部門按部門或代理設定模型使用政策,避免每個代理各自持有模型帳戶,以致權限與用量難以統一管理。

Nemotron 3.5 Super VL 等 Nvidia Nemotron 模型亦已獲 vLLM 及 Red Hat AI Factory with NVIDIA 支援。Red Hat 稱透過 LLM compressor 的 FP8 量化及 DSpark 推測解碼(speculative decoding),可降低推理延遲並保持準確度,但沒有提供具體效能數字。

參考設計已可取得,原生整合仍在進行

Red Hat 表示聯合用例、參考設計及代理功能已可經 Cisco、Dell Technologies、Lenovo 等合作夥伴取得;但截至發稿時,把 OpenShell 參考架構原生整合到 Red Hat AI 及 Red Hat AI Factory with NVIDIA 的工作仍在進行,未有完成日期。企業現時可取得相關設計,惟平台未完成原生整合。

Red Hat Enterprise Linux for NVIDIA 已支援 Nvidia Vera CPU,並為即將推出的 Vera Rubin 平台作準備,目標在硬件推出時即提供相容支援。Nvidia 聲稱 Vera 的代理 CPU 效能快 2 倍,但未列出比較基準。Red Hat 作業系統網誌則指出,RHEL for NVIDIA 26.03 只修改少量核心套件以配合新硬件,保留標準 RHEL 用戶空間及 SELinux 等安全控制;待硬件修補程式成熟並進入上游 Linux 核心後,用戶毋須重裝便可轉回主線 RHEL。

平台與保安團隊要接手代理隔離與權限

企業可先盤點現有代理的權限由誰設定和執行。若邊界只寫在代理指令或應用程式內,可評估改由運行環境及平台層統一執行,同時檢查模型 API 密鑰是否仍放在代理可讀取的位置,再決定是否以閘道集中管理配額及按部門分攤成本。

採購前則要向供應商確認 Sentry 所需的 BlueField 世代、現有伺服器能否沿用,以及 Argus 警報如何接入現有 SIEM/SOAR。應用團隊提出代理所需資源,平台團隊管理沙盒及模型存取,保安團隊審批政策並定義事故隔離流程,可作為責任劃分的起點;尤其要先確定代理或主機失守時由誰啟動隔離,以及哪一層仍能執行控制。

來源:Red Hat、SiliconANGLE、Tech Times、IBM Newsroom

閱讀文章
IT 基建人工智能企業趨勢

SpaceX 加薪 20% 抽調員工建 AI 超算中心 擴建樽頸落在帶隊人手

工程師戴著安全帽在建設工地上監督工程進展.

SpaceX 據報正招募內部員工,到田納西州孟菲斯(Memphis)或密西西比州南海文(Southaven)駐場 6 周,支援 Colossus 1 及 2 數據中心擴建。這兩個超級電腦設施原由 xAI 興建,現時用來支援 SpaceX 的算力業務。員工在派駐期間基本薪金或時薪提高 20%,另可獲發與項目成效掛鈎的獎金。公司點名要找能帶隊、清除障礙的人,反映擴建壓力可能落在項目領導及現場執行能力上。SpaceX 日前公布業績時表示,AI 收入已超過 70 億美元(約港幣 546 億元),接近整季收入的一半。

加薪 20% 派駐 6 周,帶隊能力比職級重要

據 Business Insider 看到、10 月初發給全體 SpaceX 員工的內部電郵,公司需要現有及新晉領導者,在更多超級電腦投入運作時帶領團隊、清除障礙。報名者不必已是經理,有建築經驗會加分,但公司最重視幹勁。報名者工作表現須良好,年資超過 1 年者優先。

20% 薪酬溢價只適用於派駐期間,並非永久加薪;員工亦可獲發與項目成效掛鈎的獎金。

另一封內部電郵顯示,SpaceX 最遲由 8 月起已用同樣的 20% 溢價,招募內部專家赴孟菲斯參與其後 3 個月的數據中心建設。計劃預定於 2026 年 12 月 31 日結束,但可能延長。兩封電郵均列明差旅費及後勤由公司負責。

Elon Musk 稱算力需求足以租出數倍

xAI 今年 2 月併入 SpaceX 後,孟菲斯及南海文的超級電腦已成為公司業務的重要部分。SpaceX 公布業績時表示,超過 70 億美元的 AI 收入包括向 Anthropic、Google 等企業出租算力;行政總裁 Elon Musk 則向投資者稱,想租用算力的公司不斷追着 SpaceX,需求足以把算力租出好幾倍。

SpaceX 除了抽調一般員工,亦委派一名前 Starship 高層負責孟菲斯的算力建設。他本人表示經常每周有 4 天留在當地,推動公司在 2027 年底前新增 10 GW 算力的目標。

SpaceX 抽調人手有前例,曾加薪最多 25%

SpaceX 內部把這類抽調稱為「surge」,即把其他部門的人手及資源集中到關鍵項目。公司並非首次用薪酬溢價鼓勵員工臨時調任:據報 2022 年公司推動 Starship 發射時,曾向臨時調往德州支援的員工提供 10% 至 25% 加薪。

今次 20% 溢價落在當年的範圍內,可見 SpaceX 慣以短期加薪換取員工臨時調任,但單憑薪酬幅度無法判斷兩次調動的難度或成效。

企業擴建要先算人手與原部門代價

SpaceX 的招募條件說明,AI 基建項目除了工程技術,亦可能需要能協調團隊、處理阻滯的負責人。規劃自建或擴建 AI 基建的企業,可在硬件預算之外,先列出各階段的項目領導人選、決策權限及原部門交接安排,再決定是否抽調內部員工。

比較集中支援與其他人手方案時,薪酬溢價、獎金及差旅只是看得見的支出。企業亦應評估原部門可能出現的人手空缺及交付延誤;若安排缺乏建築經驗的員工到工地,便要按工作內容確認培訓、監督及安全要求。派駐期若延長,亦應重新檢視輪替安排及疲勞風險。

來源:Jingletree

閱讀文章
IT 基建人工智能資訊保安

黃仁勳柏林 GTC 推 OpenShell 企業 AI Agent 加入硬件層安全管控

高科技芯片與電子元件,展示先進的半導體技術與微電子設計.

NVIDIA 行政總裁黃仁勳 10 月 21 日在柏林 GTC 公布 OpenShell Reference Architecture,讓企業在 AI Agent 自主操作檔案、網絡及工具時,透過獨立於 Agent 的機制限制權限。架構結合 Vera Rubin 運算系統、Vera CPU 及 BlueField-4 DPU,亦可延伸至 RTX Spark 等本地 AI 電腦。

AI Agent 有五個組件 權限不能只靠指令約束

黃仁勳在主題演講中把 AI Agent 拆成 5 部分:負責推理的模型(Model)、管理執行流程與記憶的 Harness、隔離運行環境的 Sandbox、企業內部知識,以及能夠執行工作的工具。Agent 可以讀取企業資料、呼叫程式及連接外部服務後,管理員便需要逐項規定它能接觸甚麼資源。

NVIDIA 的 OpenShell 是開源安全執行環境,利用沙盒、網絡存取規則及憑證隔離管理 Agent。當中 Gateway、Supervisor 及 Policy Prover 等組件負責檢查操作和權限政策,防止 Agent 自行擴大授權。企業可按不同工作設定最小必要權限,而非只在 Prompt 裡要求模型不要執行危險操作。

BlueField-4 獨立監察 安全政策延伸至硬件層

NVIDIA 將 Vera Rubin 用於模型推理、Vera CPU 用於執行 Agent 的 Harness,再以 BlueField-4 DPU 運行 Sentry 安全框架,從主機外部監察 Agent 行為。按照 NVIDIA 的設計,即使 Agent 所在軟件環境遭入侵,安全政策仍可在獨立硬件上執行;公司聲稱一旦發現越權操作,可在毫秒內隔離相關 Agent。這屬 NVIDIA 公布的技術能力,不能直接視為所有企業部署後均可達到相同效果。

企業軟件商已開始把這套管控方式接入產品。ServiceNow 在同日宣布個人企業 AI Agent「Arc」正式推出,透過 Control Tower 管理操作權限,並以 OpenShell 執行政策。其 AI Passport 與 NVIDIA Sentry 的進一步硬件整合仍待日後版本;SAP 則表示正把 OpenShell 參考架構接入 Joule Studio 的執行環境。

▲ NVIDIA 行政總裁黃仁勳在柏林 GTC 主題演講介紹 AI Agent、運算基建及個人 AI 電腦的發展方向。(圖片來源:NVIDIA)

RTX Spark 已於本月上市 聯發科參與處理器設計

黃仁勳同場介紹以 RTX Spark 為基礎的個人 AI 運算方向。NVIDIA 早於 10 月 16 日已宣布首批 RTX Spark Windows 手提電腦上市,由 ASUS、Dell、HP、Lenovo、Microsoft 及 MSI 推出。平台整合 Blackwell RTX GPU、Grace CPU,最高配置 128GB 統一記憶體,標稱 FP4 AI 算力可達 1 PFLOP;聯發科參與客製化 CPU 設計。

這類裝置容許開發者及員工在本地運行部分模型和 Agent 工作流程,減少所有任務都依賴遠端服務的需要,但並不代表企業資料處理可完全離線。黃仁勳以 2016 年交付 OpenAI 的 DGX-1 作體積與算力比較,惟不同裝置採用的運算精度及負載有別,不能將宣傳數字視為實際效能相等。

DSX POD 預先整合機櫃 14 日部署須先備妥場地

AI 基建方面,NVIDIA 亦公布 DSX POD,讓合作夥伴在工廠內完成伺服器、網絡、供電及液冷系統的整合測試,再運往客戶現場。NVIDIA 指,在電力、冷卻及網絡等場地設施已準備妥當的前提下,部署時間可由約 6 個月縮短至最快 14 日,合作夥伴計劃於 2027 年初開始交付。參與廠商包括台達電、鴻佰、技嘉、和碩、雲達及緯創。

黃仁勳在演講中亦以斥資約 500 億美元興建的 AI 工廠為例,估算若投產延遲 3 個月,可能錯失約 100 億美元收入。這是用來說明投產速度經濟影響的假設情境,並非已實現營收或任何個別項目的實際損失。另一方面,他展示 NVIDIA 與台積電合作 COUPE 製程的共封裝光學交換技術,希望縮短晶片與光學傳輸之間的訊號路徑。

資料來源:NVIDIA OpenShell 官方公告、GTC Berlin 主題演講逐字稿、ServiceNow 公告、RTX Spark 官方公告、DSX POD 官方公告

閱讀文章