close

IT 基建

IT 基建中小企雲端專區企業趨勢業界專訪雲端服務

嘉民荃灣西數據中心年內落成 多方協調電力工程加快竣工


▲嘉民集團項目管理總監黃達之(左)及中華電力輸電部總監黃偉強早前在將近完工的嘉民荃灣西數據中心園區介紹發展進度。

嘉民集團項目管理總監黃達之(Gary)表示,為配合嘉民集團於全球設置 5000 兆瓦 (MW)數據中心的未來發展策略,嘉民早年收購了荃灣沙咀道一塊舊紡織廠用地 (即前中央紗廠位置),將其轉型為數據中心園區,以滿足香港及亞太地區的數據中心不斷增長的需求。他指出,由於荃灣位處市區核心地帶,亦與工商業及住宅區緊密連接,對於科網以至新興 AI 服務而言,在物理時延 (latency)上亦有優勢。因此規劃發展荃灣西數據中心園區,為香港發展先進數據中心,更有效率配合市場與政策對科網及新興數字經濟發展。


▲黃達之表示,嘉民集團對準香港及亞太地區的數據中心不斷增長的需求,協助各數據商加快部署。

嘉民全球佈局 滿足香港數據中心需求

Gary 表示,嘉民計劃興建四棟數據中心,定位高質量數據中心,並為每座大樓配備獨立的高壓客戶變電站,總建築面積達 160 萬平方尺,主供電設備裝置容量高達 225 兆伏安 (MVA),迎合先進數據中心、資訊科技、通訊及工業行業需要。因此,嘉民在建築規劃之初便與中電接觸,就數據中心的用電需求進行研究和規劃,並參考相關的國際標準及要求,共同探討及開發合適的設計方案,例如建設高壓客戶變電站,並配合緊急發電機和備用發電設施配置等,確保數據中心的電力具高度的穩定和可靠性,同時確保在施工和客戶變電站的交接過程安全順利進行。

▲嘉民與中電團隊緊密協作,就數據中心的用電需求共同探討合適的設計方案。

地理位置受限   後移建造位置成功破局

不知道大家有否留意,一般置於商廈的中小型客戶配電房多數位於二樓或較高的樓層,方便騰出地方用盡商用空間。但對於需要更大電量的數據中心而言,在他們的大型客戶變電站中,高壓電力裝置的體積和重量皆較為龐大,最大一組電力裝置組件更重達 70 噸。為了配合組件運輸和安裝,以及符合樓面承重限制,組件置於地面更為穩妥安全。沙咀道位於荃灣舊區,周邊街道繁忙且狹窄,項目旁邊更有一條 20 米高架空天橋,大幅增加建設過程的挑戰。因此嘉民的項目團隊向中電「取經」,透過技術研討會和參觀中電的高壓變電站,了解 132 千伏高壓變電站的配置要求,以便在建築設計的前期階段,盡早規劃數據中心園區分階段發展的佈局。

▲項目旁有一條 20 米高架空天橋 (圖左側),園區建造時需往後移 (圖右),以騰出更多空間便利工程進行。

中華電力輸電部總監黃偉強(Alex)表示,由於與嘉民預早溝通,建築前已發現地理限制,中電遂建議將數據中心園區的建造位置往後移,同時將擺放高壓電力及重型設備的房間設置在地面,既突破原有的場地限制,亦在園區與架空天橋之間騰出了更多空間,有利運送各種高電壓及重型的電力設備,更大幅減低因工程可能會帶來封路的不便。

▲中電與嘉民團隊調整園區設計以騰出空間,有利運送各種重型的電力設備。

▲其中一組電力裝置組件重達 70 噸,為配合安裝及符合樓面承重限制,組件置於地面更為穩妥安全。

Alex 亦透露,中電按數據中心園區的電力需求和分階段發展的規劃,為嘉民度身設計短、中期的供電方案,例如 11 千伏的配電網絡作為短期供電安排,滿足園區在運作初期發展所需;又提供專門的備用供電方案等,應付園區在中、後期營運階段的電力需求,令園區可以靈活發展。

聯繫數字辦 加快推進發展先進數據園區

▲黃偉強指中電發揮「超級聯繫人」角色,協助嘉民透過數字辦助力與相關政府部門協調,加快園區項目發展。

Alex 補充,中電除了提供技術支援,更協助嘉民聯繫數字政策辦公室 (數字辦)、投資推廣署等,了解在香港發展數據中心的便利措施,同時透過數字辦幫忙與相關政府部門聯繫和協調,有利項目加快發展。

Unwire.pro 翻查新聞資料,其實該數據中心園區在規劃初期,原本預計要至 2026 年才陸續完工,現時園區進度加快,更可在今年內完成,其中一個高壓客戶變電站的電力工程,更比嘉民之前規劃的時間提前半年以上完成,對於世界各地建設先進數據中心經常出現工程延誤的常態而言,也是一項鮮有的佳績。香港數據中心協會主席李松德指:「數據中心對電力需求一般都要經過一段『爬坡期』,電力公司提供不同階段的供電方案,亦有助數據中心發展更具彈性,能夠盡早投運。」


閱讀文章
IT 基建人工智能儲存技術

Samsung OCP 2026: 發表 HBM5、CXL 記憶體及 256TB SSD 佈局 AI 數據中心

演講者在綠色背景幕布前發言,背景有OCP全球峰會標誌.

Samsung 電子在美國聖荷西舉行的 OCP Global Summit 2026 公布下一代 AI 記憶體及儲存策略,並與 AMD 合作驗證 CXL 記憶體擴充技術。Samsung 另一項 CMM-D 記憶體池化測試顯示,與固定分配記憶體相比,動態分配可令 AI 推理產生首個 Token 的等候時間最多縮短 38%,達標吞吐量最高提升至原來 3.3 倍。

與 AMD 合作驗證 CXL 技術 記憶體容量可按需要共享

隨着 AI 智能體開始處理多步驟工作,系統需要保留更多對話內容及運算過程中的中間資料。Samsung 記憶體業務應用工程團隊副總裁沈浩俊在 10 月 12 日演講時指出,AI 推理所需的 KV Cache 容量持續增加。除了記憶體頻寬,容量擴充能力及資料管理亦會影響系統效能。

Samsung 與 AMD 合作驗證的 CXL 技術,讓系統透過高速互連擴充記憶體容量。Samsung 展示的 CMM-D 記憶體模組支援記憶體池化,讓多個工作負載按需要分配及共用記憶體資源,減少個別系統受固定容量所限的情況。

Samsung 另外以 GPU 伺服器運行多個大型語言模型實例,測試動態 CXL 記憶體分配。與固定配置相比,產生首個 Token 的時間(TTFT)最多縮短 38%,達標吞吐量(Goodput)最高達原來 3.3 倍。這些數字來自 Samsung 自行展示的測試,並非與 AMD 合作驗證所得的結果。

Samsung 同時公開內部實際部署結果。公司在美國園區利用 AI Memory Node 方案支援內部 AI 編程智能體及其他應用。採用可組合的記憶體層級後,KV Cache 利用率達原來 5 至 7 倍。不過這是 Samsung 在自家環境取得的數據,未能據此推算其他企業可節省多少成本。

HBM5 配合新一代 SSD AI 記憶體走向分層管理

Samsung 今次介紹的技術分為高速記憶體、容量擴充及資料持久儲存三個方向。高效能記憶體產品包括 HBM4E、HBM5、客製化 HBM 概念及 LPDDR5X-PIM,並配合 CXL 記憶體與企業級 SSD,處理不同類型的 AI 數據。

LPDDR5X-PIM 將部分運算工作移至記憶體內進行,減少資料往返傳輸。Samsung 在自家 Edge AI Accelerator 使用 Llama 3.1 8B 模型測試,聲稱每秒產生的 Token 數量最高達傳統 LPDDR5X 配置的 3 倍,執行時間方面的改善最高達 2.2 倍。相關結果只適用於官方列出的測試環境。

儲存產品方面,Samsung 展示採用 PCIe Gen6 的企業級 SSD PM1763,以及容量達 256TB 的 BM1773 QLC SSD。PM1763 的連續讀取速度最高達 28.4GB/s,Samsung 亦展示了針對液冷系統的配置。

Samsung 同時研究將部分 KV Cache 資料轉存至 SSD,透過記憶體與儲存裝置分層管理 AI 推理數據。相關方案包括整合 LMCache 軟件及改善 SSD 寫入管理,期望在記憶體容量有限的情況下,仍可支援更大型的 AI 工作負載。

由供應晶片走向共同設計 Samsung 擴大 AMD 合作範圍

Samsung 早於今年 3 月已擴大與 AMD 的合作。雙方當時簽署合作備忘錄,涉及 Samsung 為 AMD Instinct MI455X GPU 供應 HBM4,以及開發供下一代 EPYC 處理器和 Helios 機櫃級平台使用的記憶體方案。

今次 OCP 活動進一步將雙方合作延伸至 CXL 記憶體擴充及系統效能驗證。Samsung 表示會在產品開發初期與客戶共同設計,並結合記憶體、儲存硬件及軟件改良工作,將合作範圍由個別零件擴展至整個 AI 系統。

對計劃自行部署 AI 推理基建的企業而言,這類技術提供增加記憶體容量及改善資源使用率的途徑。不過 Samsung 公布的效能數據來自不同測試及內部部署環境,企業仍須按實際模型、同時使用人數、硬件配置及工作負載驗證效果。現有資料亦不足以估算整體持有成本或投資回本期。

資料來源:
Samsung Semiconductor 官方 OCP 2026 技術展示
Samsung 與 AMD 合作公告
Seoul Economic Daily

閱讀文章
IT 基建人工智能企業趨勢

AI 年代連 Git 也被取代 Anthropic 自研 Scion 每日處理逾 3 萬次程式碼變更

Anthropic單核每日變更數據圖表,顯示2026年1月至9月變更數量趨勢.

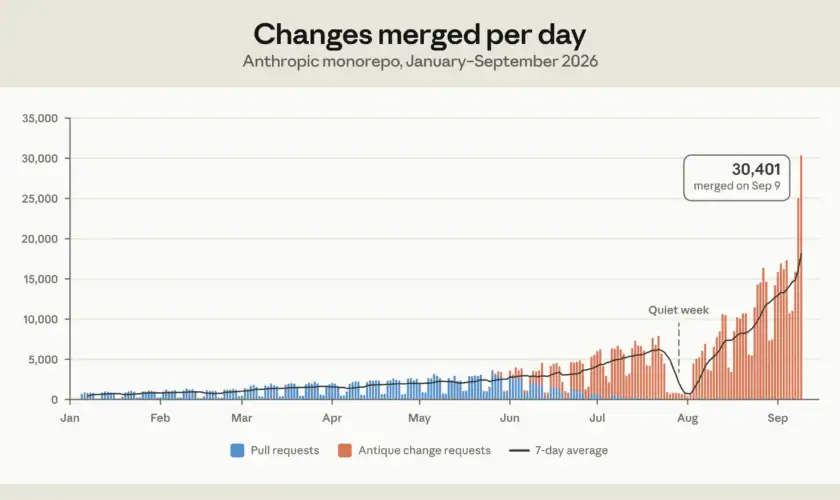
AI 開始改變程式傳統開發工具。Anthropic 10 月 13 日公布,已在五個月內將內部大型程式碼庫(monorepo)由 Git 全面遷移至自研版本控制系統 Scion。原因是 Claude 等 AI Agent 令程式碼產出速度急增,每日合併變更由 2026 年 5 月約 2,500 次,升至 9 月超過 30,000 次,原有 Git 基建逐漸無法應付。


AI 寫碼量激增逾 12 倍 Git 原有優勢反成負擔

Git 自 2005 年推出以來,一直是軟件開發最重要的版本控制工具之一。它採用分散式設計,開發者可以在電腦保存完整程式碼歷史,即使離線亦可修改、比較及管理版本。

這套設計非常適合人類開發者,但 Anthropic 發現,大量 AI Agent 需要同時讀取和修改同一個大型程式碼庫時,情況已經不同。

Anthropic 的主分支歷史紀錄接近 100GB,壓縮後的工作副本亦超過 25GB。單計持續整合測試(CI),系統每日就要執行約 2,500 萬次程式碼 checkout 操作。公司推算,如果沿用直接下載完整 Git 資料的方式,每日可能產生超過 600PB 的理論傳輸量,並非實際已使用的頻寬。

Anthropic 曾使用淺層複製、部分檔案 checkout、儲存快照及數百部內部 Git 鏡像伺服器減輕負擔。不過隨著程式碼變更越來越密集,維護這些系統反而需要投入更多資源。

公司指出,絕大部分 AI Agent 和自動化工作本來就需要連接伺服器,沒有必要像傳統 Git 一樣,讓每個客戶端都具備獨立處理完整程式碼庫的能力。


Scion 將版本操作搬到伺服器 CI 節省 25% CPU 容量

Anthropic 因此重新設計版本控制架構。Scion 將 commit、merge、rebase、查閱修改紀錄等工作放在伺服器執行,開發者或 AI Agent 只需要取得實際用到的檔案,無須先下載龐大的完整程式碼庫。

舉例來說,傳統 CI 工具可能要先取得程式碼及相關版本資訊,才能比較兩次修改的差異。Scion 則提供 API,讓工具直接向伺服器查詢結果,部分工作甚至完全不需要建立本地程式碼副本。

Scion 亦採用多層快取及分散式架構,各層快取命中率均超過 99%。Anthropic 公布的內部數據顯示,新系統相對原有 Git 鏡像架構,CPU 及記憶體基建需求縮減至約二百分之一。

CI 和研究工作所需的程式碼 checkout 時間亦由分鐘級縮短至秒級,速度提高約 100 倍。單是 CI 工作便節省約 25% CPU 容量。不過這些數據來自 Anthropic 自家工作負載,不能直接推算其他企業採用後的節省幅度。

▲ Scion 使用分層快取及伺服器架構,讓開發工具按需要取得程式碼,減少完整複製大型程式碼庫。
7 人團隊五個月完成 Claude 寫程式仍要人類審查

這次轉型另一個特別之處,在於開發 Scion 的過程同樣大量使用 AI。

Anthropic 表示,只有 7 名工程師的團隊,在 5 個月內建立 Scion、配套程式碼審查工具 Antique,以及搜尋、存取權限管理等相關系統,並完成內部大型程式碼庫的遷移。

團隊曾要求早期版本 Claude Mythos Preview 重寫原本由工程師開發的 Git 至 Scion 資料轉換程式。公司稱新版本在保留原有資料處理規則下,記憶體使用量減少至二十分之一,執行速度提高 4 倍。

不過 Anthropic 同時指出,AI Agent 有時會為完成眼前任務,違反系統架構原本設定的限制,甚至加入過量驗證和不必要的複雜設計。因此工程師仍須判斷技術取捨,並否決不合適的方案。

目前團隊仍會審查每項程式碼修改要求,但工作重點已由逐行閱讀程式碼,轉向檢查修改意圖、架構合理性及潛在影響。

Scion 亦支援按目錄設定程式碼存取權限,配套審查系統可以區分一般註解修改與涉及敏感邏輯的變更,讓人類審查員集中處理風險較高的部分。


Git 會否逐漸退場 Meta 早有 Sapling 但一般開發仍適用 Git

大型科技公司自行開發版本控制系統並非新事。Meta 早在 2022 年已公開介紹 Sapling,用於管理其龐大的 monorepo。Sapling 同樣採用按需要取得程式碼的方式,並提供虛擬檔案系統,減少完整下載大型程式碼庫的需求,其公開客戶端亦可與 Git 儲存庫配合。

Anthropic 這次案例的新變化,是 AI Agent 大幅增加程式碼產出量,令原本主要出現在超大型科技公司的版本控制瓶頸更早浮現。

但 Anthropic 在原文結語特別強調,Scion 並不適合普遍取代 Git。它主要針對數萬名工程師,或大量 AI Agent 同時修改巨型程式碼庫的極端環境。Scion 與 Git 架構差異相當大,企業如要遷移,連程式碼審查、搜尋及 CI 等開發工具亦需要一併更換。

Scion 倚賴持續連線的中央服務,亦意味企業必須考慮伺服器可用性、權限管理及系統依賴。Git 的離線操作及分散式設計,對一般開發團隊仍然有實際價值。

對企業 IT 團隊而言,Anthropic 案例反映 AI 導入後的新問題:當寫程式不再是最耗時的工作,程式碼管理、測試速度、審查能力及部署流程便可能成為下一個限制。企業未必需要立即放棄 Git,但如果計劃大量引入自主編程 Agent,原有開發基建的承載能力亦需要重新評估。

資料來源:
Anthropic Engineering
Meta Engineering

閱讀文章
IT 基建資訊保安雲端服務

Broadcom 推 VMware HyperArmor 應對月度修補 ESX 多重認證須另付費

VMware HyperArmor 提供多層防禦以保護ESX免受最新AI攻擊威脅.

Broadcom 宣布推出 VMware HyperArmor,為 VMware Cloud Foundation(VCF)增加虛擬修補、主機程式執行限制及 SSH 多重認證功能,協助企業在測試及部署安全更新期間抵禦攻擊。隨著 VCF 9.1 引入每月 Express Patch 更新機制,企業需要更頻密處理漏洞修補,但 HyperArmor 屬額外付費產品,並未包含在基本 VCF 授權內。


VCF 9.1 改用每月 Express Patch 減輕更新停機影響

Broadcom VMware Cloud Foundation 產品營銷副總裁 Prashanth Shenoy 表示,AI 工具協助發現的軟件漏洞愈來愈多,促使 VMware 加快更新頻率。企業雖然需要盡快修補漏洞,但正式部署前仍須測試更新是否影響現有系統,令 IT 團隊承受更大維運壓力。

VMware 早前公布,VCF 9.1 採用每月發布 Express Patch 的機制,針對重大安全漏洞及軟件缺陷提供更新,管理員可經 VCF Operations 下載及部署,毋須每次等待整套系統的大型版本更新。

更新機制亦加入減少停機的技術,包括可在符合條件下毋須重新啟動主機的 ESX Live Patching,以及縮短 vCenter 更新停機時間的 Quick Patching。不過並非所有更新都適用於 Live Patching,涉及主要版本或驅動程式修改的更新,仍可能需要傳統維護模式。

HyperArmor 虛擬修補先阻擋攻擊 毋須等待正式補丁

HyperArmor 主要針對 VMware ESX 虛擬化管理層,支援 ESX 8.x 及其後版本,提供 3 項防護能力。

首先是虛擬修補(Virtual Patching)。當系統存在已知漏洞,但正式修補程式尚未安裝時,HyperArmor 可以偵測及阻擋利用漏洞的惡意操作,無須立即重新啟動主機或升級軟件。這讓管理員有時間完成相容性測試,但底層漏洞仍然存在,最終仍須安裝正式安全更新。

其次是 Positive Host Security Guardrails。系統會盤點 ESX 主機現有的程式及指令碼,建立獲允許執行的清單,並阻擋未經批准的程式。管理員需要執行新程式時,可以批准並更新相關規則。這項機制可限制攻擊者取得主機權限後執行惡意程式的能力。

第三項功能是直接整合至 ESX SSH 登入程序的多重認證(MFA)。管理員除輸入 SSH 憑證,還須提供與另一身份連結的限時一次性驗證碼,降低高權限帳戶憑證被盜用後,攻擊者直接取得主機命令列存取權限的風險。

Broadcom 表示,HyperArmor 在主機層運作,不需要在每部客戶虛擬機器內安裝額外代理程式。

SSH 多重認證納入付費產品 企業需另計授權成本

HyperArmor 將作為 VCF 的可選購附加產品銷售,意味著企業若希望使用上述主機層防護,包括內建 SSH 多重認證,需要額外購買服務。

VCF 本身已提供集中身份管理、資料加密及 Live Patching 等基本安全能力。HyperArmor 新增的則是主機程式執行控制、虛擬修補及 SSH 多重認證,企業需要分清兩者的功能及授權範圍。

據 TechTarget 報道,HyperFrame Research 分析師 Stephanie Walter 質疑,特權管理員使用的 MFA 是否應該列為額外收費功能。Broadcom 回應指,HyperArmor 針對需要更高安全保護的環境,並非所有 VCF 客戶都需要這套額外防護,因此採用選購模式。

Broadcom 尚未公開 HyperArmor 的具體售價。TechTarget 引述產品資訊指出,HyperArmor 預計於 Broadcom 2027 財政年度首季交付,該財政年度將於 2026 年 11 月開始。

虛擬修補不等於漏洞已解決 企業仍須維持更新測試

HyperArmor 可縮短漏洞暴露於攻擊的時間,但不能代替正式修補程序。對管理大量虛擬機器的企業而言,月度更新代表需要更頻密安排測試、變更審批及維護工作。

企業評估 HyperArmor 時,除了額外授權費用,亦須考慮如何將主機執行白名單、SSH 多重認證及漏洞修補紀錄納入現有維運流程。對於需要長時間保持服務運作的環境,虛擬修補可以提供測試緩衝時間,卻不代表系統管理員可以無限期延後正式更新。

資料來源:
Broadcom 官方公告
VMware Cloud Foundation 技術說明
TechTarget
SiliconANGLE

閱讀文章
IT 基建人工智能資訊及通訊科技

Qualcomm 推 AI 原生寬頻架構 Wi-Fi 8 網關支援 20Gbps 及本地 AI

物聯網基礎設施架構圖展示多層級連接與設備整合.

Qualcomm 於 10 月 12 日在 Network X 2026 大會前夕,公布涵蓋 Wi-Fi 8、網絡安全管理、毫米波傳輸及 5G 固定無線接入的 AI 寬頻方案。其中與美國光纖網絡供應商 gFiber 合作的新網關支援對稱 20Gbps 寬頻服務,並能直接在路由器運行 AI 智能體。Qualcomm 同時披露,其 Dragonwing SAM 管理軟件的代理程式已部署於全球超過 1,000 萬部網關,反映相關管理技術已有實際商用基礎。

與 gFiber 合作開發 Wi-Fi 8 網關 本地 AI 處理網絡管理

Qualcomm 與 gFiber(前稱 Google Fiber)及台灣網絡設備製造商 Gemtek 合作開發 gFiber Wi-Fi 8 Premium Gateway,採用 Dragonwing NPro A8 Elite 平台,配備 5 核 CPU、Hexagon NPU 及同步四頻 Wi-Fi 8 系統,可直接在網關執行 AI 推理,減少對雲端處理的依賴。

三家公司展示的應用包括使用自然語言設定家長監控,例如要求路由器暫停指定裝置使用社交媒體至晚上 7 時。用戶亦可透過語音產生訪客 Wi-Fi QR Code,並使用 AI 查詢網絡運作狀態及進行故障診斷。

對電訊商而言,這類功能讓網關具備提供智能家居管理、網絡支援及訂戶增值服務的能力。部分敏感資料可留在本地處理,但不代表所有網絡管理及分析資料均不會傳送至雲端。

值得區分的是,20Gbps 指 gFiber 光纖服務的上下行對稱接入速率,並非單一 Wi-Fi 裝置可達到的無線速度。gFiber 原有的 20 Gig 服務已使用 25G PON 技術及 Wi-Fi 7 路由器,新設備主要升級本地無線連接與 AI 處理能力。

gFiber 表示,現有 20 Gig 客戶將優先使用新網關,待設備完成認證後再全面升級。新網關硬件架構亦預留支援未來 50Gbps 服務的能力,公司計劃於 2027 年春季進行住宅 50G 測試。

Dragonwing SAM 已部署逾千萬部網關 支援跨品牌管理

Qualcomm 同時公布 Dragonwing Security and Management(SAM)智能服務框架,結合設備識別、應用程式流量分類、服務品質分析、網絡安全及雲端智能功能,協助電訊商掌握用戶端網絡狀況。

SAM 的 Device ID 可辨識連接網絡的裝置,Service ID 則用於分析裝置正在使用的應用及服務。當網絡出現異常時,營運和客戶支援人員可利用相關資訊進行故障分析。安全服務則涵蓋惡意軟件、網絡釣魚、勒索軟件及憑證攻擊等威脅偵測與防護能力。

Qualcomm 表示,Dragonwing SAM 代理程式已運行於超過 1,000 萬部網關,當中包括北美、歐洲及拉丁美洲一級電訊商的商業部署。這個數字代表相關代理程式的既有安裝規模,並不等於今次公布的全部新功能都已部署至這些設備。

SAM 採用開放式軟件架構,支援 Qualcomm Dragonwing 平台及第三方晶片,並兼容 RDK-B、prplOS 和 OpenWrt 等網關軟件環境。它可透過原生或容器化方式運行,亦支援第三方軟件供應商整合服務。

這種跨平台設計讓電訊商有機會在現有設備上擴展管理及安全功能,毋須把所有服務綁定於同一款晶片。不過實際可部署的功能,仍取決於原有網關的處理能力、軟件版本及系統整合情況。SAM 同時涉及邊緣和雲端資料處理,電訊商仍須評估資料收集範圍、存取權限及私隱要求。

毫米波傳輸及 FWA 平台 擴展光纖以外的接入方式

Qualcomm 今次亦公布 Dragonwing Point-to-Multi-Point(PtMP)及 Point-to-Point(PtP)平台,兩者均採用授權毫米波頻譜及定製無線電設備。

PtMP 可由單一接入點連接多個用戶端設備,適用於住宅大廈、工業園區及其他需要集中提供寬頻服務的地點。PtP 則在兩個網絡節點之間建立高容量無線連接,可用於基站回程傳輸、建築物互聯或光纖網絡延伸。

兩個平台均採用時分多址(TDMA)排程及多標準訊框同步技術,以支援低延遲傳輸及減少不同系統之間的干擾。Qualcomm 主要將相關方案定位於光纖鋪設成本較高,或需要迅速擴展覆蓋的地區。

另一款 Dragonwing FWA Gen 6 Elite 則採用 Qualcomm X105 5G Modem-RF,整合 5G Advanced、三頻 Wi-Fi 8 及非地面網絡(NTN)功能,供設備製造商開發固定無線接入網關。

平台採用符合 3GPP Release 19 發展方向的架構,配備第五代 Qualcomm 5G AI Processor,可根據無線電訊號及網絡負載變化調整連接策略,包括流量分類、干擾管理及連接恢復。這些功能仍須配合營運商網絡及設備實際支援情況,不能等同現時已可使用完整 6G 或衛星寬頻服務。

四類 AI 寬頻方案的營運用途比較

方案 主要功能 營運商用途
Wi-Fi 8 AI 網關 本地 AI 推理、智能體、四頻 Wi-Fi 8 高速接入及智能訂戶服務
Dragonwing SAM 設備識別、故障分析、網絡安全 網絡管理及增值安全服務
PtMP / PtP 授權毫米波、多點接入及無線回程 擴展覆蓋及基站互聯
FWA Gen 6 Elite 5G Advanced、NTN、三頻 Wi-Fi 8 固定無線寬頻及偏遠地區接入

從電訊商營運角度看,Qualcomm 新方案涉及兩種不同部署方向:利用現有網關的軟件管理能力增加服務,以及透過新一代硬件擴展高速接入和無線覆蓋。

當中 SAM 已具備超過 1,000 萬部設備的代理程式安裝基礎,而 gFiber Wi-Fi 8 網關、FWA Gen 6 Elite 及毫米波平台則處於不同的展示、產品推出或部署準備階段。企業評估時需要分別考慮現有設備兼容性、頻譜與網絡條件,以及 AI 服務所需的持續管理工作,不能直接把硬件支援功能等同營運成本節省。

資料來源:
Qualcomm Network X 2026 官方公告
Qualcomm、gFiber 與 Gemtek 合作公告
Qualcomm Dragonwing SAM 技術說明
Qualcomm Point Access Series 技術說明
Qualcomm FWA Gen 6 Elite 技術說明
gFiber 20 Gig 服務資料

閱讀文章
IT 基建人工智能

NVIDIA 與 Cisco 共研 USFP 光學規格 AI 交換器頻寬密度料增 4 倍

光纖傳輸模組,數據傳輸設備,光學連接器,科技硬件.

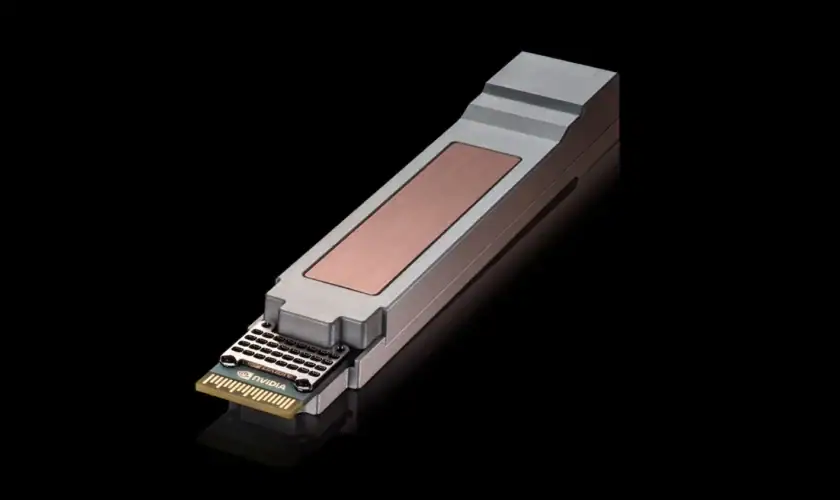
NVIDIA 與 Cisco 於 10 月 12 日宣布合作開發新一代可插拔光學模組規格 USFP(Ultra-Dense Small Form Factor Pluggable),目標是將 AI 數據中心交換器面板的頻寬密度提高至現有方案 4 倍,能源效率提升約 1.3 倍。新規格針對 AI 運算叢集不斷擴大所帶來的網絡擴容、設備密度及耗電問題,讓營運商在有限的交換器及機櫃空間內連接更多運算節點。

兩家公司計劃沿用可插拔光學模組的部署及維修模式,減少企業採用下一代高速網絡時的運作模式改變。不過 USFP 目前仍屬規格開發計劃,尚未公布樣品交付或商業化時間,相關效能亦未有獨立測試結果。

頻寬密度提高 4 倍 減少增加交換器層級的需要

大型 AI 訓練及推理叢集需要大量 GPU、儲存裝置及網絡設備互相傳輸數據。當交換器的連接埠容量不足,營運商可能需要增加交換器及光學連線,令網絡延遲、設備數量、耗電及維護工作一同增加。

USFP 計劃在與現有 OSFP 模組相若的空間內,配置 16 條全雙工通道,每條通道支援 400Gb/s 電訊號傳輸。相較現有每通道 200Gb/s 的設計,USFP 同時增加通道數量及單通道速度,讓單一模組的頻寬密度提高至 4 倍。

按 16 條通道、每條 400Gb/s 計算,單方向容量為 6.4Tb/s。兩家公司聯合新聞稿提及整體容量可達 12.8Tb/s,而 Cisco 技術網誌則將 12.8Tb/s 對應未來擴展至 32 條通道的配置。兩份官方資料的容量口徑尚未完全一致,正式規格仍有待釐清。

NVIDIA 表示新架構可讓交換器連接更多 1.6Tb/s 終端裝置,部分擴容場景毋須額外增加網絡層級。對數據中心營運商而言,若能在現有網絡架構下提高連接密度,將有機會減少額外交換器、光學模組及佈線需求。不過實際節省幅度仍取決於交換器硬件、叢集規模及網絡拓撲,不能直接按 4 倍頻寬密度推算投資回報。

能源效率目標提升 1.3 倍 支援最高 100W 散熱

NVIDIA 與 Cisco 預計 USFP 相較現有每通道 200Gb/s 的可插拔光學模組,能源效率可提升約 1.3 倍。這項數字針對傳輸效率,並不代表整個數據中心耗電量可按相同比例下降。

USFP 採用全新二維陣列連接器及兩階段插入設計,高速接點在模組插入後才接合。廠方表示這可減少接點磨損並改善訊號完整性,亦為未來增加通道數量預留設計空間。

新模組規格可處理最高 100W 的散熱負荷,毋須在收發器內配置獨立專用冷卻迴路。100W 屬於設計散熱能力,並非模組固定功耗。對準備提高交換器連接埠密度的企業而言,仍須在設備選型階段核對實際功耗、機箱散熱能力及機櫃電力預算。

TE Connectivity 及 Amphenol 參與 開放規格仍待落實

USFP 另一項部署考慮是供應商選擇。NVIDIA 與 Cisco 正聯同 TE Connectivity 及 Amphenol 開發相關模組外殼、連接器及光學組件,並計劃透過業界共同參與的多供應商項目制定開放規格。

兩家公司希望保留可插拔模組容易更換、維修及採購的特點,降低企業轉向高密度網絡時對單一供應商的依賴。合作亦延續 NVIDIA Spectrum-X Ethernet 與 Cisco Silicon One 網絡平台的互通工作。

不過,USFP 使用全新連接器,相若 OSFP 的外形尺寸並不代表可以直接插入現有 OSFP 連接埠。企業仍須等待正式規格公布,才能確認電氣介面、交換器相容性、光纖佈線及不同供應商產品的互通能力。

現階段兩家公司未有公布模組售價、送樣時間、實際部署案例或可比較的總持有成本數據。對規劃下一代 AI 網絡的企業而言,USFP 可納入中長期基建技術評估,但尚不足以作為現時設備採購或 ROI 計算的確定依據。

資料來源:NVIDIA、Cisco Newsroom、Cisco 技術網誌、StorageReview

閱讀文章
IT 基建人工智能機械人科技

美國 AI 產業難與中國脫鈎 華郵調查揭模型、機械人及數據中心供應鏈高度依賴中國

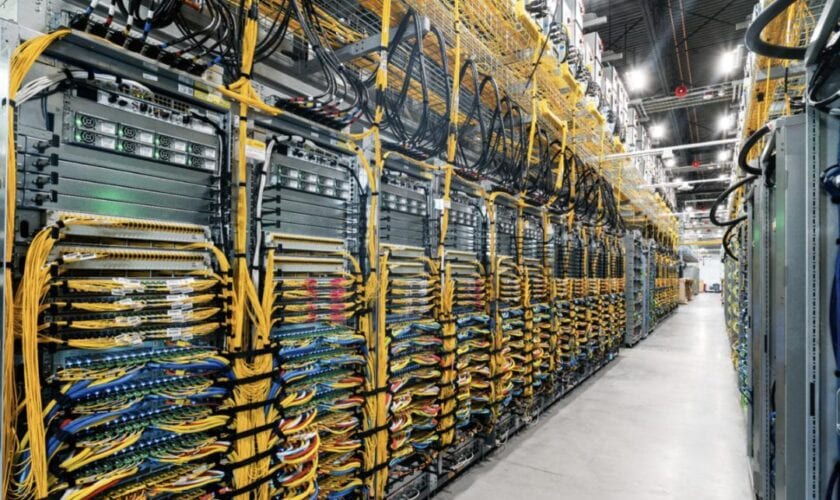
數據中心伺服器機櫃與網絡線纜整齊排列.

美國 AI 產業與中國企業的供應鏈關係,比兩國政府的科技競爭論述更加緊密。《華盛頓郵報》10 月 11 日發表調查,發現美國企業採用中國開放權重 AI 模型,機械人及數據中心亦依賴中國製造零件。摩根士丹利估算,Tesla Optimus Gen 2 若改用非中國供應鏈,物料成本可達中國方案的 2.9 倍,反映企業減少供應鏈依賴可能面對的成本壓力。


中國開放模型吸引美企 低價部署仍要計算算力及治理成本

《華盛頓郵報》指出,DoorDash、Airbnb 等美國企業認為中國 AI 模型已足以處理部分日常業務,毋須所有工作都使用 OpenAI 或 Anthropic 的頂尖閉源模型。月之暗面(Moonshot AI)、DeepSeek 及阿里巴巴等企業提供的開放權重模型,讓企業有機會自行部署及調整模型,減少對單一 API 供應商的依賴。

月之暗面 Kimi K3 是其中一例。該模型於 7 月推出,總參數量達 2.8 兆,採用混合專家(MoE)架構,單次推理約啟用 1,040 億參數,支援最長 100 萬 token 上下文。月之暗面已公開模型權重,企業可按其授權條款使用及部署。

不過開放權重不代表低成本自建。Kimi K3 規模龐大,企業若自行運行,需要評估推理硬件、吞吐量、電力、維運及模型更新等持續開支。採用第三方託管 API 又涉及資料處理方式及供應商管理,兩種部署模式的成本和資料控制程度不能直接畫上等號。

安全治理亦逐漸成為採購考慮。美國 NSA、FBI 及 CISA 於 9 月 8 日聯合指控 DeepSeek、月之暗面、阿里巴巴等 6 家中國 AI 企業,以大規模模型蒸餾方式取得美國模型能力,涉嫌違反服務條款。中國政府否認有關指控。這份通告針對模型蒸餾行為,並非宣布全面禁止企業使用上述模型。

路透社 10 月 9 日另引述 SemiAnalysis 研究指出,在檢視的 857 次中國 AI 模型發佈中,只有 31 次公開模型專屬安全評估,比例約 3.6%。研究衡量的是公開披露情況,未公開評估不代表模型必然不安全,但企業在比較價格及效能時,亦需要取得足夠安全測試資料。

▲ 月之暗面開放權重模型已成為部分企業評估 AI 供應商時的選項。(來源:Yicai Global)

Tesla Optimus 供應鏈成本比較 中國零件價格優勢集中於機械結構

摩根士丹利以 Tesla Optimus Gen 2 為基礎,比較 2025 年採用中國及非中國供應商的物料成本。中國供應鏈方案估算為 45,500 美元(約港幣 35.5 萬元),非中國供應鏈方案則為 131,800 美元(約港幣 102.8 萬元),相差約 2.9 倍。

差異主要集中於執行器及靈巧機械手。中國供應鏈的執行器物料成本估算約 22,000 美元,非中國方案約 58,000 美元;靈巧手則分別約 15,000 美元及 47,000 美元。比較反映中國在精密機械零件生產及供應商網絡方面的成本優勢。

▲ Tesla Optimus 人形機械人於美國加州公開展示。分析機構估算,採用非中國供應鏈可能令 Optimus Gen 2 的物料成本增加至原來約 2.9 倍。圖中機械人不代表成本研究所用的指定配置(圖片來源:Forbes México)

上述數字來自同一年份、同一參考機型的假設性物料清單,並非 Tesla 實際生產成本、最終售價或企業採購報價,亦未包含全部組裝、營運及售後開支。因此不能直接據此推算機械人售價或投資回報。

《華盛頓郵報》亦訪問北京觸覺感測技術企業他山科技。該公司原先從事汽車電子業務,現時開發觸覺晶片及機械人感測器,讓機械手調節握力,執行拿取易碎物件、電子零件裝配及酒店物品遞送等工作。這類針對單一任務的產品,反映中國供應商利用既有製造能力逐步推進機械人商業應用。

▲ 他山科技 TS-R 服務機械人採用觸覺感測技術,能調節抓握及遞送物品時的力度。

美國 AI 基建進口額升 73% 中國光模組成政策焦點

AI 數據中心同樣依賴跨國設備供應鏈。明尼阿波利斯聯邦儲備銀行研究指出,美國 2025 年 AI 相關商品進口額達 3,790 億美元,較 2023 年增加約 73%,涉及伺服器、電力、冷卻及網絡設備等。研究採用較廣泛的商品分類方法,相關總額不能全部視為專供 AI 的設備開支。

研究同時發現,美國直接從中國內地進口的 AI 相關商品佔比持續下降,墨西哥及台灣則各佔約四分之一。進口來源地變化反映供應鏈正在調整,但單憑海關來源地數據,不能確認零件最終原產地或中國零件是否已被完全取代。

中國光模組製造商中際旭創(Zhongji Innolight)是具體例子。光模組負責數據中心伺服器之間的高速光纖傳輸。路透社報道,中際旭創 2026 年首季約 62% 收入來自美國市場,反映美國 AI 基建需求對中國供應商的重要性。

政策限制正在擴大。路透社 8 月報道,特朗普政府正研究限制進口新款中國製數據中心光模組。美國參議員亦於 9 月提出 S. 5548 法案,尋求限制聯邦政府敏感系統採購指定中國光模組;按目前文本,相關禁令若獲通過,將於立法後 5 年生效。

法案現階段仍屬立法建議,不能解讀為美國私人數據中心已全面禁止中國光模組。不過光模組具有可更新韌體及供應鏈追溯等問題,相關政策若日後擴大適用範圍,可能影響企業設備選型、採購合約及長期維護成本。

《華盛頓郵報》引述布魯金斯學會研究員 Kyle Chan 指出,中美 AI 產業已形成大量實際依賴。對需要長期投資模型服務、機械人或數據中心的企業而言,供應來源、替代成本及政策變化,均會影響技術部署與採購安排。

資料來源:
The Washington Post、
J.P. Morgan(引用 Morgan Stanley Research)、
Moonshot AI Kimi K3 Model Card、
Federal Reserve Bank of Minneapolis、
NSA、
Reuters(AI 安全評估)、
Reuters(光模組政策)、
美國國會 S. 5548 法案

閱讀文章
IT 基建人工智能雲端服務

Google AI Pro 訂閱加入 Colab GPU 算力 有用戶獲 A100 80GB 及 200 運算單元

Google AI Pro Colab GPU 訂閱方案,提供 A100 80GB 和多個運算單元選項.

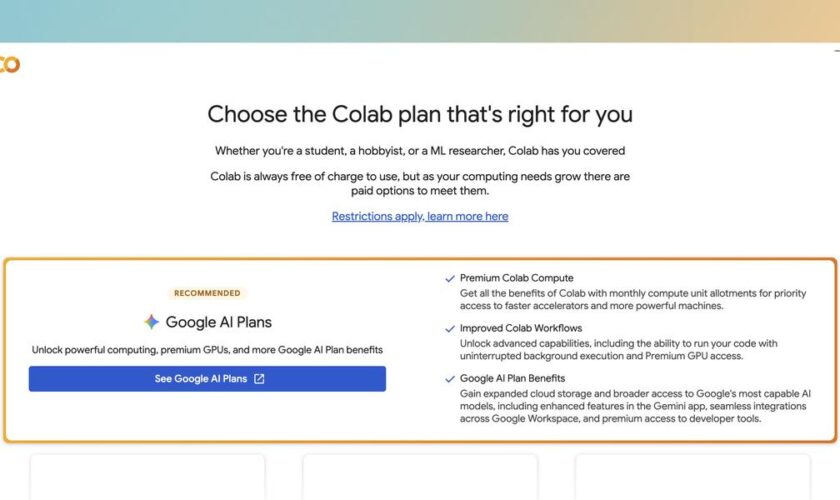
Google 正式將 Colab 進階運算權益納入 Google AI 付費訂閱方案,讓符合資格的 Google AI Pro 用戶在原有 Gemini 等 AI 服務之外,也能使用雲端 GPU 和 TPU 資源進行模型開發及測試。有用戶表示帳戶獲得 200 個 Compute Units,並成功使用 NVIDIA A100 80GB GPU,但 Google 未保證所有訂閱戶均可取得相同配額或硬件。

9 月起分階段推出 原有訂戶毋須額外購買 Colab

Google 早於 9 月 22 日宣布整合安排,並表示相關權益將於隨後數星期逐步向 Colab 支援地區的 Google AI 訂閱戶開放。

根據官方說明,符合資格的 Google AI 付費方案將獲得每月 Colab 運算單元,以及優先存取較高效能 GPU 和 TPU 的權益。用戶毋須另外訂閱 Colab Pro,相關權益會自動套用至同一 Google 帳戶。

Google AI Ultra 訂閱戶則有額外權益,包括 Premium GPU 存取及背景執行功能,讓長時間訓練工作可在關閉瀏覽器分頁後繼續運行。

現有 Colab Pro 或 Pro+ 訂閱亦不受影響。用戶可以同時持有 Google AI 與 Colab 訂閱,兩個方案的運算單元將計入同一帳戶餘額。

有用戶獲 A100 80GB GPU 型號及運算時數沒有保證

社交平台近日有用戶分享,Google AI Pro 帳戶獲得 200 個 Compute Units,並能連接配備 80GB 顯示記憶體的 NVIDIA A100 GPU。對於需要執行大型 AI 模型的開發者,這類硬件可用於模型推論、量化測試及 LoRA 微調等實驗。

A100 80GB 的主要優勢是較大的 GPU 記憶體容量,容許開發者載入較大型的模型權重,或在訓練時容納更多中間運算資料。實際可執行的模型規模,仍取決於模型架構、權重量化方式、上下文長度及訓練設定。

不過 Google 官方公告沒有承諾 Google AI Pro 固定提供 A100 80GB,也未在相關公告列明所有 Pro 帳戶均可獲得 200 個 Compute Units。官方 FAQ 明確指出,Colab 會動態調整可用 GPU 型號、用量限制及硬件供應,即使是付費用戶,也不能保證隨時取得指定 GPU。

Compute Units 亦並非固定運算時數。不同 GPU 及運行配置的消耗速度可以不同,運算單元耗盡後,帳戶便須遵守免費方案的相關限制,或另行購買額度。

降低模型實驗門檻 企業正式部署仍須另作規劃

這項整合讓已訂閱 Google AI 的開發者,可以利用現有訂閱進行更多 AI 模型實驗。對需要評估 Gemma 等開放權重模型的技術團隊而言,Colab 可用於初步驗證模型能否運行、比較量化配置,以及測試微調流程,減少為短期實驗而額外準備高階 GPU 硬件的需要。

不過 Colab 本身屬於共享雲端運算環境,執行階段有生命週期限制,GPU 供應亦會隨時變化。因此這項新權益較適合開發、學習及概念驗證,企業不能單憑 Google AI Pro 訂閱便假設取得具備固定硬件規格及可用性保證的生產環境。

Google 官方指出,需要保證資源的用戶可考慮 Colab Enterprise 或其他受控雲端運算部署方式。


如何檢查帳戶是否取得新權益

已訂閱 Google AI Pro 的用戶可以使用同一 Google 帳戶登入 Colab,進入「設定」中的「訂閱」頁面,檢查目前已啟用的訂閱及運算單元餘額。

用戶亦可在筆記本的執行階段設定中查看可選用的硬件加速器。能否選擇特定 GPU,取決於帳戶權益及當時資源供應。

Google 指出,相關權益只適用於符合資格的 Google AI 付費方案,單純訂閱 Google One 儲存空間方案不包括 Colab 進階權益。免費試用期間亦不包括相關福利,須待合資格付費訂閱正式生效。

資料來源:Google Developers Blog、Google Colab 官方 FAQ、Threads 社群帖文

閱讀文章
IT 基建人工智能

施耐德電氣香港創新峰會 2026|施耐德電氣香港創新峰會 2026|AI 節能最快 1 至 2 年回本 太古項目能源成本料降 10% 至 20%

香港創新峰會2026,商務人士在會場前合影.

人工智能熱潮正將企業的基建開支,由單純採購 GPU 延伸至電力、散熱及樓宇配套等實體設施。中電 2026 年上半年向數據中心售電按年增加 11.8%,佔其總售電量達 7.1%。Schneider Electric 指出,企業除了要應付 AI 帶來的高密度用電需求,更重要是先釐清現有設施的能源效益基準,再評估液冷系統、能源管理以至全新配電架構的投資價值。

個別 AI 能源管理項目 1 至 2 年回本

對企業決策層而言,關鍵始終在於投資回報率。Schneider Electric 香港總裁趙啟文在傳媒問答環節表示,不同項目的 ROI 差異可以很大。以一間過往較少進行能源管理的電力公司數據中心為例,引入 AI 驅動軟件後,在較理想情況下約 1 至 2 年即可收回成本;但若企業本身已配備樓宇管理系統(BMS)、數據中心基礎設施管理(DCIM)等系統持續監察及改良,再加入新系統所能帶來的邊際效益便相對有限。

企業評估 AI 能源方案時,除了計算可節省多少成本,更應先建立自身耗能基準(baseline),計算每投入 1 元新增資本還能換取多少能效提升。

AI 機櫃功耗推向 60kW 考驗液冷部署

這項成本與效益的計算正變得日益迫切。趙啟文以搜尋為例指出,相比傳統簡單搜尋,使用生成式 AI 查詢的耗電量「可能高約 10 倍」。他認為當 AI 使用量持續增加,真正需要重新計算的不只是 GPU 成本,而是背後整套供電及散熱基建。他更表示以往約 20kW 已屬高密度機櫃,但如今部署 AI 伺服器,設計可能至少要以 60kW 級處理,部分需求更可推向約 200kW。現有供電及傳統風冷系統未必能直接承受此類負荷,他認為當機櫃功率超過 60kW,液冷技術的重要性會大幅增加。

本港目前已有實際應用案例。Equinix、Dell Technologies 與 Schneider Electric 合作,在 HK1 數據中心部署 direct-to-chip 液冷系統。根據中電能源審計估算,若液冷方案全面推展至整個數據中心,電力使用效率(PUE)可由傳統機房空調(CRAC)的約 1.4 至 1.5 降至 1.2 或以下,每年潛在節電超過 2,000 MWh。相關數據屬全面部署情境下的估算,並非目前試點已實現的節省量。

太古地產能源成本料降 10% 至 20%

除數據中心外,商用物業管理亦直接牽動營運開支。太古地產將能源管理平台部署至香港及內地 5 個物業,涵蓋超過 20,000 個監察點。Schneider Electric 公布的項目預測指出,年度能源成本有望降低 10% 至 20%,並有最多 80% 的問題可遙距處理,除了電費外亦涉及維修及人手效率。

此類物業節能項目的核心在於先將分散的機電設備運作及耗能數據集中,找出異常及能源浪費位置,再評估哪些設備最值得投入資源改造,加入 AI 只是其中一環。Schneider Electric 今次亦展示 AI 驅動平台 EcoStruxure Foresight Operation,可整合能源、電力及樓宇管理數據,官方稱透過即時優化及預測分析,營運效率最高可提升 50%。

科大李兆基商學大樓採 EPC 模式免前期開支

針對企業不願承擔大筆前期資本開支的問題,市場亦出現新的合作機制。香港科技大學李兆基商學大樓採用能源效益合約(Energy Performance Contract, EPC),由 Schneider Electric 與 Veolia 承擔前期投資,科大毋須預先支付建造及設備成本;兩家公司再於 15 年合約期內,以經核實的能源節省收回投資。

這種模式將一次性的固定資產投資,轉化為以未來營運開支節省支付改造成本,對大量仍使用舊設備、但資本預算有限的商業樓宇具有參考價值。

下一代配電架構邁向 800VDC

放眼長遠的 AI 基礎設施演進,企業亦須考量現時規劃的機房能否承受數年後更高密度的運算需求。Schneider Electric 現正針對 400kW 至 1MW 級 AI 機櫃推動 800VDC 架構,把 AC/DC 電源轉換移出 IT rack,以減少電力轉換損耗、銅材使用及佔用空間。

對現有機房而言,能否升級至相關架構,取決於電力容量、空間及冷卻系統;更高密度部署亦可能需要大幅改建。

Schneider Electric 今次香港創新峰會以「驅動香港新時代:能源、AI 與增長」為主題,匯聚逾 800 位政府、商界及創科界人士。除上述 AI 樓宇管理、液冷及 800VDC 外,現場亦展示涵蓋 AC、DC、儲能及 V2G 的電動車充電方案,以及以純空氣及真空開關技術取代 SF₆ 的中壓開關設備。

隨着算力規模持續膨脹,企業的 AI 投資已不再局限於演算法模型與加速晶片本身。現有機房能否承受下一代算力、每度電是否用得有效,以及節省下來的營運成本能否支付改造投資,正逐步成為 AI ROI 的另一半。

資料來源:
FinancialFilings
Schneider Electric HK
Schneider Electric Case Study
InvestHK
Schneider Electric 800VDC


閱讀文章
IT 基建人工智能

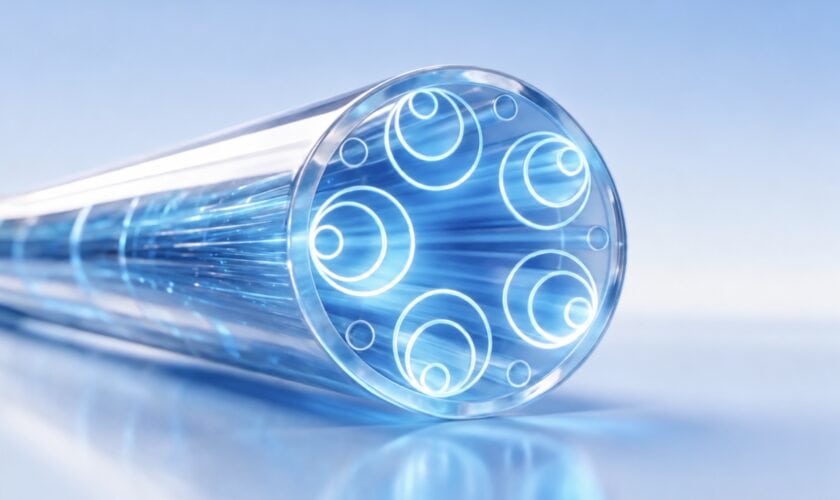
寧夏數據中心採用空芯光纖連接 傳輸損耗與延遲降低逾 30%

透明空芯光纖內部結構,展示多個光纖通道.

中國寧夏回族自治區的 AI 算力需求增長遠超預期,當地已開始在數據中心之間部署空芯光纖,以緩解網絡擠塞問題。據 CGTN 報道,與傳統實心光纖相比,這項新技術能減少逾 30% 傳輸損耗與延遲,目前已用於相距 30 公里的數據中心之間。


運算需求遠超原定規劃

寧夏為中國 8 個國家級算力樞紐之一。China Mobile 寧夏分公司算力網絡規劃專家 Zhou Chongyang 指出,當地僅耗時 1 年,便已完成原定 2026 至 2030 年「十五五」規劃期間全部建設需求。按照最新規劃,寧夏將新建 60 座數據中心,規模達原先預期 3 倍。

隨著進駐企業持續增加,網絡擠塞會拖慢數據傳輸速度,亦會推高 AI 模型訓練的時間與成本。作為核心算力集群,中衞距離中國東部主要需求地區超過 1,000 公里,即使配備頂級光纖,與東部樞紐之間延遲仍達 20 毫秒左右。CGTN 報道指出,對於對延遲敏感的 AI 應用而言,這個速度太慢。

空芯光纖如何提速

空芯光纖直徑不足 0.4 毫米,細得難以拍攝清楚;放大 1,000 倍後,才可見到其中空微結構——管壁內嵌有 20 條極微細玻璃管,藉此為光訊號開闢專用高速通道。CGTN 另一則報道解釋,由於光在空氣中傳播速度快於玻璃,因此空芯光纖具備超低延遲、超低損耗及超大頻寬優勢。

寧夏亦同步推出算力平台,整合零散及閒置運算資源,方便企業客戶更彈性調配算力。

中外業界同步發展

近年海內外業界均積極試用這項前沿技術。據 Light Reading 2025 年 9 月報道,中國電訊商已開始測試及部署空芯光纖。

海外方面,Microsoft 也在 Azure 數據中心網絡發展空芯光纖。Network World 報道指出,Microsoft 研究團隊將空芯光纖傳輸損耗降至每公里 0.091 dB,低於傳統光纖每公里 0.14 dB 的長期限制;Tom’s Hardware 亦引述 Microsoft 研究指出,空芯光纖傳輸速度最高可提升 47%,延遲亦相應降低約 33%。

寧夏數據中心配備空芯光纖,傳輸損耗與延遲顯著降低.

電力供應同步提速

數據中心興建步伐同樣大幅提速。受惠於模組化鋼結構技術,以往需時 18 個月至 2 年的工程,如今最快只需 4.5 至 5 個月即可竣工。但一座新變電站從審批到落成仍需約 18 個月,導致電網擴建進度難以追上數據中心擴張速度。

為了解決供電瓶頸,寧夏將 4 座原定 2028 及 2029 年動工的變電站提前至 2027 年開工。針對新數據中心初期未滿載運行的特性,當地亦推出「分級供電」模式,初期先以較低電壓供電,待用電負載提升後再切換至高電壓。

寧夏近期亦完成大型「綠電直供」項目,透過系統實時預測算力負載及用電需求,並根據風力與太陽能發電波動,動態調度發電與儲能設備。目前寧夏數據中心可再生能源使用比例已達 87.6%,比全國目標高出 7.6 個百分點。

運算、通訊與電力 3 網合一

寧夏正積極探索算力、通訊與電力 3 個行業協同機制,讓跨部門與相關企業能在算力需求爆發之際,更有效統籌規劃基礎建設與能源資源。當地期望藉此建成綠色、安全且高可靠度的國家級算力樞紐,支援全國各地運算需求。

資料來源:CGTN


閱讀文章
IT 基建人工智能企業趨勢

Microsoft 不撤資料中心 推「社區優先」換取 AI 擴張空間

資料中心內部,技術人員巡視伺服器架構,展示高效能數據存儲環境.

Microsoft 明確表態不會停止興建人工智能資料中心,但會以電費保障、節水承諾與在地就業投資,換取社區對大規模擴張的支持,而非在爭議聲中放緩腳步。事件發生在 2026 年 1 月,由 Microsoft 副董事長兼總裁 Brad Smith 主導推出「社區優先 AI 基礎設施」計劃,承諾旗下資料中心不會推高居民電價,並在 2030 年前將用水強度改善 40%。這項政策的背景,是 Microsoft 同期披露更龐大擴張野心。

電費保證背後的產業邏輯

Microsoft 這次承諾的核心,是要求電力公司與州級監管機構為資料中心設定「足額成本」電價,把輸電、變電等新增基建成本全數計入資料中心帳單,避免轉嫁至一般住宅用戶。國際能源署預測,美國資料中心用電量將由目前約 200 太瓦時,於 2035 年增至 640 太瓦時以上,增幅逾三倍,而美國大量輸電設施已運作超過 40 年,新線路由規劃到啟用動輒需時 7 至 10 年,電網老化與 AI 需求爆發形成尖銳矛盾。Microsoft 已在懷俄明州與 Black Hills Energy 合作制定新供電方案,並在威斯康星州支持為「超大型用電戶」設立專屬電價機制;在中西部 MISO 電力市場,公司更已簽署協議推動新增 7.9 吉瓦發電能力併網,規模超過 Microsoft 自身用電量兩倍,試圖藉資料中心擴張連帶提升整個區域的供電能力。

值得留意的是,Microsoft 並非孤例。同業 Amazon 今年 6 月首度公開資料中心用水數據,顯示 2025 年全球取水 25 億加侖,用水效率達每千瓦時 0.12 公升,聲稱較行業平均值 0.84 公升高出七倍,並承諾 2030 年前達成「水資源正效益」,目前已完成 75% 進度。Google 則已在四分之一以上的資料中心改用經處理的工業廢水或市政再生水作冷卻,減少對淡水的依賴。三大科技巨頭不約而同轉向「自付成本、補償社區」的模式,反映 AI 基建擴張已到必須正面回應地方阻力的臨界點。

專家眼中「社區優先」能否奏效

行業分析普遍認為,Microsoft 的承諾雖具誠意,但實行時仍存變數。Data Center Knowledge 報道指出,Microsoft 這套框架將由 2026 年上半年起於美國新設及擴建市場逐步推行,涵蓋電價結構、電網升級、全額繳稅、水資源管理與勞動力培訓五大範疇。與此同時,亞太區房地產顧問公司仲量聯行(JLL)資料中心客戶管理主管 Chris Howard 向《Asian Business Review》表示,AI 伺服器每機架耗電量可達傳統設備的八倍之多,傳統風冷技術已難以應付,這意味即使電價機制透明化,散熱與供水壓力仍會持續攀升,單靠電費補償未必能徹底化解社區疑慮。

另一方面,Microsoft 引用 LinkedIn 數據指出,2025 年全球與資料中心職業相關、或需具備核心資料中心技能的招聘職缺按年增長 23%,美國市場增幅則為 13.5%,反映基建擴張正快速推高技術工人需求。公司因此與北美建築工會聯合會合作擴大學徒培訓,並在弗吉尼亞州博伊德頓與 Southside Virginia Community College 等機構合辦 Datacenter Academy,協助數百名學員取得資訊科技及關鍵設施運營認證;2024 年更於當地開設 Critical Environment Training Lab,以退役設備進行電氣及冷卻系統實操訓練。這種「以就業換支持」的策略,某程度上呼應了本地學者對 AI 基建外部性的擔憂。

一年時間軸見證承諾到擴張並行

回顧時間脈絡,Microsoft 今年 1 月率先公布社區優先框架,承諾電價、節水、就業、稅收與社區投資五大方向;4 月,投資者開始就用水與用電問題向 Amazon、Microsoft 及 Google 施壓,三巨頭均曾因社區反對而放棄過數十億美元級資料中心項目;8 月,Amazon 以德州及路易斯安那州項目為例,公開承諾全額支付能源基建成本並推動水資源正效益;9 月 10 日,彭博社披露 Microsoft 38 吉瓦擴張計劃,顯示承諾與擴張並非互斥,而是同步推進的兩條主線;9 月 14 日,Data Center Knowledge 進一步確認框架將於 2026 年上半年在美國新市場推行。這條時間軸清楚說明,Microsoft 並未因社區壓力放緩基建腳步,反而選擇以更精細的成本分攤機制,爭取繼續擴張的社會許可。

對企業經營者而言,這場角力的啟示在於:AI 基建的競爭門檻已不再單純是資本與晶片供應,而是能否在電力、水資源與地方就業三者之間找到可持續的平衡點。隨著全球資料中心用電量朝向 2026 年突破 1,000 太瓦時邁進,幾乎相當於日本全國用電量,類似 Microsoft 的「社區優先」模式恐怕會成為未來科技巨頭爭取建廠許可的標準配置。


資料來源:

Microsoft On the Issues

Reuters

Data Center Knowledge


閱讀文章