close

應用方案

應用方案科技專欄

智能奧運降臨 雲端與 AI 如何重塑冬季奧運會


智能奧運降臨 雲端與 AI 如何重塑冬季奧運會▲即時 360 度回放系統,細膩呈現運動員動作細節


三千多年來,奧林匹克運動會一直是人類展示雄心壯志的舞台——不僅在運動場上,更在於捕捉、測量和分享精彩時刻的工具上。2026 年米蘭科爾蒂納丹佩佐冬季奧運會標誌着一個轉捩點:「智能奧運」的降臨,雲計算與 AI 不再只是隱藏的基礎設施,而是奧運故事的主角。

這一轉變的核心,在於從被動觀看轉為由 AI 驅動的主動參與。由阿里巴巴 Qwen 大語言模型驅動的「奧運 AI 助手」為奧運史上首次使用大語言模型技術。觀眾只需以自然語言提問搜索,即可獲得答案。雲端與 AI 正被用來「翻譯」奧運會,讓更多人能夠在這個故事中找到自己的身影。

讓冬季運動煥發活力

在捕捉運動表現方面, 升級後的即時 360 度回放系統在 15 至 20 秒內將運動員動作重構為三維影像,支持 17 個項目的賽事直播。「時空切片」(Spacetime Slices)功能將動作的多個階段疊加成單一合成影像,讓觀眾看清以往只有教練才能察覺的細節。

在幕後,由Qwen驅動的自動媒體描述(AMD)系統,能自動識別運動員、辨認關鍵時刻、並實時生成賽事描述及為素材添加標籤。從前需要由多支編輯團隊耗時處理的工作,如今數秒內即可完成。

邁向可持續智能之路

智能奧運亦重塑了主辦單位管理幕後的營運方式。阿里雲升級版能源數據管理系統讓主辦單位能夠即時監察競賽場館的能源使用量和碳排放量。當出現用電量突然飆升時,工作人員可向由Qwen驅動的可持續發展聊天機器人提問獲得精確且數據化的答案。該平台還全面掌握奧運會整個生命週期的環境足跡。

重新詮釋奧運傳統

即便是奧運會最珍視的傳統儀式,也正透過 AI 悄然蛻變。在米蘭奧運選手村,「智能徽章交換站」邀請運動員通過語音或手勢操控機械臂,選取其他運動員留下的徽章。位於米蘭斯福爾扎城堡的「阿里巴巴米蘭-阿里廊」活動,互動裝置依託雲端 AI 驅動能回應參觀者的動作。在洛桑奧林匹克博物館,個人化 AI 語音導覽能根據每位參觀者的興趣調整內容。在每一個案例中,雲端與AI都在背後默默打造個人化體驗,讓這屆奧運會更像是屬於他們的奧運會。

勾勒未來賽事藍圖

2026年米蘭科爾蒂納冬奧會所展現的是,經過精心部署的雲端與AI可以為大型賽事建立全新的互動架構。此架構具有三大關鍵特徵:對話性質,互動界面漸漸趨向於人類的自然語言;適應性,AI系統都能回應當下發生的狀況;包容性,多語言支援、客製化博物館導覽和無障礙的數碼體驗讓更多人感到受邀進入奧運故事。

這些特質並非體育賽事所獨有。支撐智能奧運的雲端與 AI 技術棧,同樣可以應用於世界博覽會、全球峰會、大型節慶活動,這些場合的主辦單位面對着相似的挑戰:多元受眾、複雜營運,以及對成本和碳排放的嚴格審查。

阿里雲在 2026 年米蘭科爾蒂納冬奧會中的角色,並非炫技,而是將智能科技無縫編進賽事肌理,成為奧林匹克精神的自然延伸。無論是自由式滑雪選手透過與機械臂互動獲得了一枚稀有徽章,義工在問題浮現前解決能源故障,或是身處不同時區的觀眾以母語接收即時賽事更新:每個微小時刻,共同昭示着奧運會可以展現的嶄新面貌。


資料由客戶提供
閱讀文章
人工智能應用方案資訊保安

Claude Fable 5.2、Mythos 5.2 開發者懶人包 API 減價 20% 升級須注意四項變更

Claude Fable 5.2 與 Mythos 5.2 專題報導.

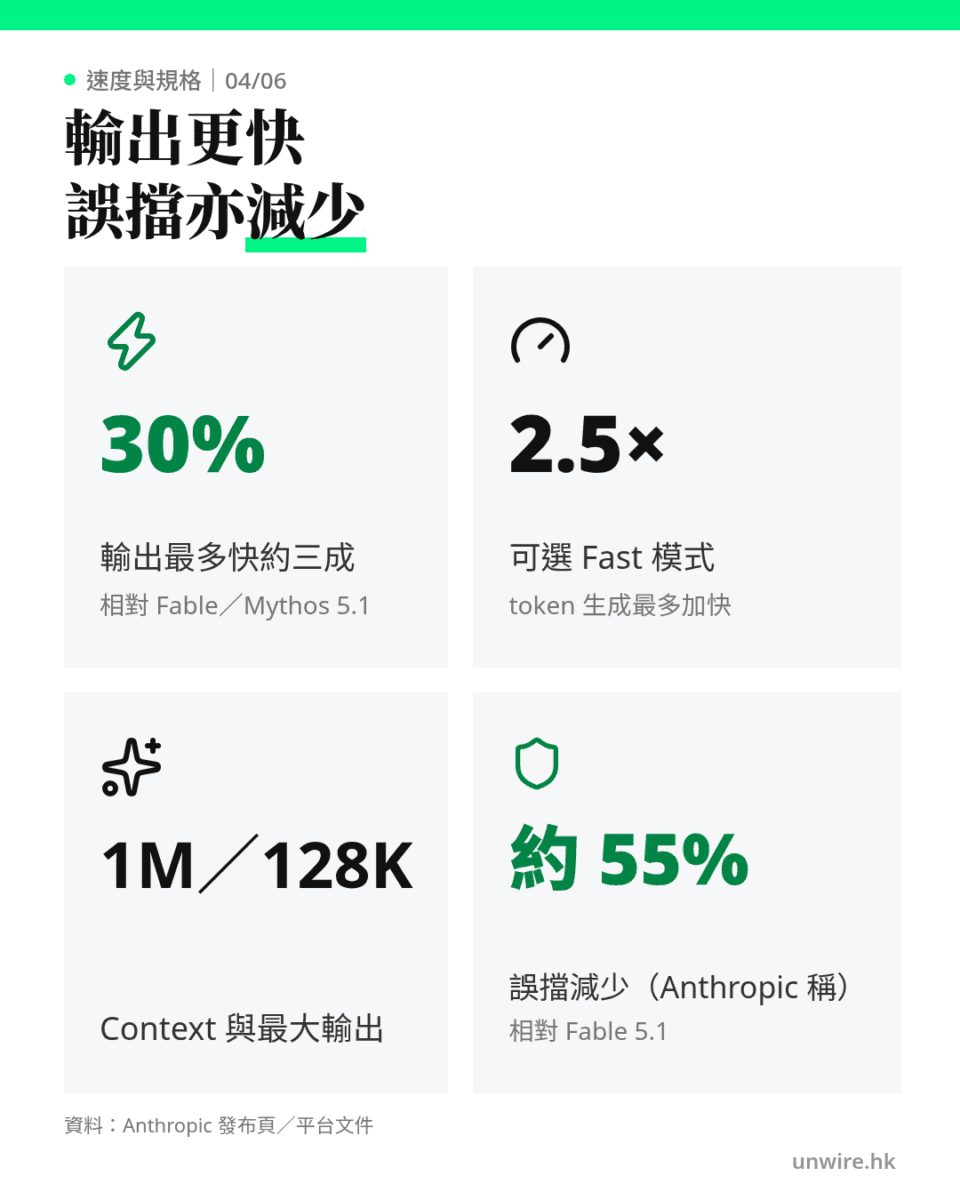
Anthropic 於 11 月 9 日推出 Claude Fable 5.2 及 Claude Mythos 5.2,兩款模型主攻複雜程式開發和長時間 AI Agent 任務,支援 100 萬 tokens 上下文與最多 128K tokens 輸出。根據官方開發者文件,Fable 5.2 的 API 輸入及輸出價格較上一代下調 20%,但開發者升級時須留意 Thinking Blocks、Computer Use、Advisor 及資料保留要求,部分舊程式可能出現 HTTP 400 錯誤。

Fable 5.2 開放所有 Claude API 客戶 Mythos 5.2 需要資格審核

Claude Fable 5.2 與 Claude Mythos 5.2 使用相同底層模型,主要分別是安全防護及使用資格。Fable 5.2 已向所有 Claude API 客戶開放,適用於大型程式庫修改、長時間 Agent 工作流程,以及需要多步驟推理與大量工具呼叫的技術任務。

Mythos 5.2 則面向經 Anthropic 審核的專業機構,例如通過 Cyber Verification Program 的網絡安全團隊,以及符合相關生命科學驗證要求的研究團隊。兩者的規格和 API 收費相同;Mythos 並非效能更高的獨立模型,一般開發者毋須為日常 Coding 工作申請 Mythos。

100 萬 tokens 上下文及 128K 輸出 API 收費較 5.1 低 20%

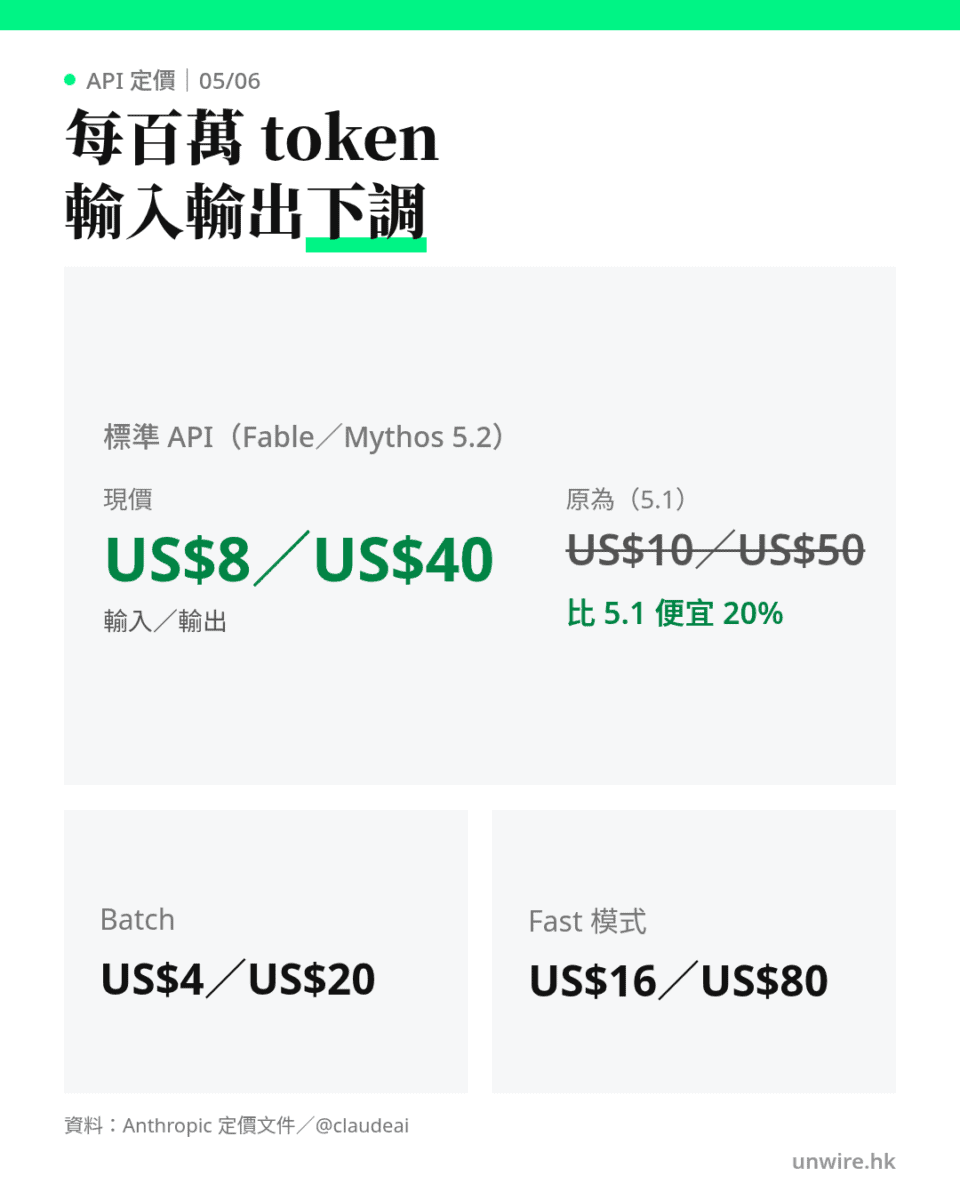
Claude Fable 5.2 的 Context Window 為 100 萬 tokens,單次請求最多輸出 128,000 tokens。標準 API 收費為每百萬輸入 tokens US$8、每百萬輸出 tokens US$40,分別低於 Fable 5.1 的 US$10 和 US$50。不過,Fable 5.2 的標準輸入、輸出單價仍是 Opus 5.5 的兩倍。

Claude API 收費比較,單位為每百萬 tokens、美元
模型/模式 輸入 輸出
Fable 5.1 標準 US$10 US$50
Fable 5.2 標準 US$8 US$40
Fable 5.2 Fast Mode US$16 US$80
Opus 5.5 標準 US$4 US$20

Fable 5.2 的 5 分鐘 Prompt Cache 寫入費用為每百萬 tokens US$10,1 小時寫入為 US$16,Cache Read 為 US$0.20。Batch API 標準輸入及輸出收費減半,分別為 US$4 和 US$20;工具及其他託管服務可能另外收費。

Fast Mode 可將每秒輸出的 tokens 數量提升最多 2.5 倍,但輸入及輸出單價亦增加一倍。開發者在支援的平台透過 Messages API 設定 speed="fast" 即可啟用,毋須附加 Beta Header。速度數字只指 token 生成速率,不代表整項 Agent 任務完成時間必然縮短 2.5 倍。

Python API 怎樣開始使用 Fable 5.2?

Claude Fable 5.2 的模型 ID 為 claude-fable-5-2。開發者安裝 Anthropic Python SDK 並設定 ANTHROPIC_API_KEY 環境變數後,可沿用 Messages API。以下程式透過 output_config.effort 設定推理強度,並按內容類型讀取文字輸出。

import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-fable-5-2",
    max_tokens=16384,
    output_config={"effort": "high"},
    messages=[{
        "role": "user",
        "content": "Review this Python service architecture."
    }]
)

for block in response.content:
    if block.type == "text":
        print(block.text)

Fable 5.2 使用不能關閉的 Adaptive Thinking。開發者可選 low、medium、high、xhigh 及 max 五個 Effort 等級,預設為 high。Anthropic 建議從 high 開始測試,只在實際工作證明有改善時才使用 xhigh 或 max。由於 max_tokens 同時限制思考及文字輸出,複雜任務應預留足夠空間。

舊程式若使用手動 budget_tokens、thinking: {"type": "disabled"} 或強制工具呼叫的 tool_choice 類型 any、tool,須按官方指引修改。舊式 Assistant Prefill 及部分 Sampling Parameters 同樣不適用,否則可能收到 HTTP 400 錯誤。

升級 Fable 5.2 有四項 Breaking Changes Agent 程式可能出現 HTTP 400

Anthropic 在 Migration Guide 列出四項可破壞現有程式的變更,特別影響自行管理對話歷史、切換模型或使用 Computer Use 的 Agent 系統。

Fable 5.2 的四項主要升級相容性變更
項目 開發者應檢查的設定
Thinking Blocks 所有帳戶均會驗證先前的 System Prompt、Tools 及對話內容是否被修改;自行管理訊息歷史時應保持只追加,避免先前推理區塊失效。
模型切換 Fable 5.2 與 Mythos 5.2 可讀取彼此的 Thinking Blocks,但 Opus 5.5 等舊模型不能讀取 5.2 產生的推理區塊。切回舊模型時,API 會捨棄不相容區塊。
Computer Use 舊工具 computer_20251124 會導致 HTTP 400,須改用 computer_toolset_20260801 並更新工具執行循環。
Advisor Tool Fable 5.2 作為 Executor 時,Advisor 只可使用 Fable 5.2 或 Mythos 5.2,不能沿用舊 Advisor 模型。

Thinking Blocks 相容性有方向之分:在 Claude API 等支援平台上,Fable 5.2 可以讀取 Opus 5.5 產生的 Thinking Blocks,但 Opus 5.5 無法反過來讀取 Fable 5.2 的區塊。對於 Model Router 或 Fallback 系統,切換即使成功,也可能因缺少先前推理脈絡而增加下一次回應的延遲及 Token 消耗。

Fable 5.2 的安全分類器亦可能傳回 HTTP 200,同時在 stop_reason 標示 refusal。開發者須檢查 stop_details,不能只以 HTTP 狀態碼判斷任務完成。長時間 Agent 亦應監控是否提前停止及產生過多 Subagents。

企業部署須保留資料 30 日 ZDR 安排需另行確認

Claude Fable 5.2 和 Mythos 5.2 均要求 30 日資料保留,作安全監察用途。除非取得 Anthropic 明確授權,否則不能直接在 Zero Data Retention(ZDR,零資料保留)安排下使用。企業若現時以 ZDR 使用其他 Claude 模型,改用 Fable 5.2 前應核對合約、Workspace 設定與資料治理政策,否則 API 請求可能收到 invalid_request_error。

選用 Google Cloud 等第三方託管平台時,亦須查核適用地區、模型可用性和相關資料保留條款,不能單憑既有雲端部署安排推定 ZDR 或資料主權承諾不變。

一般工作先由 Opus 5.5 開始 大型 Agent 再測試 Fable 5.2

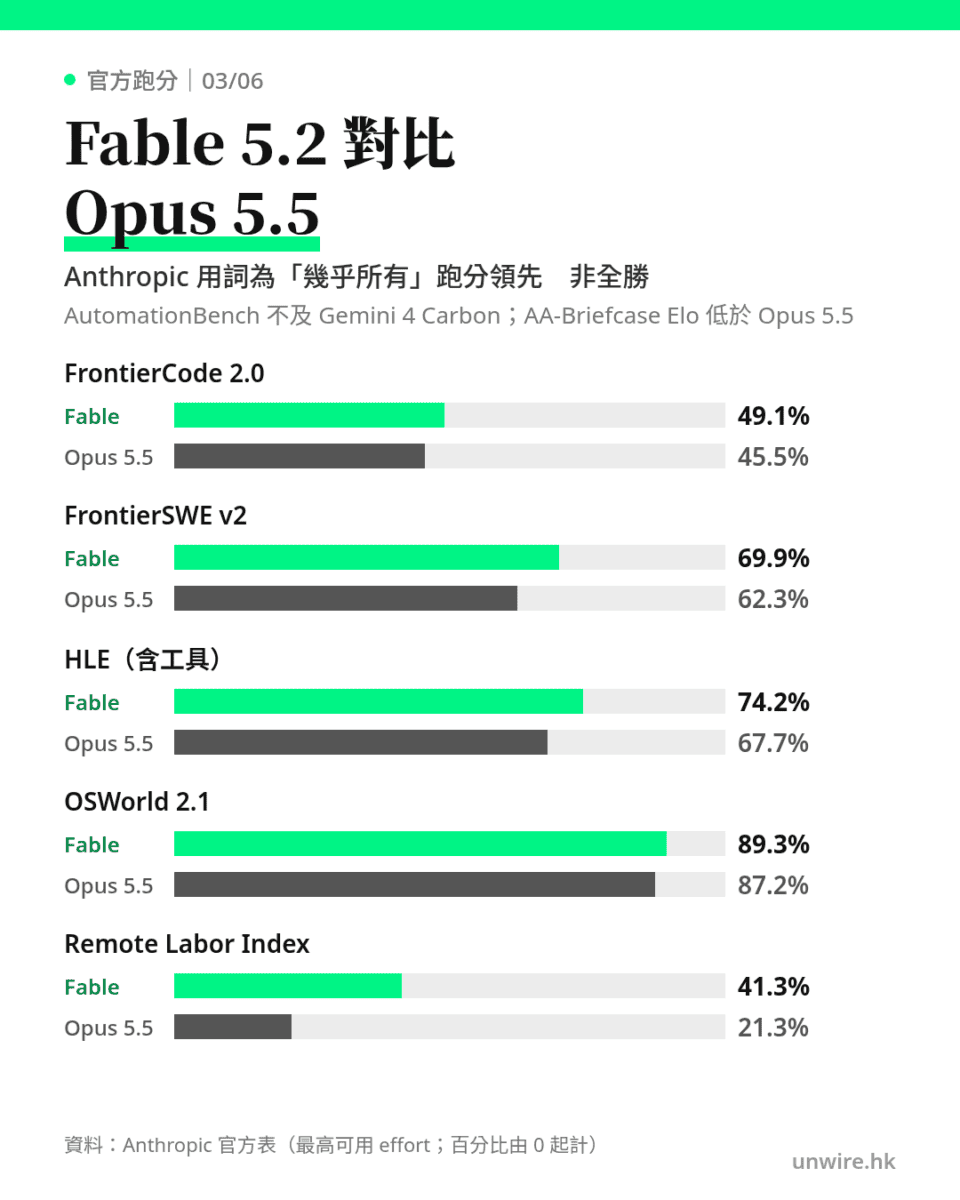
Anthropic 在開發者文件建議,一般工作先從最新 Opus 模型開始,只有在提高推理強度後仍未達到要求,才考慮 Fable 5.2。新模型針對大型程式修改、跨檔案工程、長時間自主研究及複雜多步驟 Agent 工作,但每百萬 tokens 單價較 Opus 5.5 高。

正式升級前,開發團隊應在相同測試資料和工具設定下比較完整任務成功率、總 tokens 消耗、Subagents 成本、端到端延遲及人工覆核時間。官方 Benchmark 或單次輸出速度不能直接換算企業投資回報;涉及生產系統修改的 Agent,應先驗證工具權限、回退機制和人工審批流程。

資料來源:Anthropic API Release Notes、Fable 5.2 官方規格、新增功能及限制、升級指南、Prompting Guide

閱讀文章
人工智能企業趨勢應用方案

Grok API 11 月起預設加浮水印 關閉須確認法律例外並自負披露責任

資料中心伺服器機櫃與透明平板顯示裝置,走道兩側裝有藍綠燈效的伺服器機櫃.

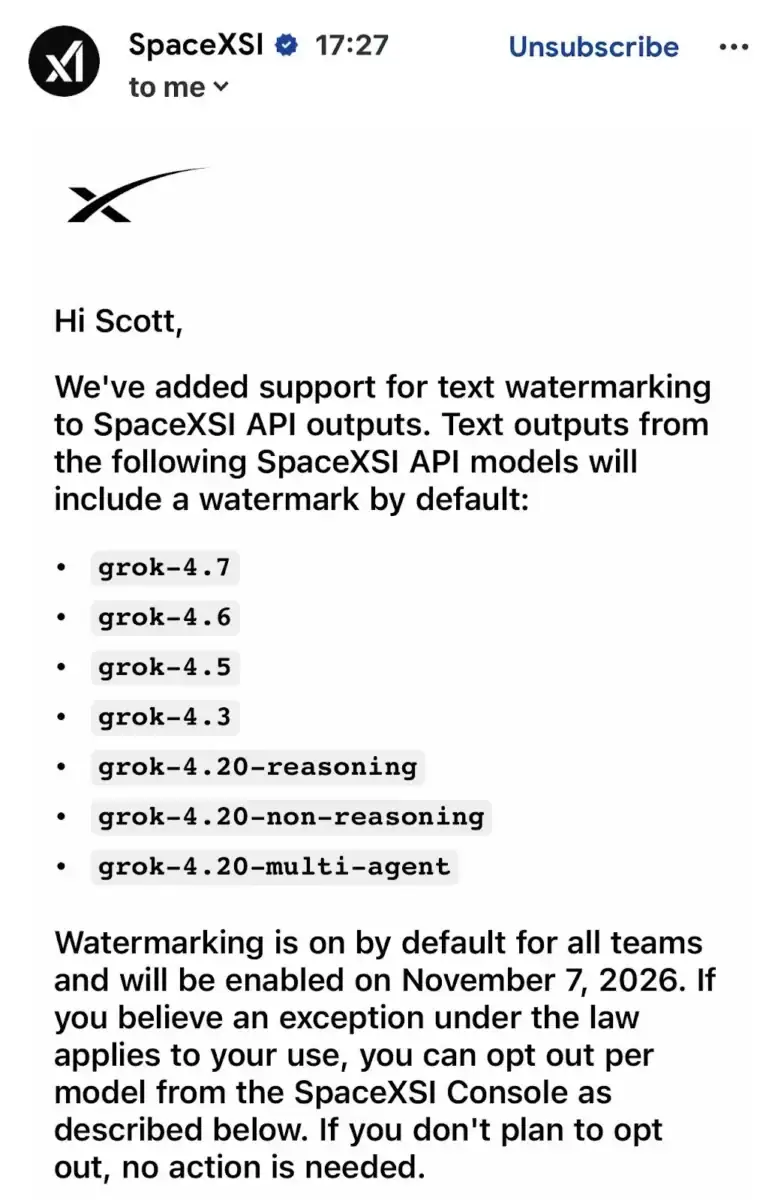
Grok API 將由 2026 年 11 月 7 日起,為 7 款模型的文字輸出預設加入肉眼看不到的統計式浮水印。提供 Grok API 的 SpaceXSI 表示,這是為了符合歐盟《人工智能法》(EU AI Act)。開發者毋須為啟用功能修改程式碼,但要查閱回應的 x-watermark header,才知道該次輸出有否帶浮水印;團隊管理員如要按模型關閉,則須確認用途屬適用法律下的例外,並自行承擔標記及披露責任。同時使用多個模型的團隊,要把每次輸出的浮水印狀態納入日誌管理。

Grok API 浮水印涵蓋 7 款模型及所有 endpoint

Grok API 的預設浮水印涵蓋 grok-4.7、grok-4.6、grok-4.5、grok-4.3,以及 grok-4.20 的 reasoning、non-reasoning 和 multi-agent 版本,共 7 款模型。

SpaceXSI 電郵截圖,列出 grok-4.7 至 grok-4.20 多款模型,並說明浮水印預設啟用
SpaceXSI 通知電郵指出,多款 Grok API 模型的文字輸出將預設加入浮水印

功能適用於所有文字生成 API,包括 Responses API 和 Chat Completions API;一般文字回應、結構化輸出及工具呼叫參數均在範圍內。全球 endpoint api.x.ai 和各區域 endpoint 都會套用,選擇區域 endpoint 不能避開預設設定。有報道指改動只限 API,不影響面向消費者的 Grok 產品。

Grok 統計式浮水印:不加字元,偵測要申請

Grok 的統計式浮水印在模型生成文字時,輕微影響模型選取 token 的方式,不會在輸出加入字元、標記或隱藏文字。SpaceXSI 聲稱,浮水印不影響回應質素或速度。

偵測同樣採用統計方法,結果分為有浮水印、無浮水印或不確定;文字愈長訊號愈強。使用偵測 API 要先申請。由於浮水印不加入字元,而回應格式除新增 header 外不變,現有解析結構化輸出的流程應不受格式變動影響。

開發者毋須在 request 加入參數。回應的 x-watermark header 值為 true,代表該次輸出有浮水印;其他值或沒有該 header,則代表沒有。這個 header 顯示的是該次 request 的狀態,與另行偵測一段文字是兩種不同的查證方式。

Grok 浮水印 opt-out:責任轉到用戶身上

Grok 團隊管理員可在 SpaceXSI Console 關閉部分或全部模型的浮水印,設定適用於團隊所有 API key,變更會在 5 分鐘內對新 request 生效;部分模型則可能對個別團隊鎖定開啟,不能在 Console 關閉。

關閉時,管理員須確認有關用途符合適用法律下的例外,並自行承擔標記、披露及其他法律要求的責任。SpaceXSI 文件沒有解釋哪些用途屬例外,也沒有指明浮水印對應的法例條文。每次開啟或關閉都會記入團隊 audit log,管理員可按事件 ID、描述、用戶及時間搜尋。

歐盟《人工智能法》第 50 條的透明度義務已於 2026 年 8 月 2 日生效。據 euronews 報道,違反相關歐盟法規最高可罰 1,500 萬歐元(約港幣 1.31 億元)或全球年營業額的 3%,以較高者為準。

Anthropic Claude 浮水印全球適用,雲端平台亦帶標記

Anthropic 早前亦為符合歐盟《人工智能法》,在支援的 Claude 模型文字輸出加入肉眼看不到的浮水印。標記全球適用,涵蓋 Claude Platform(API)、Claude、Claude Code 等產品,經 AWS、Google Cloud 或 Microsoft Foundry 使用支援模型時亦會帶有浮水印。

2026 年 8 月 2 日或之後推出的 Claude 模型推出時已支援浮水印,舊模型則陸續加入;偵測功能仍屬 private preview(私人預覽),只開放予合資格機構及同樣有合規查證責任的企業。Anthropic 表示,其文字浮水印不含識別資料,不能追溯至特定人士、機構或對話,偵測只能判斷文字有多大可能部分由 Claude 撰寫。

多模型架構要保留 x-watermark 狀態作合規紀錄

多模型團隊若要追查 Grok 輸出有否浮水印,應先確認應用程式能否接收到 x-watermark header。開源專案 ReqLLM 在 GitHub issue 指出,其現有 SDK 轉換非串流的 Grok API 回應時會丟棄該 header,並建議公開這個值,供應用程式作審計、政策或合規紀錄。

使用 SDK、AI gateway 或其他中介層的團隊,可以檢查元件會否保留 header,並在日誌記錄每次 request 的浮水印狀態。若要 opt-out,法務或合規人員應先確認例外理據,再由管理員更改設定;Console 的 audit log 可作內部稽核證據。

服務歐盟市場或客戶的企業可能受歐盟《人工智能法》約束,在同一流程使用不同模型時,可分別記錄各模型的標記狀態及設定,避免日後需要查證輸出時,才發現狀態沒有留下紀錄。

來源:SpaceXSI Docs

閱讀文章
人工智能企業趨勢應用方案

解決企業 AI 總停留試驗階段 Wonderful 趙翔:重設流程與治理比模型更重要

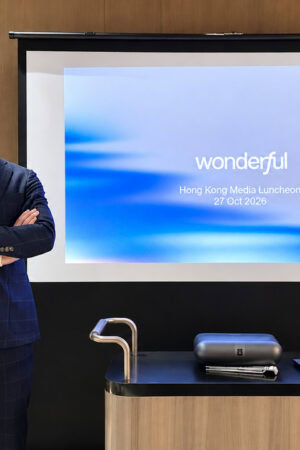
商務專業人士在演講廳前自信站立,背景為投影幕與企業簡報.

企業紛紛投入人工智能(AI),但真正將 AI Agent 用於日常營運的企業仍屬少數。Wonderful 大中華區總經理趙翔(Mirko)在傳媒分享會上表示,超過 88% 企業已嘗試使用 AI,但不少項目仍停留在概念驗證(PoC)、內部示範或試點(Pilot)階段。他估計香港約 70% 企業處於這種狀態,只有約 5% 至 10% 由管理層帶頭推動全面轉型。他認為,企業要走出試驗階段,必須重新設計業務流程,並建立足以支援正式營運的治理機制,模型能力反而並非最大障礙。

他更觀察到企業對 AI 大致有三種取態:全力推動轉型、作中度投資,以及表明自己並非 AI 公司、只為員工提供 AI 助手。企業先確定自己屬於哪一類,才能決定投資規模及推行速度。

三大陷阱令企業 AI 難以落地

各部門獨立採購是常見問題。例如人力資源與客戶服務部門分別引入 AI,系統卻互不相通,流程在部門交接時中斷,日後還需要投入額外資源整合。

另一問題是直接將現有標準作業程序(SOP)交給 AI 執行,卻沒有檢視流程是否仍然合理。趙翔建議管理層思考,假如今天重新建立一間公司,會如何利用 AI 設計工作流程。

企業亦容易低估部署難度。部分公司花費大量資金聘請顧問制訂策略,卻缺乏工程團隊執行,甚至無法判斷方案是否可行。管理層需要評估內部是否具備將 AI 投入正式營運的能力。


AI Agent 價值在於串連完整業務流程

趙翔以模擬銀行貸款申請示範 AI Agent 如何分工處理整個流程。

客戶提交申請後,系統可自動核對資料、檢查文件,發現身份證明文件缺漏時,再由語音 Agent 致電客戶補交。示範中,客戶要求在文件不足的情況下批准貸款,並追問優惠,AI 均沒有越權答應。

對銀行、保險等受監管行業來說,評估 AI 時除了測試對話是否流暢,更重要的是確認它能否遵守業務規則及操作權限。

另一項能力是操作舊系統。部分銀行核心系統缺乏 API,AI Agent 可辨識畫面、操作滑鼠及輸入資料,職員亦能隨時接管。相比依靠固定操作步驟的傳統機械人流程自動化(RPA),這類工具更具彈性,但企業必須預先界定權限、審計要求及出錯責任。

上述示範在模擬環境進行,實際成效仍取決於企業自身系統的整合程度。

AI 治理必須在正式部署前建立

趙翔指出,企業由內部示範轉向正式部署時,往往才發現缺乏權限管理、安全控制及審計機制。

企業應要求系統記錄每次互動,包括底層 API 調用,並建立即時監察機制。當 AI 涉及詐騙、騷擾、身份冒認或提示詞注入(Prompt Injection)等風險時,系統應能截停操作或轉交真人處理。

角色權限控制(RBAC)、身份驗證和行業專屬規則同樣重要。趙翔認為,這些底層功能未必值得每間企業自行開發,尤其是核心業務並非 AI 技術的公司。

企業選擇自建還是採購現成平台,仍須比較長期維護成本、內部技術能力,以及對供應商的依賴程度。

選擇 AI 平台 要考慮日後能否轉換

企業評估 AI 平台時,除了功能及價格,還要考慮能否串連跨部門流程、是否依賴特定模型或雲端,以及治理功能是否需要自行開發。供應商能否同時提供業務規劃及技術部署支援,也會影響項目能否順利推行。

資料可攜性是另一項考慮。趙翔表示,企業應確保自己擁有建立的 AI Agent、Prompt 及知識圖譜(Knowledge Graph),日後轉換平台時亦能匯出。

他坦言,目前不同平台的兼容程度有限,轉移時大約只能保留 70% 至 80% 的工作成果,其餘仍需修改。即使平台容許匯出資料及設定,企業仍須承擔遷移成本。

企業亦應確認平台能否按當地監管要求,設定零資料保存、刪除或遮蔽機制。

至於由供應商派駐工程團隊共同開發的模式,企業需要問清楚交付後由誰維護、內部團隊能否自行擴展,以及後續支援如何收費,避免長期依賴外部人手。

AI 投資先看工作量 不要只看示範效果

趙翔坦言,推動 AI 轉型時,向管理層說明投資回報往往比技術更難。不少企業有試點預算,卻沒有長遠規劃,因此需要先做策略工作,才能向董事會提出具體可信的轉型方案。


選擇 AI 用例時,趙翔建議優先處理重複性高、工作量大的流程。他直言,如果一個項目每月只能節省兩小時,很難有足夠價值推動正式部署。

企業應以多項指標為用例評分,例如工作是否重複、成本級別,以及哪些環節仍需要真人服務。酒店業等重視人際互動的行業,也未必適合將所有服務自動化。

部署速度亦會影響項目成敗。趙翔認為,AI 項目應爭取在數星期內投入正式運作,避免拖延數月令內部失去推動力。

企業可先從單一用例開始,證明效益後再擴展。他透露,積極推動全面 AI 轉型的客戶,投資通常超過 100 萬,但未說明貨幣單位。他亦分享過往經驗,即使擁有優秀工程團隊,花費兩季開發 AI 也未必取得理想成果。

希臘電視服務 8 星期部署 香港八達通參與 AI 沙盒

目前 Wonderful 的業務以銀行、保險及電訊行業較為成熟。

趙翔舉例,Deutsche Telekom 旗下希臘最大電訊商 OTE 集團的收費電視服務 COSMOTE TV,約 8 星期便部署客服 AI Agent,整合超過 30 個系統,其後再擴展至後勤流程。

Wonderful 公布的案例顯示,AI Agent 令平均處理時間減少約 30%,來電毋須轉交真人處理的比率(Deflection Rate)達 50%,約為原本的 3 倍。

趙翔表示,增加系統整合有望進一步提升 AI 獨立處理個案的能力。不過,這些成果由供應商自行公布,企業評估類似方案時,仍應要求實際運作數據及客戶參考。

香港方面,八達通獲選參與金管局、證監會、保監局及積金局聯同數碼港推出的 GenA.I. Sandbox++ 計劃,Wonderful 為其技術夥伴。

八達通的試點聚焦代理式商務及 AI 客戶服務。趙翔亦提到,雙方正探索如何服務不同年齡客群,以及個人化市場推廣等應用。沙盒計劃為期約 6 個月,但整體 AI 轉型工作將持續更長時間。


AI 與真人混合團隊 成為管理層新課題

企業引入 AI 後,員工是否接受改變同樣重要。趙翔原先預期員工可能因擔心失業而抗拒,但實際接觸企業時,發現不少人願意主動分享工作流程,甚至自願成為內部 AI 轉型推動者。

當 AI 能夠接手部分工作,企業仍需要決定如何調配員工、重新分配職責,甚至是否裁減人手。趙翔強調,這些屬企業自己的管理決策。

未來管理層亦需要學習如何監督 AI Agent 與真人共同工作的團隊,並讓內部員工逐步掌握 AI 系統的管理及擴展能力。


Wonderful 以香港作大中華區樞紐

趙翔形容香港企業普遍採取先觀察、再部署的態度,目前仍欠缺足夠正式投入營運、能展示實際投資回報的 AI 案例。Wonderful 亦有參與業界工作小組,與金管局等機構討論 AI Agent 的基準及最佳實踐。

Wonderful 於 2025 年初在以色列創立,現時總部設於荷蘭,2026 年 1 月以香港為樞紐成立大中華區業務,覆蓋港澳台及中國內地。大中華區總經理趙翔曾任職 PayPal、Flexport 及 Crypto.com。

Wonderful 將產品定位為企業 AI 作業系統,讓企業在同一平台建立及管理對話、語音、流程及電腦操作等不同類型 AI Agent,並內建權限管理、監察及審計功能。公司稱平台不綁定單一 AI 模型或雲端供應商,企業建立的 Agent 可以匯出。公司亦會派駐策略顧問及工程團隊,與客戶共同開發首批用例,再由企業內部團隊接手擴展。

閱讀文章
人工智能應用方案業界消息

LogTech Expo 2026 博覽 29 日舉行 逾 50 家企業展示 AI 與智慧供應鏈

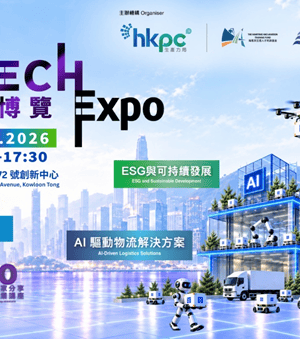
LOGTECH 物流科技博覽 2026 展示機器人與自動化解決方案.

香港生產力促進局主辦的「物流科技博覽2026」(LogTech Expo 2026)將於10月29日在九龍塘創新中心舉行,匯聚逾50家物流、供應鏈及科技企業,展示AI物流應用、智能倉儲、數碼供應鏈及無人機配送等方案。展覽免費入場,參觀者須先網上登記;開幕禮與專題講座則須另外選擇報名。

六大展區涵蓋智能倉儲與低空經濟

今屆博覽設六大主題展區,包括 AI 與數據應用、智慧倉儲及機械人、智慧供應鏈及數碼平台、跨境電商及配送、ESG與環保物流,以及低空經濟。展品及方案涵蓋智能分揀、倉儲管理系統(WMS)、運輸管理系統(TMS)、新能源運輸,以及無人機最後一公里配送等技術。

參展機構包括順豐數智供應鏈、香港海關、香港郵政、Auto-ID Technology、Tradelink、GS1 Hong Kong、ShipAny及Axis Communications。企業可在展場與方案供應商直接交流,了解相關技術如何配合實際倉儲、運輸及跨境電商流程。

AI數碼孿生實務分享 介紹物流資助計劃

主辦方在 10 月 23 日新聞稿中表示,將安排 10 場專題論壇及技術分享,重點包括 AI 物流應用、數碼孿生、跨境電商及供應鏈可視化。開幕座談會由團結香港基金副總裁葉文祺主持,香港理工大學黎基雄教授、香港付貨人委員會何立基、香港運輸物流學會會長張泰業及 MG Ship 行政總裁張淑明等參與討論。

官方登記日程另列出第三方物流服務供應商資助先導計劃(TPLSP)及未來智慧物流加速計劃(FILAS)的介紹環節。其中 FILAS 相關分享將由預先批核的方案供應商講解數碼工作流程、自動化及營運改善個案。其他講題包括 WMS 結合 AI 與數碼孿生、跨境電商多物流商整合、倉庫AI 安全監察,以及利用 GS1 條碼、物聯網和 AI 掌握供應鏈狀況。

設商務配對環節 入場及講座須分開登記

展覽期間設商務配對及業界交流環節,並獲機場管理局、國泰貨運、數碼港及 LSCM 研發中心等逾 20 個業界機構支持。活動由運輸及物流局「海運及空運人才培訓基金」下的「物流推廣資助計劃」資助。

活動於 10 月 29 日(星期四)上午 10 時至下午 5 時 30 分舉行,地點為九龍塘達之路 72 號創新中心。網上報名表格預設展覽入場券;有意參加開幕禮或專題講座的人士須在表格另選相關場次,否則只會取得展覽入場券。詳情及報名可瀏覽生產力局活動網頁。

資料來源:生產力局官方公告、活動登記及議程

閱讀文章
人工智能應用方案資訊及通訊科技

Zoom 推統一語境層 ZoomMate AI 代理可跨會議及企業系統執行工作

Meet ZoomMate 你的 AI 協作夥伴,搜索、協調與自動完成任務.

Zoom 於 10 月 20 日在年度 Zoomtopia 大會公布統一語境層(Unified Context Layer),把會議、電話、即時通訊與客服對話記錄,連同企業文件及第三方應用程式資料整合,供員工和 AI 代理查詢與執行後續工作。Zoom 希望藉此減少員工反覆翻查會議紀錄、重新整理決策及手動跟進任務的時間。

新系統可結合 Zoom 平台內的對話及已連接企業系統的近乎即時資訊,同時透過設定控制資料存取權限。Zoom 創辦人兼行政總裁袁征表示,AI 能否發揮作用,取決於它對企業業務背景的理解;公司正朝着將討論轉化為已完成工作的「執行系統」(System of Action)方向發展。

可搜尋逾 40 個第三方應用 開放 MCP 與 API 接口

Zoom 公布的 Agentic Search 現已支援搜尋 Zoom Meetings、Phone、Chat 及逾 40 個第三方應用程式,包括 ServiceNow、Workday、Google Drive 和 Microsoft OneDrive。員工可按權限尋找散落在不同系統的決策和工作資料,減少逐個平台搜尋的需要。

開發團隊亦可透過模型上下文協定(MCP)伺服器及 Search & Ask API,在外部 AI 工具取得 Zoom 的業務語境。Zoom 列出的相容環境包括 Claude、GPT、Codex、Microsoft Copilot、Gemini 及 Slackbot。Search & Ask API 和部分 MCP 功能已推出,但不同 AI 助理的直接整合仍按各自時程開放。Zoom 另一篇產品介紹指出,企業預計可自 11 月起在 Claude 和 Codex 內啟動部分 Zoom 工作流程,例如處理會議、聊天、電話工作及更新 CRM 記錄。

My Notes 自動建立跟進流程 ZoomMate 多代理已推出

My Notes Workflows 預計於 2026 年 10 月推出,可把會議摘要連接至 Zoom Chat、Salesforce 等工具。銷售、市場營銷及 IT 團隊可使用預設流程,亦可用自然語言描述需要自動化的步驟,無須另行操作工作流程設計工具。

至於已推出的 ZoomMate Agent Teams,則由多個專門 AI 代理分工處理同一項工作,再彙整成果交由人員審閱。Zoom 亦預告 11 月推出 Enriched Notes,將共享螢幕、簡報圖表和聊天內容對應至會議逐字稿;12 月推出 Follow the Meeting,為錯過全部或部分會議的員工提供個人化記錄及摘要。Zoom 另計劃於 12 月推出獨立 My Notes 手機 App,把面對面對話納入記錄範圍。

客戶服務與 AI 治理擴展 新管理功能分階段推出

Zoom CX 的 Customer Profiles 預計 11 月推出,將客戶跨渠道互動及相關記錄整理成動態檔案;同期預告的 CX Insights Transcript Intelligence,可按語音、聊天及電郵文字記錄分類和查詢,並結合處理時間等營運資料分析。Zoom Virtual Agent – Kiosk 亦計劃於 11 月將 AI 自助服務延伸至實體門市。

隨着代理可以接觸更多業務資訊,企業需要釐清各項存取和監督設定。Zoom 現已向指定 Zoom Workplace 客戶提供與 Microsoft Purview 配合的敏感度標籤;集中式 AI 管理及深偽風險偵測預計 12 月推出,限制 AI 可使用及生成資訊的 AI Guardrails 則要到 2027 年第一季才推出。這些功能現階段不能一概視為已可供企業全面部署。

Zoom 同時引用業績及自家研究支持 AI 業務發展:Zoom Virtual Agent 客戶數量增長 256%;在一項涵蓋 500 名美國知識型工作者的 2026 年調查中,72% 使用 Zoom AI 工具的受訪者認為工具帶來高度或極高業務效益,高於研究所列的 63% 市場平均值。相關效率評價屬調查結果,不能直接換算成企業已節省的成本或投資回報。

資料來源:Zoom 官方公告、Zoom AI 產品詳解、Zoom 企業治理公告

閱讀文章
人工智能企業趨勢應用方案

AI 代理由答問題轉向代辦工作 Claude Duet 接棒 Muse、Dots 爭小企業

簡約設計的科技應用圖標,圓形背景與流線型元素.

Anthropic 推出 AI 代理 Claude Duet 研究預覽版。Duet 由 Opus 5.5 驅動,主打專業人士及小企業東主,可每朝發出簡報,並在雲端代辦發票、糧單及合約等工作。目前只有美國 Claude Pro 及 Max 訂戶可經候補名單取得使用資格,Team 及 Enterprise 方案暫未包括。Duet 與 Meta Muse、OpenAI Dots 同屬在背景常駐、可自行執行任務的 AI 代理,反映競爭焦點由回答問題延伸至代辦日常工作;惟 Duet 的背景運作同樣會消耗訂閱用量。

Duet 每朝匯報,在雲端代辦發票與糧單

Duet 會主動跟進已連接的應用程式,毋須用戶每次重新下指令。它每朝整理這些應用程式中最重要的事項,日間只在有事需要用戶處理時才發出通知。Duet 在有獨立瀏覽器的雲端虛擬機器上運行,即使用戶關掉手提電腦或手機,工作仍可繼續;用戶可透過 iOS、Android 獨立應用程式或網頁版 Claude 使用。

任務範圍由安排會議,延伸至建立儀表板、製作財務或銷售預測、製作原型及建立網頁應用程式。Anthropic 表示,Duet 可配合超過 6,000 個連接器及插件使用。公司列出的用例包括在 Intuit QuickBooks 或 Stripe 找出未付發票並草擬催款提示、在 Gusto 準備及執行糧單、經 Docusign 傳送協議、根據 HubSpot 資料草擬跟進電郵,以及管理 Shopify 網店。產品頁雖列出 Microsoft 365 標誌,但有外國媒體引述 Anthropic 說明中心指,該連接器暫未可用,Slack 連接器亦有限制。

Anthropic 發布的早期試用證言包括:南佛羅里達州 Shahs of Kabob 有約 110 名員工,東主曾用 Duet 處理會計、客戶支援及營銷,並逐間店處理發票;地產代理公司 Pro Homes 東主則表示,Duet 曾在沒有要求下主動指出其日曆上一項睇樓預約排錯日子。這些證言只描述使用情境,沒有量化節省的工時或成本。

Duet 隨 Pro 可用,但未有企業版

Meta 早前於 9 月推出 Muse,OpenAI 約 3 星期後推出 Dots。Dots 由 GPT-6 Astra 驅動,透過 OpenAI 插件生態可連接超過 4,000 個應用程式。OpenAI 亦已宣布為企業客戶而設、針對會計、電郵營銷及法律分析等工作調校的 specialist Dots;Business Premium 用戶可使用 Dots,Enterprise 仍在 beta。相比之下,Duet 雖然主打專業工作,目前仍只納入個人 Pro 及 Max 方案。

產品及最低付費方案(美元/月) 開放地區及資格
Claude Duet:隨 Pro 每月 20 美元(約港幣 HK$156)可用,研究預覽期間不另收費 美國 Pro 及 Max 訂戶,須加入候補名單
OpenAI Dots:個人用戶最低為 Pro 100,每月 100 美元(約港幣 HK$780) 歐洲經濟區、瑞士及英國以外的合資格 Pro 用戶;Business Premium 在 ChatGPT 支援地區可用
Meta Muse:有設用量上限的免費層;Power 每月 20 美元(約港幣 HK$156),Maximum 每月 100 美元(約港幣 HK$780) 美國及加拿大

價格為 2026 年 10 月 21 日 Anthropic 價目頁及 Engadget 報道的數字,港元按 1 美元兌 7.8 港元換算,只作參考。Duet 的官方用例集中在發票、糧單及合約等小企業日常營運,但主打專業用途,不等於已具備企業方案的管理能力,兩者仍須分開評估。

付款簽約先要批准,轉帳及證券交易禁用

Duet 在發送訊息、付款、簽署文件或刪除任何內容前,會先展示準備執行的操作,等待用戶批准。部分操作則一律禁止,包括買賣證券及在帳戶之間轉帳,即使用戶批准亦不會執行。用戶亦可隨時中斷任何應用程式的連接,收回 Duet 的存取權。

Anthropic 表示,Duet 沿用旗下 Claude Managed Agents 的憑證處理設計,應用程式不會直接看到用戶密碼或登入權杖;新增的專用分類器及安全系統提示會逐條訊息檢查,拒絕分享信用卡號碼、政府身份證明等最高級別資料。購物付款透過 Stripe 的 Link 以虛擬卡進行,不會分享真實卡號。公司亦表示,紅隊及一間外部公司曾對 Duet 進行滲透測試,產品已納入 HackerOne 公開漏洞賞金計劃。

這套設計把敏感操作的最後決定留給用戶,但審批能否發揮作用,仍取決於用戶有否細看收件人、金額及文件內容。企業評估時宜分清代理可以準備甚麼,以及誰有權批准執行。

每幾小時才檢查,節省用量但可能漏事

研究預覽期間,Duet 與 Claude 其他功能共用 Pro 或 Max 用量上限,背景檢查亦計入其中。Anthropic 解釋,Duet 每幾小時才檢查一次已連接帳戶,因為不停檢查會快得多耗盡用量;建立財務模型或簡報等較大任務,亦需要更多模型回合。所以常駐並不代表即時監察,背景工作同樣佔用配額。

Anthropic 承認 Duet 仍屬早期版本,可能誤讀對話串、錯判緊急程度,亦可能漏掉兩次檢查之間到達的事項;訂票等個人雜務的表現也較弱。同一份說明中心資料亦指,用戶不能觀看或接管 Duet 的雲端瀏覽器,Duet 亦不會打電話或發短訊,只會在獲批准後從已連接帳戶發電郵。

對重度使用者而言,背景檢查會與日常 Claude 工作爭用配額,可能需要升級至每月 100 美元起(約港幣 HK$780)的 Max。評估成本時應一併觀察背景檢查與大型任務的用量,不能只憑「不另收費」判斷容量是否足夠。

企業 IT 宜先盤點連接系統與審批權限

Duet 現時只向美國個人訂戶開放,Anthropic 未公布 Team 或 Enterprise 版本的時間表;企業 IT 團隊可先盤點哪些財務、糧單、CRM 及電郵系統適合交予代理存取,並訂明付款、簽約及對外訊息由誰審批。以 Microsoft 365 為主的企業,要先確認連接器的實際可用狀態,才可判斷工作流程能否接通。

若 Anthropic 日後推出企業方案,企業採購時宜向供應商確認數據會否用於模型訓練、存放地區及保留期,並按實際任務比較用量和人工覆核需求。需要即時跟進的事項,亦應保留原有通知及人工處理流程,不宜單靠每幾小時才檢查一次的代理。

來源:Anthropic、Claude、The Verge、Unite.AI、Roos Newsletter

閱讀文章
人工智能應用方案業界消息

小米開源 AI 模型評測奪首 MiMo-V2.6-Pro 接入 WorkBuddy 擴展辦公應用

展示MiMo-V2.6-Pro開源AI平台界面,支持多智能體協作與Token上下文.

小米 10 月 20 日宣布,旗下開放權重 AI 模型 Xiaomi MiMo-V2.6-Pro 正式接入 WorkBuddy,支援長時間任務、多智能體協作及多模態資料理解。新模型具備 100 萬 Token 上下文視窗,並在第三方評測機構 Artificial Analysis 的智能指數取得約 46 分,於當時受測的開放權重模型中排名第一。

新模型主要面向需要處理大量文件、跨步驟工作及複雜資訊的用戶,涵蓋深度研究、文件處理、設計製作和小型工具開發等工作。企業開發團隊亦可透過小米提供的 API,將模型整合至現有應用程式及 AI Agent 工作流程。

支援 100 萬 Token 上下文 可協調多個 AI Agent

MiMo-V2.6-Pro 支援最多 100 萬 Token 上下文輸入,單次最大輸出長度為 128K Token。較長的上下文視窗可讓模型在同一工作階段處理較大規模的文件、程式碼及歷史對話,減少因上下文容量不足而需要分批輸入資料的情況。

模型支援多智能體協作,能夠配合不同 Agent 框架,把複雜工作拆分成多項任務,交由不同智能體處理。小米將長時間任務管理、深度研究、文件辦公、設計製作及工具開發列為主要應用方向。在多模態能力方面,MiMo-V2.6-Pro 可以理解文字、圖片、影片及音訊輸入,並綜合分析不同形式的資訊。不過小米官方規格顯示,模型目前的輸出模態為文字,不能把其多模態理解能力直接視為原生圖片、影片或音訊生成能力。

模型亦支援工具調用、結構化輸出、串流回應及上下文快取,為開發人員建立自動化工作流程提供所需功能。

Artificial Analysis 評測約 46 分 領先同期開放權重模型

小米公布 MiMo-V2.6-Pro 在 Artificial Analysis Intelligence Index 取得 46.32 分。評測機構亦確認模型在發表時位居開放權重模型榜首,較前代 MiMo-V2.5-Pro 約 26 分的成績有明顯提升。這項排名只適用於 Artificial Analysis 當時的評測方法及受測模型,並不代表 MiMo-V2.6-Pro 在所有 AI 應用或所有模型之中均排名第一。小米亦在官方技術公告承認,模型與部分領先的閉源模型仍存在效能差距。MiMo-V2.6 系列於 9 月下旬發布及開源,包括 Pro 和 Flash 兩個版本。小米透過擴大強化學習訓練規模改善模型的推理、程式編寫及 Agent 任務處理能力,並公開相關技術報告、訓練環境及強化學習程式碼。

API 每百萬輸入 Token 收費人民幣 3 元 支援既有開發介面

對企業開發團隊而言,MiMo-V2.6-Pro 的另一項特點是 API 定價。小米官方公布模型沿用 V2.5 系列收費,每百萬輸入 Token 為人民幣 3 元,每百萬輸出 Token 為人民幣 6 元,輸入快取命中時則為每百萬 Token 人民幣 0.025 元。

小米同時提供美元計價,分別為每百萬輸入 Token 0.435 美元、輸出 Token 0.87 美元,快取命中輸入為 0.0036 美元。上述屬小米官方 API 收費,不能直接套用至第三方平台 WorkBuddy 的實際服務價格。在系統整合方面,小米表示其 API 格式兼容 OpenAI 及 Anthropic 協議。使用相關開發介面的團隊可按官方文件調整 API Key、服務端點及模型設定,嘗試接入 MiMo-V2.6-Pro。

企業在選擇模型時,仍需按實際工作負載比較回應品質、Token 用量、延遲、資料處理安排及第三方平台收費。100 萬 Token 的上下文容量代表模型可接收的資料上限,並不能單憑規格判定模型在極長文件中的檢索準確度或多智能體工作成功率。

資料來源:
快科技
IT之家
Xiaomi MiMo 官方模型規格及定價
Xiaomi MiMo-V2.6 技術公告
Artificial Analysis 評測公告

閱讀文章
人工智能應用方案

DeepSeek V4.1 Flash 1017 登場 Agent 編程能力提升、API 價格不變

DeepSeek V4.1 Flash軟件界面,展示多個功能模塊和技術報告.

DeepSeek V4.1 Flash軟件界面,展示多個功能模塊和技術報告.

DeepSeek 今日(10 月 17 日)推出 DeepSeek-V4.1-Flash-1017,強化 AI 編程、自動化及 Agent 執行任務的能力。官方測試顯示,新版本在多項基準測試取得更高分數,同時縮短任務執行時間及輸出長度。DeepSeek 同日向開發者開放自家 Search 與 Fetch API,每 1,000 次成功請求分別收費 US$0.75(約 HK$5.85)。

新模型已部署至 DeepSeek 官方網站、應用程式及 API。現有開發者可繼續使用 deepseek-flash 模型名稱,毋須修改原有 API 呼叫方式,模型推理價格亦維持不變。

編程基準測試明顯進步 針對完整專案開發強化

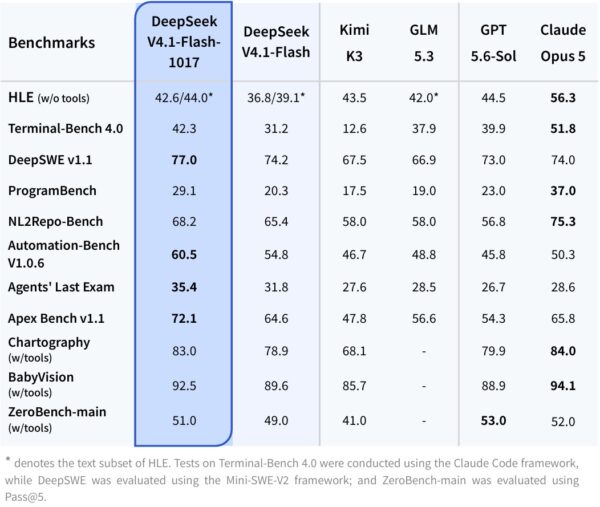
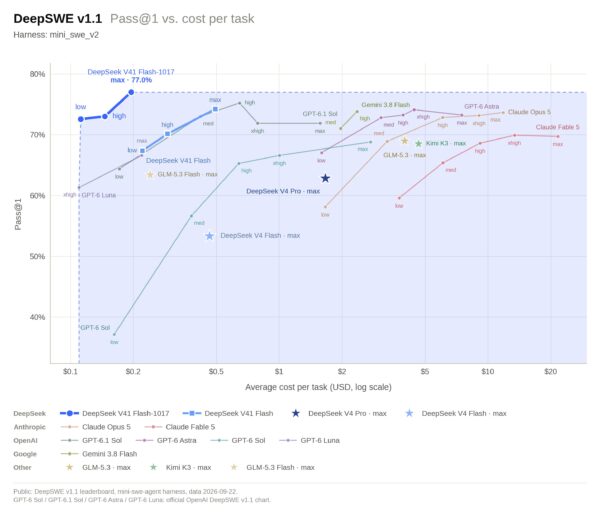
DeepSeek 公布的比較數據顯示,1017 版本在 Terminal-Bench 4.0 的成績由舊版 31.2 提升至 42.3;評估軟件工程工作的 DeepSWE v1.1 由 74.2 升至 77.0,而 ProgramBench 則由 20.3 提升至 29.1。

其他測試方面,Automation-Bench v1.0.6 由 54.8 升至 60.5,Agents’ Last Exam 由 31.8 升至 35.4。衡量複雜知識與推理能力的 Humanity’s Last Exam(不使用工具)亦由 36.8 提升至 42.6。

▲ DeepSeek 官方公布的 DeepSWE v1.1 編程測試結果,顯示 V4.1 Flash-1017 在 Mini-SWE-V2 測試框架下最高取得 77% Pass@1,該設定的每項任務平均成本約 US$0.20。圖中成本屬特定測試環境數據,不能直接視作企業實際開發成本。

▲ DeepSeek 比較新舊版本及其他 AI 模型的基準測試成績。V4.1 Flash-1017 在 Terminal-Bench 4.0、DeepSWE v1.1 及 Automation-Bench v1.0.6 分別取得 42.3、77.0 及 60.5 分,均高於上一版本;不同測試使用的工具框架及設定須一併考慮。


DeepSeek 表示,新模型採用結合自我回饋的強化學習方法,改善由零開始完成整個專案的能力,涵蓋遊戲製作及 3D 建模等工作。官方亦展示了模型執行相關任務的示範,但這些展示並不能直接代表模型在所有真實專案中的完成率。

廠商形容今次更新在效能與成本之間取得 Pareto Improvement(帕累托改進),即在提高任務表現的同時減少執行時間及輸出內容,讓開發者有機會降低每項任務所消耗的 Token 及模型推理成本。不過,上述成績主要來自 DeepSeek 公布的基準測試,實際效益仍取決於 Agent 框架、任務類型及執行設定。


配合多款 AI Agent 工具 開源權重可自行部署

DeepSeek 針對 DeepSeek Harness、騰訊 CodeBuddy 及 WorkBuddy 等開發工具進行適配,並建議使用 DeepSeek Harness v0.2.1-rc.1 或更新版本,以充分使用新模型功能。

對於已透過 DeepSeek API 建立內部編程工具或自動化工作流程的企業,這次更新可以沿用現有 API 模型名稱。企業仍須按原有工作流程,驗證新模型的程式碼品質、工具呼叫結果及任務完成情況。

DeepSeek 已在 Hugging Face 發布新版本模型權重,亦提供 ModelScope 下載渠道。Hugging Face 模型資料顯示,該版本支援最高 100 萬 Token 上下文,模型權重以 MIT License 授權發布,讓具備所需運算資源的企業及研究團隊自行部署。


自家網頁搜尋引擎開放 API Search 及 Fetch 分開計費

DeepSeek 同時開放由自家搜尋引擎支援的 Search API 和 Fetch API,讓 AI Agent 及檢索增強生成(RAG)系統取得最新網頁內容。

Search API 接收搜尋查詢並返回結構化結果,包括網頁標題、網址及摘要;Fetch API 則負責讀取指定網頁,將內容整理成 Markdown,方便語言模型進一步分析。兩項服務可使用現有 DeepSeek API Key 驗證。

官方文件列明,Search 及 Fetch 各按每 1,000 次成功請求收取 US$0.75,收費與模型本身的 Token 用量分開計算。只有請求成功返回 HTTP 200,而且 Search 找到結果或 Fetch 取得網頁內容時才會收費。搜尋結果為空、請求失敗或逾時均不計費。

兩項 API 各設每個帳戶每秒 5 次請求的限制,Fetch 另設個別網站域名的請求頻率限制。對需要大量搜尋、持續擷取資料或執行多步驟研究任務的企業而言,這些限制亦是系統設計時需要考慮的因素。

DeepSeek 在官方社交平台公布,DeepSeek API 用戶透過 DeepSeek Harness、Claude Code 及 Codex 的指定伺服器端工具呼叫 Search 與 Fetch,目前可暫免相關請求費用,並將於 2026 年 10 月 31 日 16:00 UTC 開始計費。這項豁免只適用於指定工具的相關呼叫,並不代表所有 Search、Fetch 或模型推理服務均免費。

DeepSeek 指其自研搜尋引擎目前每日處理全球數億次搜尋請求,索引數以千億計網頁,並提供多語言搜尋功能。這些規模及搜尋品質描述來自公司公布資料。

對使用 DeepSeek 開發企業 Agent 的團隊,新版本模型與搜尋 API 的推出提供了兩項可獨立使用的功能:更新模型以執行編程及自動化工作,以及將即時網頁搜尋與內容擷取整合至現有應用。兩者的用量、成本及系統限制需要分開評估。


資料來源:
DeepSeek 官方更新日誌
DeepSeek Search & Fetch API 文件
DeepSeek-V4.1-Flash-1017 模型資料

閱讀文章
人工智能應用方案

Gemini 4 Argon 開發者懶人包 收費、Context 限制與 Code Review 實測

Gemini 4 Argon logo與大號數字4在藍色背景上.

Gemini 4 Argon logo與大號數字4在藍色背景上.

Google 推出 Gemini 4 Argon,開發者即日起可使用付費 Gemini API。推出優惠價每百萬輸入 tokens 為 US$2、輸出 US$10,12 月 1 日起均加倍。Google 指內部 Antigravity 團隊的代理式程式碼提交量增加逾 35%,回滾次數減少近三分之一,但這是 Google 自身的工程數據,並非所有團隊都可達到的成效。

API 收費及存取方式

每 100 萬 tokens 收費(美元)
計費項目 至 11 月 30 日 12 月 1 日起
輸入 US$2 US$4
輸出(包括 Thinking) US$10 US$20
命中隱式快取的輸入 US$0.10 US$0.20

模型 ID 是 gemini-4-argon,可經 AI Studio 的付費 API 及 Google Cloud 使用。個人用戶在 Antigravity Desktop/CLI 使用 Argon 須有 Google AI Ultra;企業則可經合資格 Gemini Enterprise 訂閱存取。Google AI Pro 訂戶可在 Gemini App 使用模型,但不等於可以免費調用 API。

開發者遷移須知

設定 需要留意
Context 輸入、Thinking 及輸出共用最多 1,048,576 tokens
Thinking Level low/medium/high;預設 medium,應按任務測試延遲及成本
長輸出 一般單次輸出上限 65,536 tokens;要超過此值須配置 Long Decode/背景執行
快取 僅支援隱式快取;至少 4,096 tokens 才符合快取門檻,命中不保證
舊參數 temperature、top_p、top_k 會被忽略;不支援 Explicit Cache
執行時間 複雜任務可用 Background Execution,客戶端 Timeout 建議至少 15 分鐘

其中一項易被忽略的成本是 Thinking tokens 亦計入輸出收費。長時間 Agent 任務不應只按最終生成的程式碼行數預算。

Google 實際工程案例

案例 Google 公布的結果
Chrome 在 4,000 萬行 Chromium 程式碼庫中,從約 600 萬行的舊功能資料夾分離核心網頁處理程序,橫跨數百個檔案的重構由數月縮短至數星期
Google ADK 在約 20.5 萬行 Python 程式碼中自主工作 11 小時,完成 16,892 項單元測試;6 項改善建議只有 2 項通過人工 Code Review
ADK 效能 長 Session 的 InMemorySessionService 準備開銷減少約 40%;冷匯入快 21%,但冷啟動至首次模型請求仍約 3.07 至 3.09 秒

ADK 已合併的兩項修改分別是先過濾 Session 歷史才複製資料,以及延遲載入大型模組。被否決的 4 項方案涉及過期快取風險、使用第三方套件私有屬性、降低程式可讀性,或只改善合成測試而未見實際效益。

Google 的 40% 數字只針對記憶體 Session 準備流程,並不適用於使用 Redis、Firestore 或外部資料庫的 Session Store。其特定 158-turn 測試,整段框架執行時間由 65.6 秒減至 56.1 秒,不可當成模型推理速度提高 40%。

社群首日意見:能力不俗 工具與授權仍有分歧

Hacker News 有開發者表示,Argon 協助除錯 Vulkan 時主動輸出 Framebuffer 圖像、逐像素比對並在 Shader 加入顏色標記;同一討論亦有用戶批評 agy CLI 的 Context Compaction 時機難以預測,以及 Antigravity 訂閱門檻。這些屬個別實測與使用感想,尚不足以判定 Argon 全面優於 Claude Code 或 Codex。

另一名開發者分享 Gemini 網頁版的使用經驗,指出過去使用 Gemini 3.8 Flash 等舊模型詢問如何關閉 Claude Code 的 Git Commit Attribution 時,經常獲得錯誤指引,甚至被建議修改專案內的 CLAUDE.md 檔案。他表示改用 Gemini 4 Argon 詢問相同問題,模型終於正確指出應在使用者設定檔 ~/.claude/settings.json 調整 attribution 設定。他認為新模型在回答涉及既有開發工具設定的事實性問題時,準確度有所改善。不過這屬單一開發者的前後使用體驗,尚不足以證明模型整體幻覺率已明顯下降。

Google ADK 案例可供開發團隊參考的做法是,先向 Agent 提供 .agents/skills 專案規則、完整回歸測試及明確任務目標,再由維護人員決定哪些 Pull Request 可合併。評估模型時,亦應把 tokens、長任務耗時、測試成本及人工 Code Review 一同計算。

資料來源:
Google Gemini API 開發者文件、
Google ADK 技術實驗、
Google Cloud 官方公告、
Google Antigravity 公告、
Hacker News 開發者討論

閱讀文章
人工智能應用方案業界消息

Grok、Cursor 合併月費不包 Claude、GPT 開發者轉新 Plan 可能更貴

The X Subscription logo with icons on a dark background.


馬斯克旗下 SpaceXAI 10 月 12 日推出 The X Subscription,把 X Premium、Grok、Grok Bot 及 AI 編程工具 Cursor 整合為單一訂閱計劃,月費由 US$8 起。不過對於習慣在 Cursor 使用 Claude、GPT 或 Gemini 的香港開發者,新計劃可能令實際支出增加,因為第三方 AI 模型不再包含於月費額度內,必須由首次使用起另外付費。

月費 US$8 起 US$30 才包括 Grok Bot

新計劃分為免費、Plus、Premium、Super 及 Ultra 5 個級別。官方宣稱每月 US$30(約 HK$234)的 Premium 計劃,已整合過去分別訂閱 SuperGrok、Cursor Pro 及 X Premium+ 的功能,原本三項服務合計每月 US$90(約 HK$702)。

各計劃的收費及主要差異如下:

計劃 月費(美元) 共享 AI 額度 Grok Bot 第三方模型
Free 免費 有限 不包括 不包括
Plus US$8 基本額度 不包括 不包括
Premium US$30 Plus 的 4 倍 包括 另行付費
Super US$100 Plus 的 15 倍 包括 另行付費
Ultra US$200 Plus 的 50 倍 包括 另行付費

上述價格未計適用稅項。訂戶可透過同一帳戶使用 Grok 聊天、語音、圖像及影片生成,以及 Cursor 編程功能。Grok Bot 則須訂閱 Premium 或以上級別。

新計劃採用每星期更新的共享用量池,Grok、Cursor 及 Grok Bot 的合資格使用量均從同一額度扣除,並非每項產品各有獨立配額。不同操作消耗的額度亦有分別。

Claude、GPT 及 Gemini 不包月費額度 首次使用即計錢

對於以 Cursor 作為主要編程工具的開發者,新舊計劃最大的差異是第三方模型的計費方式。

現有 Cursor Pro、Pro+ 及 Ultra 計劃,分別每月收費 US$20、US$60 及 US$200,均設有 Cursor Models 和 Other Models 兩個使用量池。後者可用於 Claude、OpenAI GPT 及 Google Gemini 等模型,在相應額度內使用毋須額外付款。

轉用 The X Subscription 後,月費涵蓋的共享額度只適用於指定第一方模型及服務,包括 Grok 4.7 等模型。Premium、Super 及 Ultra 訂戶仍可在 Cursor 選用 Claude、GPT、Gemini,但每次請求均按模型 API 定價收費,從另行購買的 Additional Usage 預付額度扣除。

這亦不代表用戶必須自行申請 Anthropic 或 OpenAI API Key。官方提供 Top-up 機制,直接為額外模型使用量付費,並可設定支出上限。

以現有每月 US$20 的 Cursor Pro 訂戶為例,如果日常編程主要依賴 Claude,即使升級至每月 US$30 的 X Subscription Premium,仍須額外支付 Claude 的實際使用費。合併訂閱雖然增加 Grok、X Premium 等服務,卻未必能節省編程開支。

舊訂戶可以保留原 Plan 合併帳戶後不能還原

Cursor 官方確認,現有用戶毋須立即轉換,新計劃推出後,原本 Cursor Pro、Pro+ 及 Ultra 的價格和第三方模型使用額度仍可保留,直至用戶主動轉換或原有計劃日後調整。

另一項重要限制是帳戶合併屬永久操作。根據官方文件,用戶把 Cursor、Grok 及 X 帳戶統一至 The X Subscription 後,不能撤銷合併,客服亦無法代為還原。

官方會按比例退還符合資格的舊訂閱未使用款項,但透過 Apple App Store 購買 Cursor 訂閱的用戶,仍須自行在 Apple 訂閱設定取消原有計劃,否則可能繼續被收費。

公司亦表示將來可能逐步把剩餘舊訂戶轉至新計劃,但目前未有具體時間表,屆時會預先通知。

企業團隊可集中管理帳單 須留意額外 API 開支

對於使用 Cursor 開發企業系統的團隊,新計劃亦提供每席每月 US$30、US$100 及 US$200 的 Teams 版本,支援集中收費、使用量分析、SSO 及管理員控制。企業可為不同成員選擇不同級別。

每個成員各有每星期更新的第一方模型用量池,團隊則共用額外使用量的預付結餘。當開發人員在 Cursor 選用第三方模型,相關費用會計入 Additional Usage,管理員可透過預算上限控制開支。

因此企業評估新計劃時,需要同時比較訂閱費用、實際模型使用比例,以及每月第三方模型的 Token 成本。若開發工作主要依靠 Grok,新計劃的共享額度可能較有吸引力;但對長期依賴 Claude、GPT 或 Gemini 的團隊,原有 Cursor 計劃所包含的第三方模型額度,仍是重要的成本差異。

資料來源:
SpaceXAI 官方公告
The X Subscription 官方收費文件
帳戶合併與第三方模型條款
Cursor 模型及原有收費資料

閱讀文章