close

微電子業

人工智能微電子業雲端服務

中國算力最緊缺兩年將至 阿里雲訓練用平頭哥、推理多款國產晶片並用

伺服器機箱內部的高性能處理晶片與散熱設計,數據中心機櫃風道清晰可見.

阿里巴巴集團行政總裁吳泳銘在 2027 財年第 2 季業績分析師電話會上表示,2027 及 2028 年將是中國算力最緊缺的兩年,阿里雲 2027 年後的晶片供應會以集團全資半導體業務平頭哥(T-Head)的國產晶片為主。旗艦晶片會優先滿足大模型訓練,推理方面則會盡量採購更多不同晶片,包括其他品牌的國產晶片。公司稱會在此基礎上考慮合作夥伴的客戶需求,但未交代外部雲端客戶的配額或價格安排。

平頭哥晶片已用於訓練下一代千問模型

阿里巴巴已在平頭哥晶片上訓練下一代千問(Qwen)模型;吳泳銘表示,阿里亦已基於國產晶片提供模型推理服務。他聲稱自研晶片與自研模型協同,將持續帶來更優的單位算力成本及更高的 AI 應用研發效率。

他又表示,下一代平頭哥國產晶片將於 2027 年第 1 季全面支援超大規模模型訓練。據報公司亦預期,平頭哥 2026 年 9 月在雲棲大會發布的 AI 晶片真武 V900,將於 2027 年初量產。

美國晶片新限制下,20GW 目標或下調

阿里巴巴管理層表示,受全球各地算力政策變化影響,包括美國對先進晶片的新限制,初步評估早前提出的 2032 年全球數據中心規模超過 20GW 目標或會下調,整體資本開支計劃亦會相應調整;同時公司會以更進取步伐建設以平頭哥為核心的國產算力供應鏈。

管理層預期美國擬議的運算晶片出口管制會影響公司 2027 年的產品和服務,但認為現時評估新規的全面影響仍言之尚早。

雲收入增長 2027 年或放緩至 30% 至 45%

阿里巴巴預測雲業務收入增長在 2027 年或會放緩至 30% 至 45%,到 2028 年國產算力改善後有望回升至 50% 或以上。公司亦預期,自研國產晶片在 2027 至 2028 年可提供成本優勢,支撐雲業務毛利率。

在 2027 財年第 2 季,阿里的 AI、雲及運算服務收入按年增長 53%,達人民幣 610 億元(約港幣 718 億元);外部客戶收入增長 64%。同季資本開支為人民幣 505 億元(約港幣 594 億元),自由現金流淨流出人民幣 345 億元(約港幣 406 億元)。

阿里推理採購多款國產晶片,客戶安排未交代

阿里巴巴表示,旗艦晶片會優先滿足大模型訓練,推理方面則會盡量採購更多不同晶片,包括其他品牌的國產晶片,以支援內部推理需求。公司稱會在訓練優先的基礎上考慮合作夥伴的客戶需求,但未交代外部客戶能否使用旗艦晶片,以及配額或價格安排。

早前有報道指,截至 2026 年 2 月平頭哥晶片已交付 47 萬片,年化收入超過人民幣 100 億元(約港幣 118 億元),逾 60% 晶片部署給商業客戶。阿里雲亦於 2026 年 3 月宣布,4 月 18 日起真武 810E 算力服務加價 5% 至 34%;據報原因是全球 AI 需求急升及供應鏈成本上漲。

按阿里對算力緊缺的預期推論,雲端客戶在 2027 至 2028 年可能面對供應緊張,價格亦可能上升,但公司未交代外部客戶的相關安排。若阿里的推理服務日後使用多款國產晶片,兼容性和效能亦可能有差異;IT 團隊可分開評估訓練與推理需求,並測試不同晶片處理推理工作負載的表現。
來源:Bloomberg、Futu News、Benzinga、TrendForce、凤凰网

閱讀文章
IT 基建人工智能微電子業

美國管制由賣晶片伸延至租算力 新加坡、馬來西亞、泰國等租 GPU 受堵

特朗普在正式場合作為政治人物的形象照,穿著深色西裝與紅色領帶,背景有美國國旗.

美國商務部產業與安全局(BIS)公布先進 AI 晶片暫行最終規則,把出口許可要求擴至新加坡、馬來西亞、泰國、印尼及巴西,並按資料中心向中國等地企業提供的遠端算力設許可門檻。對依靠海外資料中心租用 GPU 的中國企業來說,影響許可要求的除了晶片運到哪裏,還有資料中心的服務對象及算力規模。規則預計美國時間 11 月 19 日刊登聯邦公報後生效。

新規涵蓋晶片出口、再出口及境內轉移至上述 5 國,申請逐案審查。全球資料中心若向總部或最終母公司位於澳門,或中國等 D:5 國家群組的企業,提供超過 1,200 萬「總 TPP」的算力存取,出口或轉移先進晶片至該資料中心亦須許可;涉及澳門及 D:5 的申請原則上不予核准。TPP 是美方衡量晶片運算能力的指標,D:5 則是美國出口管制中的受武器禁運國家群組。商務部表示,新規要防止企業透過第三國資料中心的遠端運算安排規避既有限制。

已服務中企的資料中心須於生效後 90 天取許可

BIS 新規要求,已向澳門及 D:5 國家相關企業提供大量算力的資料中心,須在規則生效後 90 天內取得許可,否則將面對後續出口限制。算力只用於符合規定的商業推薦系統,可豁免遠端算力許可要求,但仍須向 BIS 申報;具備或整合生成式 AI 功能的系統不適用豁免。

出口給總部或最終母公司位於美國的企業,可不受上述 5 國的許可要求限制,但交易須按月向 BIS 申報,最遲在交易次月的第一個工作日提交。申報資料包括交易各方、最終目的地、出口管制分類編號(ECCN)、產品名稱及 SKU、TPP、數量和出口日期。

新規亦收緊晶片製造端的規定。晶圓前段製造廠及委外封測業者(OSAT)替未獲美方核准或授權的設計公司生產先進邏輯晶片時,晶片會被推定為受管制先進晶片;總部或最終母公司位於 D:1、D:4、D:5 國家群組的設計公司,不再可透過盡職調查程序推翻這項推定。

暫行最終規則將開放 60 天意見徵詢,並正式撤銷拜登政府時期的 AI 擴散規則(AI Diffusion Rule);BIS 表示該規則從未執行。

東南亞資料中心被指成中企租用 GPU 渠道

東南亞資料中心被指是中國企業遠端租用 GPU 的渠道。據報美國在 2021 至 2024 年間陸續要求本土雲端業者不得服務中國客戶,但其他地區的雲端業者沒有同樣義務,因而形成讓中國客戶遠端取用算力的市場。

外界普遍認為,馬來西亞及泰國的資料中心建設熱潮,瞄準想租用 GPU、卻無法自行進口晶片的中國客戶。另有報道指,中國 AI 開發商阿里巴巴(Alibaba)及字節跳動(ByteDance)的需求帶動東南亞成為資料中心樞紐,當中馬來西亞及泰國最熱,印尼仍處早期發展階段;新加坡並非主要資料中心據點,卻被懷疑用作名義出貨地,伺服器再轉運到中國。

新規的資料中心門檻不限地區,東南亞以外的資料中心同樣適用,以網絡相連的資料中心亦會合併計算總 TPP。服務總部或最終母公司位於澳門或 D:5 國家群組企業的資料中心,要取得先進晶片須申請許可,相關申請原則上不予核准,但規則並非明文全面禁止。

據報黃仁勳辭任數日後,美國推出算力新規

據報美國算力新規在 Nvidia 據稱捲入間諜疑雲、美國晶片出口管制受更多檢視之際推出,距黃仁勳(Jensen Huang)辭去 Nvidia 行政總裁只有數日;辭任消息暫未見 Nvidia 官方公告證實。據報黃仁勳辭職前承認與新加坡 Megaspeed International 前高層 Alice Huang 有婚外情,美方懷疑 Alice Huang 是中國間諜。Megaspeed 正因可能違反出口管制接受美方調查,該公司否認有任何不法。

美國政府內部對晶片管制亦有不同聲音。商務部表示,新規由財政部與國家安全會議撰寫並依其指示制定。財長 Scott Bessent 早前批評商務部長 Howard Lutnick 執行既有管制不力;美國總統特朗普(Donald Trump)則表示無意撤換 Howard Lutnick,並指他可能為免在敏感貿易談判期間激怒中國而放慢出口管制工作。

前商務部資深官員、律師事務所 Wiley Rein 合夥人 Nazak Nikakhtar 認為,規則早應推出,突出問題在於執法,並質疑若商務部與規則保持距離,哪個政府部門會主導執法。

Counterpoint:新規或令中企短期算力受限

市場研究機構 Counterpoint 研究副總裁 Neil Shah 認為,新規會令中國科技巨頭面對嚴重的短期算力瓶頸。他指出,新加坡、馬來西亞及印尼等樞紐的資料中心業者,將面對大規模「了解客戶工作負載」(Know Your Customer’s Workload)要求,須向美國監管機關證明算力沒有流回受禁運國家,否則可能失去取得美國晶片的渠道。

Neil Shah 亦預期,長遠而言新規會大力催化脫鉤,迫使中國資本及工程人才加碼投入全端自主方案,加速華為(Huawei)昇騰(Ascend)等生態系發展。新加坡貿工部及數碼發展部表示正仔細研究新措施,並與企業接觸了解潛在影響;巴西政府則表示正密切關注,暫時未能評估對進口的影響。

若資料中心業者要證明客戶工作負載的去向,在東南亞租用 GPU 的企業可能要向服務商交代母公司所在地及工作負載用途,算力合約亦可能多一重審查。

來源:BIS (U.S. Bureau of Industry and Security)

閱讀文章
IT 基建人工智能微電子業

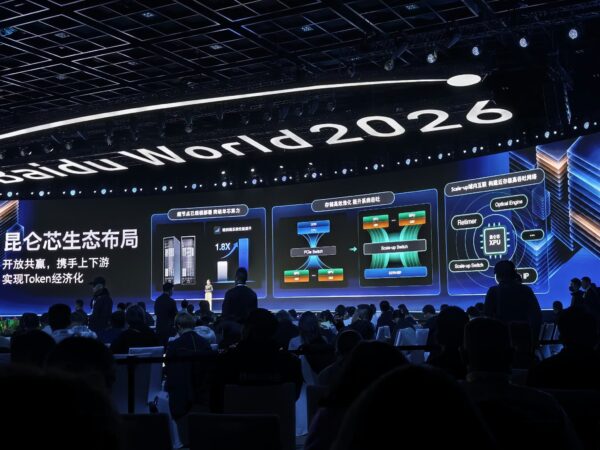
百度李彥宏看好 AI 推理晶片需求 崑崙芯 M300 2027 年推出

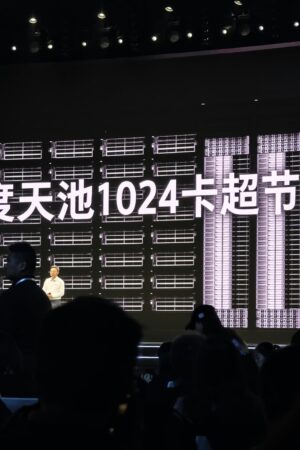
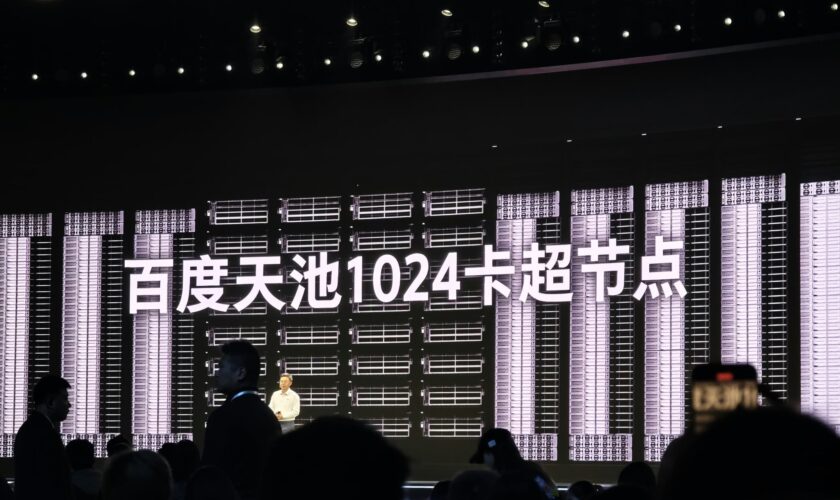
百度天池1024卡超節點發布會現場大屏與觀眾群體.

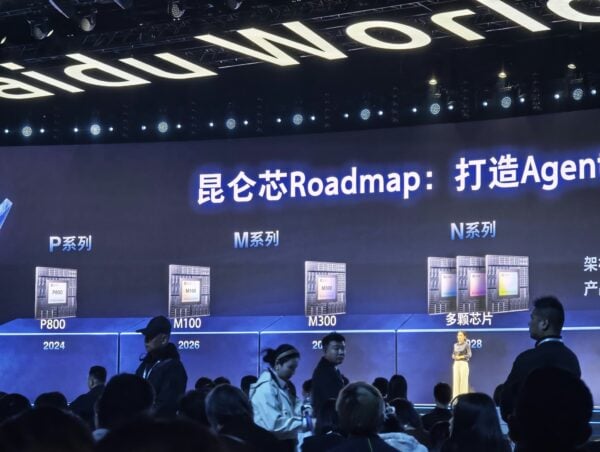
百度創辦人兼行政總裁李彥宏在 11 月 12 日百度世界 2026 大會表示,隨着 AI 智能體應用規模擴大,推理運算正與模型訓練成為同等重要的算力需求。他預期推理將帶動 AI 晶片市場長期增長。旗下崑崙芯宣布 M100 已按計劃出貨,旗艦晶片 M300 預計 2027 年推出,2028 年再推出採用全新 N 架構的多款晶片。

智能體應用擴大 李彥宏料推理需求持續增加

李彥宏在大會指出,AI 算力需求過去主要集中於模型訓練,現在已轉為訓練與推理並重。隨着智能體逐步承擔複雜工作,模型需要反覆處理指令和調用工具,推理工作量隨之增加。他表示:「我們相信,推理將成為 AI 晶片長期持續增長的主要推動力。」

模型訓練是建立及更新模型參數的過程,推理則是使用已訓練模型處理輸入及產生結果。企業部署智能體時,單一業務任務可能涉及多次模型調用,運算需求亦取決於使用頻率、模型大小與工作流程。對處理大量查詢的企業而言,推理成本及系統回應速度會直接影響日常營運開支。

崑崙芯 M100 已出貨 年底前料具備量產條件

崑崙芯表示,M100 已按原定計劃開始出貨,主打具成本效益的大規模 AI 推理運算。百度在 11 月 16 日公布的第三季業績公告進一步指出,M100 於 2026 年 7 月世界人工智能大會首次公開展示,預計到 2026 年底才具備量產條件。已開始出貨不代表現時已全面量產,兩項公告所指的是不同產品階段。

崑崙芯預計於 2027 年推出旗艦晶片 M300,並稱新產品將提升運算能力、記憶體及晶片互聯能力,以應付更大型的 AI 工作負載。到 2028 年,公司計劃再推出多款採用全新 N 架構的晶片,配合不同應用場景。百度未在今次官方新聞稿提供 M300 的完整規格或獨立效能測試結果,相關改善仍屬公司產品規劃。

百度推出天池 1024 卡超節點 第三季 AI 雲端基建收入增 94%

百度智能雲同場公布天池 1024 卡超節點,採用全光互聯技術連接大量 AI 加速晶片,供大型模型訓練與推理系統使用。這項設計將晶片之間的數據傳輸能力納入算力系統考量,亦配合百度自行研發晶片及提供雲端 AI 服務的部署方向。

根據百度 11 月 16 日公布的未經審計第三季業績,AI 雲端基礎設施收入達人民幣 82 億元,按年增加 94%。同期,千帆模型服務平台來自外部客戶 Token 使用的收入按年增加 1,159%。這些數字反映百度整體 AI 雲端業務增長,不能直接視作崑崙芯晶片的獨立銷售成績。

百度持續投資自主晶片 企業部署仍須考慮實際成本

李彥宏表示,百度願意長期投資技術研發,崑崙芯是公司十多年持續投入的成果,其商業價值正獲更多市場認可。崑崙芯目前以 M100 回應推理成本需求,並規劃透過 M300 及後續架構支援更複雜的運算場景。

對企業採購團隊而言,選擇 AI 算力服務仍須考慮現有模型與軟件框架的兼容程度、實際推理吞吐量,以及長期營運成本。百度今次公布了產品出貨進度和晶片路線圖,但 M300 的具體部署成本及獨立效能比較仍有待產品推出後驗證。

資料來源:百度 11 月 12 日官方新聞稿、百度 11 月 16 日第三季業績公告

閱讀文章
人工智能企業趨勢微電子業

自動駕駛方案之爭:Nvidia、地平線、比亞迪誰能更掌握未來市場

自動駕駛晶片、車載感知與運算平台融合,未來出行科技前瞻.

Nvidia 與韓國科學技術院(KAIST)研究人員於 11 月 10 日公開自動駕駛世界模型 BirdDreams,能以單張車載鏡頭影像為起點,生成第一身行車畫面及同步鳥瞰圖,並模擬測試車突然切線時,周圍車輛如何減速或避讓。研究顯示,AI 仿真正由重現道路影像,進一步發展至預測不同車輛之間的互動。

這項研究反映車廠面對的新問題:自動駕駛系統除了識別路況,還要經過大量安全測試。中國內地針對 L3/L4 自動駕駛系統的新規將於 2027 年 7 月 1 日生效,車廠選擇技術平台時,除了晶片算力,還須計算安全驗證、仿真測試、硬件成本及後續維護開支。

Nvidia 提供涵蓋 AI 訓練、仿真及車載運算的開發平台,華為提供整合式智能駕駛方案,地平線以中央運算晶片控制成本,比亞迪、Tesla 及小鵬則增加自研晶片的投入。不同路線各有成本及限制,車廠需要按產品定位決定投資方向。

內地安全新規明年實施 車廠須證明系統可靠

內地首項針對 L3/L4 自動駕駛系統的強制性國家標準 GB 44721—2026,於 2026 年 7 月 30 日獲批,內地工業和信息化部於 8 月 4 日公布,2027 年 7 月 1 日正式生效。

新規要求自動駕駛系統在指定運作範圍內具備足夠安全能力,包括應對感應器故障、系統異常及駕駛者未能接管等情況。車廠須按標準要求完成安全驗證,證明系統能在不同情況下控制風險。

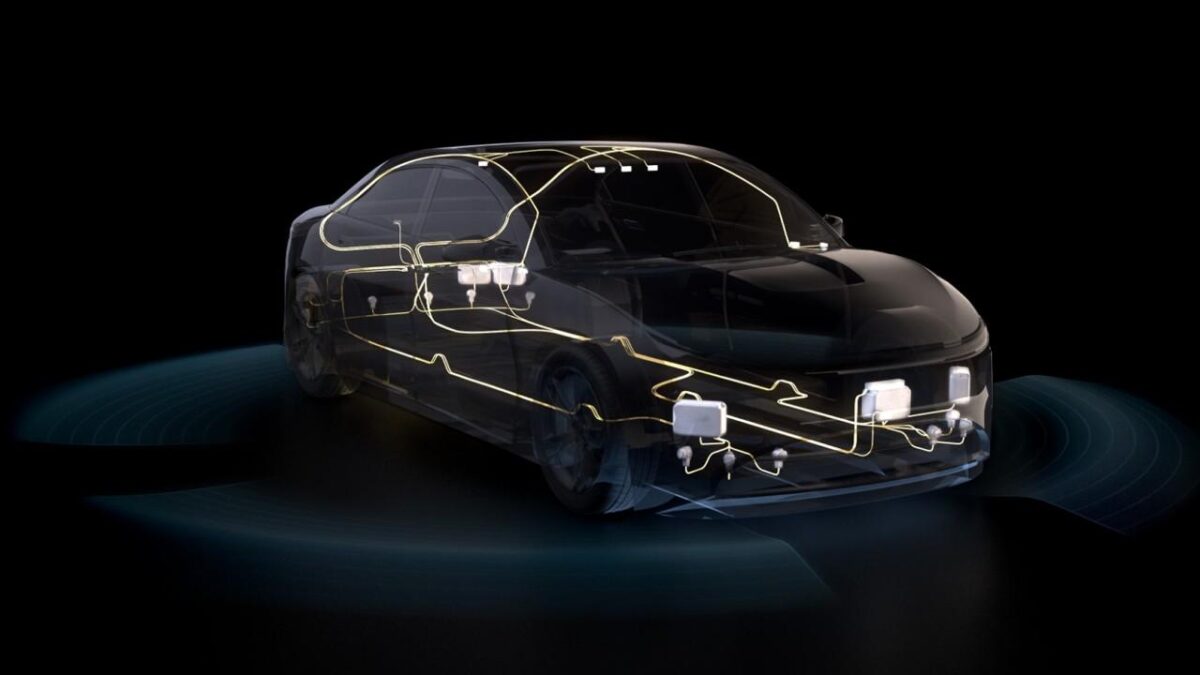
業界正採用不同安全設計。Nvidia Hyperion 10 參考架構(平台前稱 NVIDIA DRIVE Hyperion)採用兩片 DRIVE Thor 晶片及備援感應器。當主要運算系統失效,另一組系統可按設計接管相關工作。比亞迪則於 5 月公布專為 L3/L4 開發的「天神之眼自動駕駛版」,採用全套自研技術,設有十重備援安全設計,涵蓋車載運算、感應器及車輛控制等環節。

兩者分別代表採用外部供應商的安全平台,以及由車廠自行設計整套安全架構的路線。Nvidia 官方資料顯示,DriveOS 6.0 已取得 ISO 26262 ASIL D 安全認證,早期認證以 Orin 平台為基礎;Thor-X 晶片亦已通過相應安全符合性評估。不論採用哪種方案,整車仍須完成適用市場的安全驗證,不能直接沿用晶片的認證結果。

▲ Nvidia Hyperion 參考架構整合車載運算與多種感應器,供車廠開發 L4 自動駕駛系統。

記憶體價格上升 每輛車的硬件成本更難控制

記憶體價格上升已影響智能駕駛功能定價。比亞迪於 4 月 28 日宣布,旗下部分車款「天神之眼 B 輔助駕駛激光版」的選購價格,由人民幣 9,900 元提高至 12,000 元,加幅約 21%,5 月 1 日起生效。4 月 30 日或之前已支付訂金的客戶不受影響。

新一代 AI 自動駕駛需要處理更多鏡頭及感應器資料,對記憶體容量和頻寬的要求亦隨之增加。車廠除了計算運算晶片價格,還要考慮雷達、散熱及電力消耗。

晶片供應商正嘗試集中車載運算,減少獨立控制器及重複的記憶體配置。地平線於 4 月 22 日公布「星空」(Horizon Starry)座艙及智能駕駛整合晶片,聲稱將原本分開的兩套運算系統合併,每輛車可節省人民幣 1,500 至 4,000 元硬件成本。Nvidia DRIVE Thor 同樣支援整合自動駕駛、泊車及車廂 AI 等運算,並可透過模型量化減少記憶體需求。

集中更多運算亦增加系統設計難度,車廠需要確保座艙功能不會干擾自動駕駛系統。地平線為此採用名為「城堡」(Fortress)的物理隔離架構,讓座艙與智能駕駛系統獨立運行。地平線表示,其智能駕駛系統安全設計達到 ASIL-D 等級,即使座艙系統重新啟動,亦不會影響智能駕駛功能。

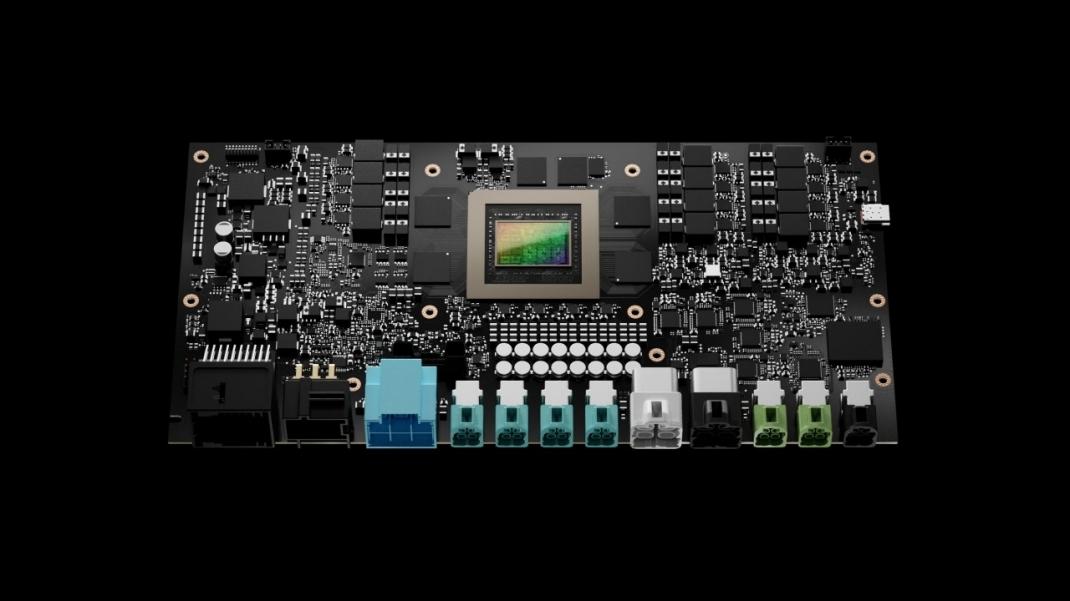
▲ Nvidia DRIVE AGX Thor 車載運算平台,可整合自動駕駛、泊車及車廂 AI 等工作負載,減少使用多套獨立處理器的需要。

自動駕駛走向 AI 推理 能否應付陌生路況成重點

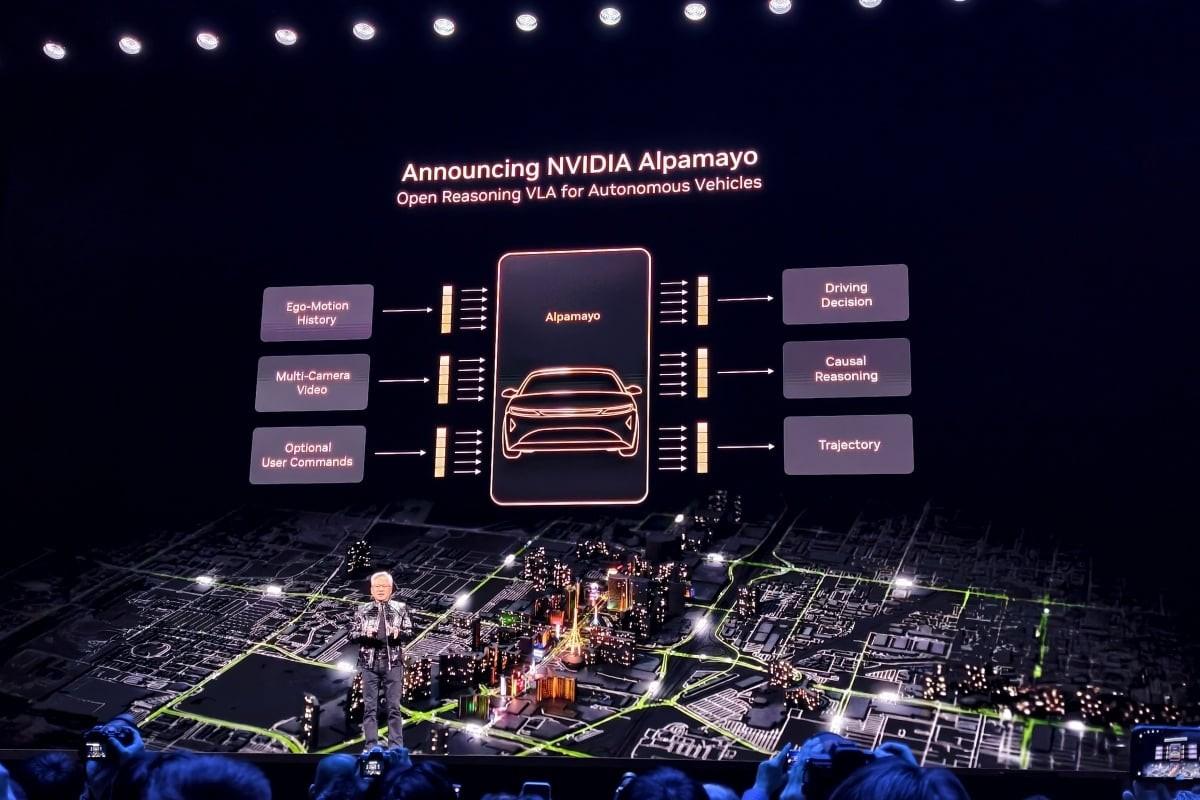
自動駕駛正由傳統規則及端到端模型,逐步加入更強的場景理解與推理能力。新一代視覺語言動作模型(VLA)可分析道路影像、車輛狀態及導航資訊,預測可能發生的情況,再規劃行車動作。

例如道路因工程臨時改道,系統除了識別路障,還須理解臨時行車安排,判斷應否減速、停車或選擇其他路線。這類較少遇到的交通情況,是自動駕駛模型仍需改善的地方。

車廠亦面對 L3 和 L4 的選擇。L3 允許系統在指定條件下執行駕駛任務,但仍可能要求駕駛者接管;L4 則須在指定運作範圍內,即使無人接管也能安全處理異常。由於 L3 在等待司機接管期間亦需要安全備援,部分車廠可能選擇直接採用可擴展至 L4 的硬件設計,避免日後大幅修改。

BirdDreams 模擬車輛互動 軌跡誤差減少約 35%

Nvidia 與 KAIST 最新提出的 BirdDreams,針對自動駕駛仿真系統難以模擬交通互動的問題。部分現有方案會按照預先記錄的車輛軌跡生成畫面,當測試車突然切線或改變行車路線,其他虛擬車輛仍可能沿着原有軌跡行駛,令測試結果失去參考價值。

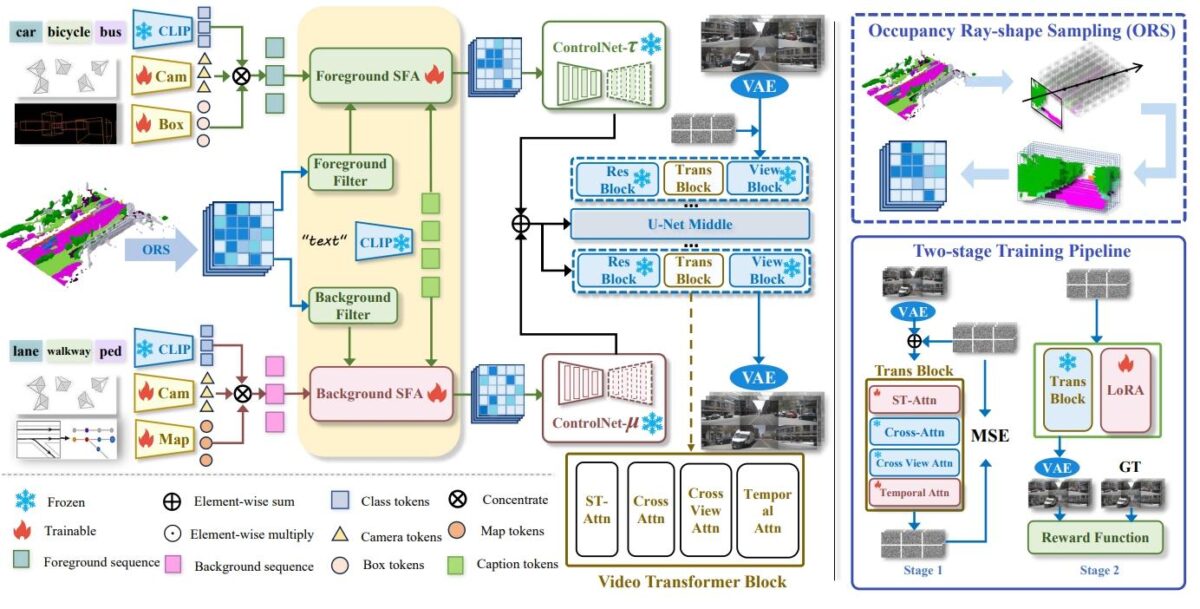
BirdDreams 採用兩組影片擴散 Transformer,同步生成車載鏡頭畫面及鳥瞰圖(BEV)。兩組模型透過聯合注意力機制交換資訊,從不同角度推算道路及車輛位置。進行推論時,系統可由單張 RGB 影像開始生成場景,毋須額外輸入高精度地圖或周圍車輛的狀態資料;如提供測試車的預定軌跡,模型亦可模擬其他車輛可能作出的反應。

研究團隊在 PhysicalAI-AV 數據集測試,發現 BirdDreams 按指定行車路線生成影片時,平均位移誤差由比較模型的 5.88 米降至 3.83 米,減少約 35%。這項數據反映模型生成行車動態的準確度有所改善,並不代表實際道路事故率減少 35%。

BirdDreams 目前仍屬研究階段,論文尚未提供足以證明模型可實時運作的效能數據。這類研究顯示,自動駕駛仿真需要進一步模擬交通參與者如何互相影響,讓車廠可以反覆測試現實道路上難以安全重現的危險情況。

▲ BirdDreams 採用兩組影片擴散 Transformer,分別生成第一身行車畫面及鳥瞰圖,並透過聯合注意力機制交換資訊,預測車輛位置及交通互動。(圖片來源:Nvidia/KAIST 研究論文)


研發成本高昂 開源模型與仿真工具成車廠新選擇

車廠在訓練自動駕駛 AI 時,需要大量道路數據及 GPU 資源,仿真測試同樣涉及開發成本。市場研究機構 Counterpoint Research 今年 5 月發表報告,引用 Nvidia 汽車業務副總裁吳新宙的公開訪問,以「三台電腦」及「五層蛋糕」分析 Nvidia 的自動駕駛策略:雲端負責訓練、仿真系統負責測試,車載電腦負責即時運算,配合不同層次的軟件、模型及開發工具。

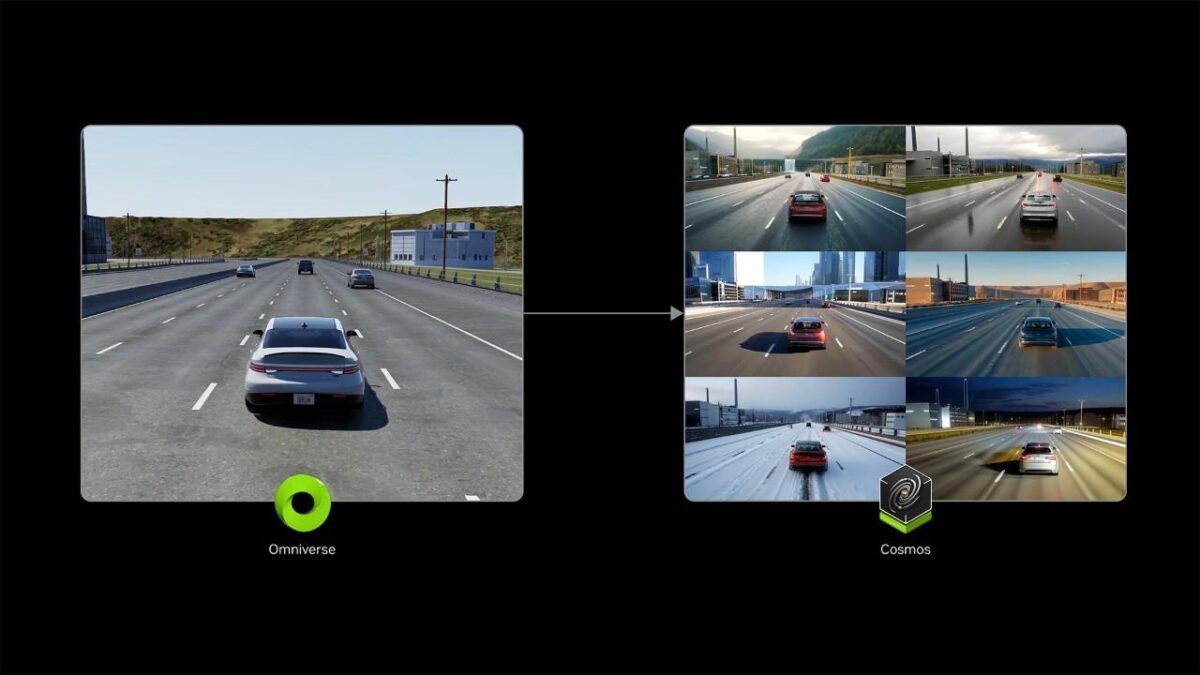
Nvidia 亦提供 Cosmos 世界模型、AlpaSim 仿真框架及 Omniverse NuRec 3D 重建工具。NuRec 可將實際道路拍攝資料重建成虛擬場景,Cosmos 協助生成不同天氣、光線及交通情況,AlpaSim 則模擬汽車作出決策後的道路變化。車廠可利用這些工具補充實車測試,反覆檢查 AI 在危險或少見場景下的反應。

BirdDreams 屬獨立科研模型,目前沒有公開資料證明已整合至 Nvidia 的 Cosmos、AlpaSim 或 NuRec 現有商業開發流程。

模型方面,Nvidia 的 Alpamayo 2 Super 採用 320 億參數的推理核心,配合約 20 億參數的動作生成模組,完整模型約有 340 億參數。這套模型主要供雲端開發及訓練使用,車廠仍要透過模型蒸餾等方法,建立適合車載晶片運行的小型模型。

其他廠商亦開始開放自動駕駛技術。小米於 5 月發布 XiaomiOneVL,將 VLA、世界模型及隱空間推理結合,並公開模型權重、訓練及推理程式碼。方案以 Qwen3-VL-4B 為基礎,採用 Apache 2.0 授權,相關基礎模型及組件則須遵守各自授權條款。

小米表示 OneVL 在 ROADWork、Impromptu 及 Alpamayo-R1 等研究測試取得領先成績。小米選用 Nvidia 公開的 Alpamayo-R1 測試基準作比較,亦顯示 Nvidia 的開源研究成果已成為業界參考。不過,研究測試成績不能直接代表量產車輛的道路安全水平。

開源亦有不同層次。有些項目公開模型權重,有些提供完整自動駕駛軟件框架,但公開程式碼不代表已經完成量產驗證。

開源項目 公開內容 主要授權 車載使用情況
Nvidia Alpamayo 2 Super 模型權重、推理程式及開發工具 權重 OpenMDW-1.1;程式碼 Apache 2.0 主要供雲端開發,車載應用需建立較小模型
小米 OneVL 模型權重、訓練及推理程式碼、技術報告 Apache 2.0,須遵守基礎模型授權 研究框架,未等同完成量產認證
Autoware 自動駕駛感知、規劃及控制軟件 Apache 2.0 可整合至車輛,仍須完成安全驗證
百度 Apollo 自動駕駛軟件及開發框架 Apache 2.0 開源版本不等同蘿蔔快跑商業系統
comma.ai openpilot 輔助駕駛程式碼 主要為 MIT 針對駕駛輔助,不屬 L4 無人駕駛系統

這些方案不能單憑模型大小或開源程度比較優劣。車廠仍要考慮數據是否容易取得、授權條件、整合工作量及長期維護安排。

外購整套方案還是自研 各車廠選擇不同路線

除了開源技術,車廠亦可選擇採購成熟方案,或自行開發核心晶片及軟件。

華為乾崑提供智能駕駛、座艙及其他汽車軟硬件方案,合作模式包括整套系統合作及部分組件採購。2026 年 4 月 23 日推出的 ADS 5 採用 WEWA 2.0 架構。車廠可以減少部分自行開發工作,但系統升級及功能差異化亦須配合供應商的產品安排。華為目前的商業智駕系統並非開源。

地平線則提供晶片、開發工具及智能駕駛軟件,產品涵蓋基礎輔助駕駛至高階市區導航輔助駕駛。其方案讓車廠選擇不同程度的軟件開發和系統整合,亦可透過中央運算設計減少硬件成本。

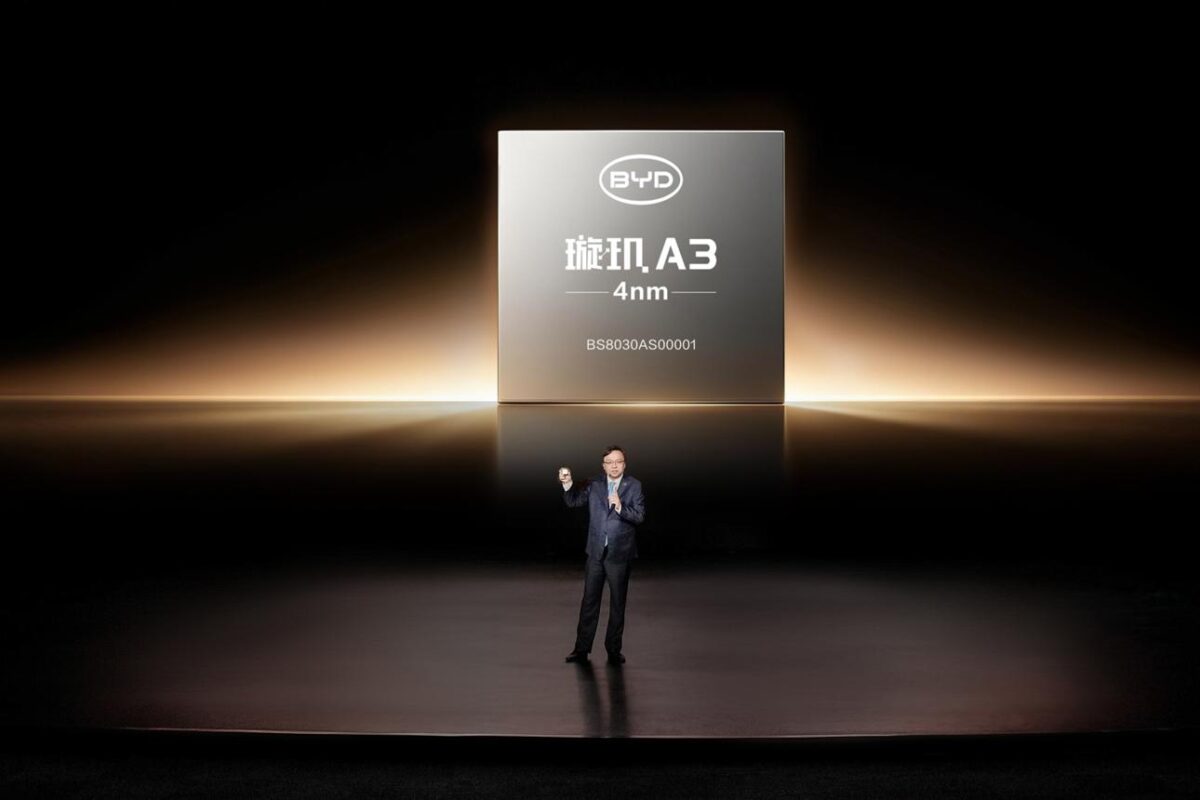
另一條路線是自研。比亞迪於 5 月 28 日公布 4nm「璇璣 A3」晶片,官方披露以三片晶片協同運算,總算力逾 2,100 TOPS。Tesla 長期自行設計 FSD 運算晶片,小鵬亦已將自研「圖靈」晶片應用於量產汽車。自研讓晶片與自家軟件更緊密配合,但需要持續投入晶片設計、軟件研發及安全測試資源。

▲ 比亞迪於 2026 年 5 月公布自研 4nm「璇璣 A3」晶片,公司表示三片晶片協同運算,總算力逾 2,100 TOPS。

Nvidia Hyperion 亦已取得部分 L4 開發項目。根據 Nvidia 3 月公布的合作資料,比亞迪、吉利及日產正採用 Hyperion 平台發展具備 L4 自動駕駛能力的車輛;五十鈴則與 TIER IV 合作,採用 DRIVE AGX Thor 開發 L4 巴士。Uber 計劃由 2027 年起逐步擴大自動駕駛車隊,長期目標為 10 萬輛,當中包括與 Nvidia 及其他合作夥伴共同開發的車輛。

市場數據反映各方案仍有不同定位。高工產業研究院(GGII)的 2025 年統計顯示,Nvidia 在內地市區導航輔助駕駛(NOA)運算晶片市場佔 49.36%。

另一份由高工智能汽車研究院公布的 2026 年上半年數據,則顯示內地品牌私家車全等級智能駕駛晶片市場,地平線佔 31.94%,Nvidia 佔 29.38%。兩組數據涵蓋的產品等級及統計期間不同,不能直接視為 Nvidia 市場佔有率下跌。

▲ Nvidia Cosmos 世界模型可配合 Omniverse 建立不同道路與光線條件的合成場景,協助車廠擴充 AI 訓練及仿真測試資料。

車廠選平台須計長遠成本 安全認證與後續維護同樣重要

車廠選擇下一代自動駕駛方案,應比較四個方面:安全認證是否符合目標市場要求、每輛車完整硬件成本、開發和維護所需資源,以及日後能否更換晶片或軟件供應商。

Nvidia 提供由雲端訓練至車載運算的開發工具,華為提供整套系統及部分組件合作,地平線強調整合運算與量產成本,而大型車廠則逐步增加自行設計晶片的比例。開源模型亦提供更多研發選擇,但各方案的安全驗證、軟件維護和實際成本仍須個別評估。

隨着內地 L3/L4 安全新規明年生效,車廠需要及早決定硬件架構及軟件開發路線。選擇整套供應商方案,可以減少部分前期研發工作;自行開發則能保留較多技術控制權,但亦須承擔持續研發及安全驗證的開支。對準備推出高階自動駕駛車款的廠商而言,這些長期投入將直接影響產品成本及量產時間。


閱讀文章
IT 基建人工智能微電子業

AI 伺服器搶電路板產能 部分 PC 訂單等 30 個月、2027 年換機恐難降價

伺服器主板與擴充卡在機房中,帶量測光影效應與冷卻風扇.

計劃在 2027 年更換公司電腦的 IT 團隊,可能要為交貨時間預留更多空間。印刷電路板(PCB)製造商正把部分產能轉向利潤較高的 AI 伺服器訂單,桌面電腦、手提電腦及顯示卡的電路板供應因而受壓,部分訂單交貨期長達 30 個月。AI 硬件需求的影響已擴展至電路板;即使 PC 需求轉弱,電腦和顯示卡也未必容易降價。

PCB 產能轉向 AI 伺服器,部分訂單等 30 個月

據《日經亞洲》報道,HP 和 Dell 等 PC 廠商規劃 2027 年產品時,已擔心未能取得足夠電路板。原本用於桌面電腦主機板、手提電腦主機板及顯示卡 PCB 的部分產能,正逐步轉往 AI 伺服器。

一名美國 PC 廠商管理人員表示,即使預計明年全球 PC 出貨量可能繼續下降,公司仍難以取得足夠 PCB,可見 PC 需求轉弱未必能減輕 AI 伺服器對產能的競爭。一家供應商指,相當部分產品的交貨期已增加一倍;另一家公司則表示,現在提交的新訂單預計要到 2028 年下半年才能交付,部分訂單交貨期更達 30 個月。

覆銅板價格據報達 7 月的 12 倍

供應壓力亦延伸至 PCB 的主要材料覆銅板(CCL)。一家台灣 PC 廠商表示,覆銅板價格至少已達今年 7 月的 12 倍,惟這只是單一廠商的說法,不代表所有規格都有相同升幅。

全球其中一家主要覆銅板供應商的訂單已排到 2030 年;該公司計劃在 2028 年前把產能擴大至現時 3 倍,但積壓訂單仍然龐大。另有報道指 PCB 業相關技術職位薪酬已上升 20% 至 30%,增加擴產成本。即使供應商擴產,亦未必能及時紓緩 2027 年的供應壓力。

短缺波及醫療設備,顯示卡零售價亦高企

電路板短缺的影響已超出電腦市場。Canon 表示,AI 帶動的電路板及相關零件短缺,令公司部分生產活動自今年 8 月起受限,並預計今年醫療設備業務銷售額因此損失約 900 億日圓(約港幣 44.9 億元)。

顯示卡方面,外國傳媒報道,Nvidia GeForce RTX 5080 在美國部分零售渠道的售價已接近 2,000 美元(約港幣 HK$15,600),遠高於原本建議零售價。Newzoo 市場情報主管 Emmanuel Rosier 亦指出,PC 硬件價格上升的壓力與數據中心及 AI 企業的持續需求有關。

2027 年換電腦,IT 團隊宜提早排期

截至發稿時,未有 PC 廠商公布具體零售價調整幅度。研究機構 Gartner 早前預測,由於記憶體及其他關鍵零件成本上升,到 2028 年售價低於 500 美元(約港幣 HK$3,900)的 PC 可能逐漸消失。再加上 PCB 供應受壓,PC 和顯示卡的降價空間可能進一步收窄,2027 年購買電腦亦可能遇到較高價格或較長供貨時間。

IT 團隊可在安排設備更新時預留較長交貨時間,並按工作需要決定更換次序。顯示卡 PCB 產能正被轉走,Gartner 亦預測低價 PC 可能逐漸消失,因此需要 GPU 的工作站及入門級手提電腦可考慮提早排期。同時檢視現有設備的使用年期和維修安排,有助減少一次過大批更換時遇上缺貨的風險。

來源:Nikkei Asia、cnBeta.COM

閱讀文章
IT 基建企業趨勢微電子業

Marvell 傳洽購市值 830 億美元 Lumentum AI 光連接供應或更集中

Marvell 科技園區大樓外觀與花卉景觀.

據知情人士透露,AI 晶片商 Marvell 正與資料中心光學元件商 Lumentum 進行收購的進階洽談,交易預計全以股票支付,最快下星期宣布,惟雙方暫未證實。消息傳出前,Lumentum 市值約 830 億美元(約港幣 6,474 億元)。對規劃 AI 算力的團隊來說,伺服器以外的連接元件同樣會影響擴建安排:AI 叢集內的 GPU 連線正由銅線轉向光連接,有報道指光學元件產能已成擴建樽頸。

交易若成,晶片與雷射歸 Marvell 一家

Marvell 設計光學訊號處理(DSP)晶片及訂製晶片,為 AI 電腦之間的高速通訊提供技術;Lumentum 則供應雷射、光偵測器和調變器等光學元件。如果交易成事,訊號處理晶片和光學零組件將歸同一家公司。

雙方早已有技術合作。今年 3 月的光通訊展覽 OFC 上,Marvell 與 Lumentum 示範 Marvell 光學 DSP 與 Lumentum R300 光路交換(OCS)平台互通運作。Marvell 在 2025 年 12 月亦同意以 32.5 億美元(約港幣 253.5 億元)現金加股票,收購光子技術初創 Celestial AI;若達成收入里程碑,交易總值可達 55 億美元(約港幣 429 億元)。

今次潛在交易的規模可能大得多:消息傳出前的 10 月 28 日收市時,Lumentum 市值約 830 億美元,Marvell 約 2,210 億美元(約港幣 17,238 億元)。不過市值並非交易價格,洽購的確實條款尚未公開。

銅線轉光連接,光元件產能據報排到 2029 年

AI 運算叢集不斷擴大,GPU 之間的連線正逐步由銅線轉向光連接。有分析指光學技術及產能已成 AI 基建擴建的樽頸,交易若成事,Marvell 可取得更多相關技術及產能。

Lumentum 行政總裁 Michael Hurlston 據報表示,需求令公司 AI 光學元件的產能售罄期由原先估計的 2028 年延至 2029 年。公司業績亦增長迅速,2026 財年收入約 30.14 億美元(約港幣 235.1 億元),按年增長 83.2%;第四財季收入約 10.1 億美元(約港幣 78.8 億元),按年增長 109%。

Lumentum 預期 2027 財年第一季收入介乎 12.25 億至 12.75 億美元(約港幣 95.6 億至 99.5 億元),並預計於 11 月 5 日公布該季業績。

Nvidia 既是股東又是客戶,合併或惹中立疑慮

Nvidia 今年 3 月以 20 億美元(約港幣 156 億元)購入 Lumentum 可轉換優先股,同時是其主要客戶,向 Lumentum 購買雷射用於共封裝光學產品。若 Marvell 收購 Lumentum,便會擁有 Nvidia 依賴的主要雷射供應來源。

有分析指合併可能令客戶擔心供應商不再中立,亦可能引來監管審查。市場對洽購消息的反應有分歧:Marvell 股價在 10 月 29 日常規交易跌約 12%;Lumentum 股價同日盤中最多升約 5%,其後回落。

光元件供應集中,自建算力要預留交貨期

Lumentum 管理層已表示產能售罄期延長,若晶片與雷射供應再進一步集中,規模較小的客戶在供應及議價上的空間可能受影響。惟這仍取決於交易能否成事,以及合併後的供應安排。

規劃 GPU 叢集或擴建機房的團隊,可把光模組及光纖連接與伺服器同步排期,並在網絡架構上保留兼容不同光模組來源的空間,以減低單一來源延誤可能帶來的影響。Lumentum 的業績及雙方其後是否正式公布交易,可作為觀察供應情況的線索;排定算力投入服務的時間時,連接元件也要放進同一張時間表。

來源:Reuters、Bloomberg、Marvell Technology, Inc.

閱讀文章
微電子業業界消息

Intel 與 AMD 宿敵探合作 14A 製程進度成代工客戶評估關鍵

高性能處理器晶片在科技工作臺上散發藍橙光效.

Intel 行政總裁陳立武(Lip-Bu Tan)日前在華美半導體專業協會(CASPA)的爐邊談話中透露,已與 AMD 董事長兼行政總裁蘇姿丰(Lisa Su)交流,討論未來可能合作的領域,但沒有披露具體方向。他同時表示 Intel 會全力爭奪 CPU 效能領導地位,並稱 14A 製程不久將發布 0.9 版製程設計套件(PDK)。這番表態顯示 Intel 願意一邊與 AMD 競爭,一邊探索合作,但對 PC 及晶片市場的影響仍取決於合作內容。

Intel 與 AMD 探討合作,CPU 競爭照常

據 cnBeta.COM 報道,這次交流涉及雙方未來可能合作的領域,但陳立武沒有交代具體項目、協議或時間表,截至發稿時亦未見 AMD 方面確認。陳立武同時強調 Intel 會繼續爭奪 CPU 效能領導地位,換言之,探討合作並不代表兩家公司在處理器產品上停止競爭。

對企業而言,目前可掌握的資料只是雙方曾討論合作,未足以判斷會否改變 PC 或伺服器處理器的競爭。企業比較 Intel 與 AMD 方案時,暫時毋須單憑這次交流改變採購做法;合作會涉及哪類業務,仍要等待具體公布。

Intel 代工業務令對手也可能成為客戶

要理解 Intel 與競爭對手合作的可能性,可以先看其業務模式:Intel 除了設計及銷售自家處理器,亦經營晶圓代工,替其他晶片公司生產晶片。不過這只能說明 Intel 如何與其他公司建立商業關係,不能據此推斷 AMD 今次洽談涉及代工。

投行 KeyBanc 的渠道調查報告指,Intel 已取得為 Broadcom 生產網絡交換晶片、為 Google 生產伺服器 CPU 的代工訂單;Microsoft 伺服器處理器及 Nvidia 遊戲 GPU 據稱亦將交由 Intel 代工,惟相關公司尚未確認這些說法。KeyBanc 亦認為 Apple 已與 Intel 達成採用 14A 製程、涵蓋多代 M 系列及 A 系列晶片的長期代工協議,但雙方均未證實。

若上述代工安排屬實,Nvidia 等在部分產品市場與 Intel 競爭的公司,也可能成為 Intel 的代工客戶。可見 Intel 的產品業務與代工業務可以各自建立不同關係,但這不足以證明 Intel 與 AMD 會採用同類合作模式。

14A 將推新版 PDK,量產仍須分階段

代工業務能否吸引外部客戶,亦要看製程進度。陳立武稱 18A 已進入量產;下一代 14A 目前已有 0.5 版 PDK,不久將發布 0.9 版,並計劃明年初推出支援正式量產的 1.0 版 PDK。這些屬 Intel 對自身開發進度的說明,並非宣布 14A 已開始量產。

報道引述的業內解讀認為,0.9 版 PDK 通常代表製程已具備流片(Tape-Out,即把晶片設計交付生產)能力,可進入風險試產階段;但這項解讀不等於 Intel 已宣布 14A 進入風險試產。對考慮委託 Intel 生產晶片的客戶而言,PDK 版本進展是評估製程成熟度的線索,仍要與實際試產及量產進度分開看待。

來源:Semiconductor Insider

閱讀文章
初創企業微電子業業界消息

中國初創展示國產 EUV 光源 90% 零件本土化、商用最快仍需 3 年

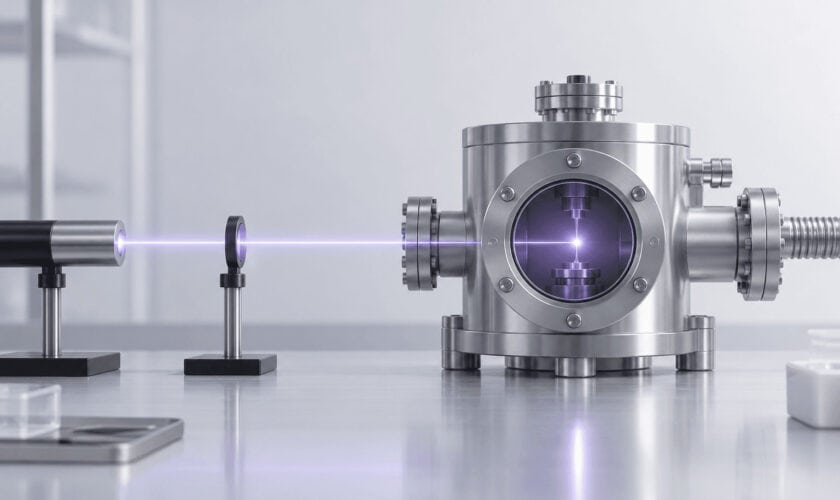
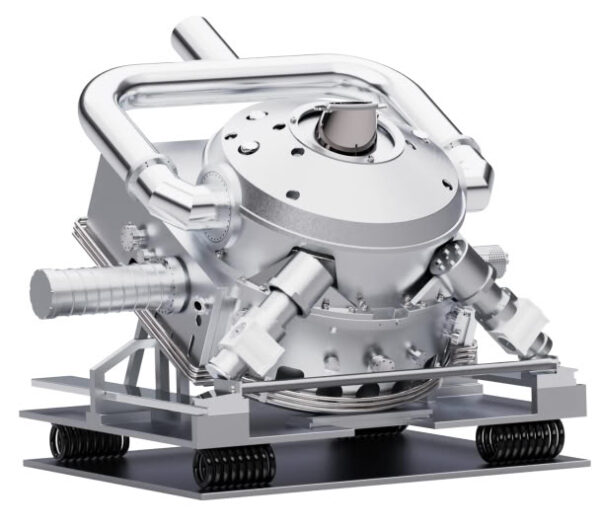
高科技EUV光源設備,展示國產化進程.

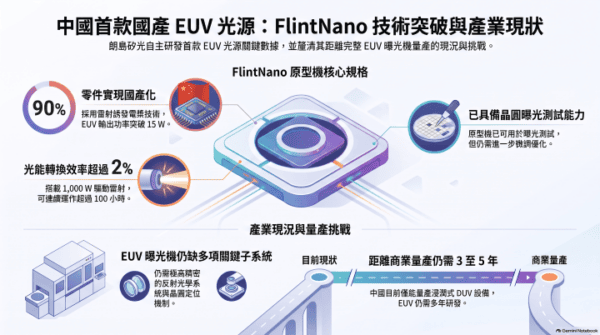
中國半導體初創企業朗道燧岩(Langdao Silex)近日於上海舉行的第 26 屆中國國際工業博覽會,展示自主研發的極紫外光(EUV)光源原型機 FlintNano LPP-OXXO。公司聲稱設備約 90% 零件實現本土化,EUV 輸出功率超過 15W,並具備連續運作超過 100 小時的能力。不過公司預計,光源技術距離商業化量產仍需 3 至 5 年,而研發成功亦不代表中國已掌握完整 EUV 光刻機技術。

採用與 ASML 相同技術路線 輸出功率超過 15W

朗道燧岩於 2024 年成立,研發團隊與清華大學氣體放電及等離子體實驗室有關,專注開發半導體曝光設備所需的 EUV 光源。公司選用雷射產生電漿(Laser Produced Plasma,LPP)技術,與荷蘭 ASML 現有商用 EUV 設備採用的基本光源技術路線相同。LPP 技術透過高功率雷射照射微小金屬液滴,產生高溫電漿,再釋放波長約 13.5nm 的極紫外光。晶片製造商利用這種波長極短的光線,將精細電路圖案轉移至晶圓表面,是現代先進半導體製程的重要技術。

根據公司公布的規格,FlintNano LPP-OXXO 配備 1,000W 驅動雷射,重複頻率介乎 1kHz 至 20kHz,能量轉換效率超過 2%,EUV 輸出功率達 15W 以上。設備產生的電漿直徑約 60 微米,電漿穩定度為 3% RMS,EUV 輸出功率穩定度約 5%。公司亦聲稱設備能夠連續運作超過 100 小時,目前性能可支援晶圓曝光實驗。不過上述數據主要來自企業公布的技術規格,尚未有足夠獨立測試資料確認其長時間運作表現。

國產化率達 90% 仍未達先進晶片量產要求

據《南華早報》引述中國傳媒報道,朗道燧岩表示原型機約 90% 零件已實現本土化,大部分核心零件亦由公司自主研發。這項進展反映中國企業正嘗試建立本地 EUV 關鍵零件供應鏈,減少對海外設備技術的依賴。不過 90% 屬於企業公布的零件國產化比例,現有資料未清楚交代計算方法,因此不能直接理解為整套設備有 90% 技術完全自主可控。

更重要的是,原型機現時只有超過 15W 的 EUV 輸出功率,與商業化先進晶片生產所需的數百瓦級光源仍有明顯距離。ASML 早年已在商用 EUV 設備採用 250W 級光源,以滿足晶圓廠對產能及曝光速度的要求。另一方面,朗道燧岩公布的 15W 數據,尚未清楚證明是否與 ASML 在相同光學量測位置取得。EUV 光線在收集及傳輸過程中會出現損耗,因此不能單純比較兩個功率數字,就判定實際晶圓曝光性能差距。

完整光刻機仍有技術門檻 ASML 優勢未受直接威脅

EUV 光源雖然被視為光刻機的核心零件,但一部可以投入商業生產的 EUV 設備,還需要極高精度的反射光學系統、晶圓定位平台、光罩系統、污染控制及多個子系統整合。當中任何一環未能達到要求,都可能影響曝光精度、良率及產能。中國晶片製造商目前無法向 ASML 採購 EUV 光刻機,主要依靠深紫外光(DUV)設備配合多重曝光技術,生產部分先進製程晶片。這種方式雖然可以突破部分製程限制,但同時增加曝光步驟及製造複雜程度。

朗道燧岩目前公布的時間表,是預計再經過 3 至 5 年研發及改進,才有望推動 EUV 光源商業化量產。這並非完整 EUV 光刻機的交付時間,亦未有資料證明相關光源已經完成與量產級晶圓曝光設備整合。對中國半導體設備供應鏈而言,今次成果顯示本土企業正在推進 EUV 光源研發,但能否擴大輸出功率、維持長期穩定運作,以及配合其他高精度零件組成完整系統,仍是技術進入晶圓廠前必須克服的問題。


資料來源:
TechNews 科技新報
South China Morning Post
Wccftech

閱讀文章
人工智能企業趨勢微電子業業界消息

Intel、AMD、Arm 三強爭霸:AI 時代的伺服器 CPU 市場誰主浮沉?

三款伺服器處理器芯片展示,展現先進的計算技術.

AI 代理正改變伺服器 CPU 市場的需求結構,CPU 不再只是支援 GPU 的通用元件,逐漸成為協調模型、記憶體、儲存及網絡資源的控制層。美銀最新將 2030 年伺服器 CPU 總可尋址市場上調至逾 2,100 億美元,較先前約 1,700 億美元的估計提高約 24%,反映企業 AI 工作負載正由模型訓練延伸至多步推論與自動化執行。

AI 代理令 CPU 成為協調中樞

過往的生成式 AI 投資重點集中在 GPU,因為訓練大型模型需要大規模平行運算。不過,AI 代理需要持續理解指令、調用工具、檢索資料、拆解任務、執行多步推論並管理結果,這些流程提高了 CPU 在資料調度與系統協作上的重要性。Arya 認為,AI 代理推論可能使 CPU 與 GPU 的配置,由訓練時代約 1 比 4 朝接近 1 比 1 發展,CPU 亦將由支援角色升格為數據中心的「編排控制層」。

美銀估算,至 2030 年 CPU 可佔整體 2.2 兆美元數據中心系統市場約 10%,高於訓練型 AI 時代約 7% 的比重。這不代表 GPU 需求下降,而是企業在部署 AI 服務時,必須同步投資資料預處理、模型路由、向量資料庫、推論排程及安全管控。換言之,AI 代理帶來的並非單一晶片需求,而是整套伺服器架構的重新分工。

英特爾守營收,AMD 搶高價值市佔

英特爾仍是伺服器 CPU 市場的重要供應商,但 AMD 正透過 EPYC 產品在高階工作負載擴大影響力。Mercury Research 數據顯示,AMD 於 2026 年第一季的 x86 伺服器 CPU 營收市佔率達 46.2%,創歷史新高;其同期出貨量市佔率為 33.2%。兩個指標的落差反映 AMD 產品平均售價較高,亦代表其滲透的主要是雲端、企業與高效能運算等較高價值部署。

英特爾約 67% 的伺服器 CPU 市佔數字,來自另一項市場統計口徑,不能與 AMD 的 46.2% 營收市佔直接相減或比較。正確的解讀應是:英特爾仍擁有龐大客戶基礎與軟件生態,AMD 則正在高單價 x86 產品提升營收佔比。財務數據同時顯示兩家公司均受惠於數據中心需求:英特爾第二季 Data Center and AI 部門營收 63 億美元,按年增長 59%;AMD 數據中心營收 67 億美元,按年增長 107%,增長動力包括 EPYC 處理器與 Instinct GPU。

AMD 董事長兼行政總裁蘇姿丰在近期技術論壇中表示,公司已把 2030 年伺服器 CPU 市場機會上調至 2,200 億美元,並預期代理型工作負載約佔其中三分之二。AMD 更訂下在該擴大市場取得逾 50% 營收市佔的目標。這屬於企業策略與管理層展望,並非獨立機構的預測;但它說明 AMD 正把競爭焦點由單一 CPU 規格,延伸至 CPU、GPU、網絡與整機櫃方案的整合能力。

Arm 擴張考驗 x86 生態韌性

Arm 是伺服器 CPU 市場中最具結構性影響的挑戰者。美銀預測,至 2030 年 Arm 架構 CPU 可佔伺服器 CPU 價值約 47%,其中約 38% 來自商用晶片,約 9% 來自客戶自研設計;英特爾與 AMD 的價值佔比則分別估計為 22% 及 31%。這是分析師的長期情境模型,應與實際出貨量、市佔率及裝機數量區分看待。

不過,Arm 在 AI 基礎設施的實際影響力已見提升。IDC 指出,2026 年第一季全球 AI 基礎設施支出達 897 億美元,並預測全年可達 4,970 億美元;該機構同時觀察到,Arm 架構的加速伺服器支出已超越 x86 加速伺服器。Arm 行政總裁 Rene Haas 表示,公司已由 IP 授權延伸至完整晶片產品,推出面向 AI 工作負載的 Arm AGI CPU。

然而,Arm 加速伺服器支出領先,不代表 x86 在所有企業伺服器工作負載中已失去優勢。企業既有應用程式、虛擬化環境、維運工具與開發人員習慣,仍使軟件相容性成為採購決策的核心。

採購重點轉向系統效率

AI 代理的普及將令伺服器 CPU 市場由傳統周期性升級,轉向以數據中心系統效率為核心的競爭。英特爾必須將既有生態優勢轉化為產品與供應穩定性;AMD 需證明高階產品市佔能夠延續;Arm 則要把加速伺服器的增長動能,擴展至更廣泛的企業軟件環境。

資料來源:Bank of America/Investing.com AMD Investor Relations IDC Arm Newsroom

閱讀文章
人工智能企業趨勢微電子業

台積電 1.4nm 新廠建設進度超前 最快 2027 年第三季試產

台積電新廠晶片製造進展,展示先進半導體製程技術.

台積電 1.4nm 新廠「晶圓 25 廠」建設進度超前,第一座廠房預計明年 4 月前完工,最快明年第三季初進入試產階段,量產時程可望於 2028 年下半年如期達成。

此案位於中科台中二期園區,新廠基地代號「晶圓 25 廠」,規劃設立四座廠房,前兩座已完成發包,由達欣工程與互助營造得標,目前已進入鋼構施工階段。台積電加速布局 1.4nm(A14)先進製程以搶佔市場先機,而三星同期則維持將同代製程量產時程延後至 2029 年的既定策略。財務數據顯示,新廠初估總投資金額高達 490 億美元(約港幣 3,822 億元),預期營業額可望超過 154 億美元(約港幣 1,201.2 億元),並創造 8,000 至 10,000 個工作機會。

建廠進度超前背後的技術

台積電中科新廠工程進度持續加快,供應鏈消息指出,第一座廠房的試產時程有望提前至 2027 年第三季初,較原訂計畫更為積極。多家台灣財經媒體引述供應鏈人士表示,此案基礎打樁作業已大致完成,主廠房招標工作即將啟動,整體工程「進度超前」。若工程持續依現有節奏推進,第一座廠房可望於 2028 年下半年正式進入量產階段,自由財經、工商時報及今周刊等台灣本地財經媒體均有相關報導。業界分析指出,晶圓 25 廠採用第二代 GAA(環繞閘極)奈米片電晶體技術,相較於現行 N2(2nm)製程,A14 在同等功耗下速度可提升約 10% 至 15%,功耗降低約 25% 至 30%,電晶體密度提高約 20% 至 23%。

A14 製程重塑先進晶片競爭

台積電規劃四座廠房中,前兩座專攻 1.4nm 製程,第二期兩座則不排除進一步推進至 1nm(A10)製程,顯示公司對未來十年先進節點的長期部署。A14 初期版本並不配備背面供電功能,台積電規劃於 2029 年推出搭載 SPR(超級電源軌)背面供電技術的 A14P 進階版本。半導體分析人士指出,這種分階段導入新技術的策略,能讓台積電在控制風險的同時,持續維持製程領先地位,確保客戶對其先進節點的信賴度。相較於行業普遍將 1.4nm 視為 2020 年代末期的技術分水嶺,台積電選擇提前卡位,反映其對高效能運算與 AI 晶片需求增長的樂觀預期。

三星延後量產凸顯良率壓力

與台積電積極擴產形成對比,三星電子已將 1.4nm 製程量產時間從原訂 2027 年二度延後至 2029 年,轉而優先提升 2nm 製程良率。三星在今年 SAFE 論壇上重申 2029 年量產目標維持不變,並同步推出強化版 SF1.4+ 節點,規劃於 2030 年推出。最新業界報告顯示,三星 2nm 良率已從 2025 年下半年約 20% 大幅回升,截至今年 4 月約達 50% 至 55%,逐步逼近業界普遍認定的 60% 量產穩定門檻,但仍落後台積電同代製程約 10 個百分點。

建廠時程演變與產業對比脈絡

回顧時間軸,台積電於 2025 年 7 月完成中科二期用地交地程序,同年 8 月大型營造廠陸續接獲相關工程招標案。進入 10 月,台積電正式取得建照並啟動動土儀式,開始基礎打樁工程。今年 7 月,DigiTimes 報導確認 A14 製程開發進展順利,未出現重大技術瓶頸,預計 2027 年啟動風險試產,並於 2028 年正式量產。相比之下,三星的 1.4nm 時程則呈現反向軌跡:從最初規劃的 2027 年,歷經兩次延後,最終定案於 2029 年。這種一快一慢的對比,反映兩大晶圓代工巨頭在資源配置與風險管理上的不同哲學——台積電選擇以速度確保市場獨佔性,三星則優先確保製程穩定性後再全力衝刺。


資料來源:cnBeta.COM、DigiTimes、自由財經、工商時報、今周刊


閱讀文章