close

雲端服務

中小企雲端專區

Ruijie Cloud 一站式雲端管理系統 支援手機 APP、Web GUI

近年,網絡雲端管理發展起來,各大網絡品牌都有自家的雲端管理系統,加速了雲使用的步伐。但現在大部分品牌都只有特定系列產品才能夠支援雲端管理,有的品牌雲端管理就功能並不齊全,又或者 License 的年費太高,中小企業難以負擔。巿場上還有什麼品牌可以給用家選擇呢?以下介紹的 Ruijie Cloud 網絡雲端管理系統,是少數向中小企巿場支援全企業級功能的網絡雲端系統。
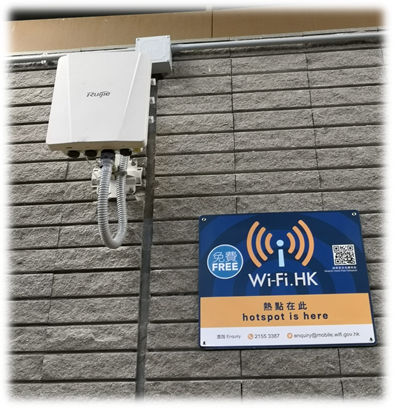
▲ Ruijie Wi-Fi


企業級品牌 知名網絡供應商

網絡品牌供應商 Ruijie 為商用企業提供網絡解決方案,除商用巿場外,政府 Wi-Fi.HK 和眾多的 NGO 也有選用 Ruijie 產品,全港亦有超過 400 間中小學正採用 Ruijie 網絡方案。上年度 Ruijie 便推出了針對中小企業巿場的牌子 — Reyee,產品質量維持高水平兼附設適合中小企使用的企業級功能。


獨家自組網  3 分鐘自動配置設定完成

組裝 Ruijie 產品不會有太大難度,原因是 Ruijie 產品有個獨特功能名叫「自組網 SON : Self-Organizing Network」,只要使用全 Reyee 產品,3 分鐘內可以全部產品自動添加上 Ruijie Cloud,包括 Router、Switch、Gateway 和 Access Point。往後的功能設置亦都會自動套上設備上,大幅減少設置時間和所需要的技術門檻。如果設備裡有支援 ONVIF 的 CCTV Camera ,Ruijie Cloud 會自動 discover 並添加上雲端。

以下參考影片展示了 Ruijie 曾經試過不用 3 分鐘就能使用自組網功能去設置全部 150 台 AP

https://www.youtube.com/watch?v=TPCqAD8DR_k
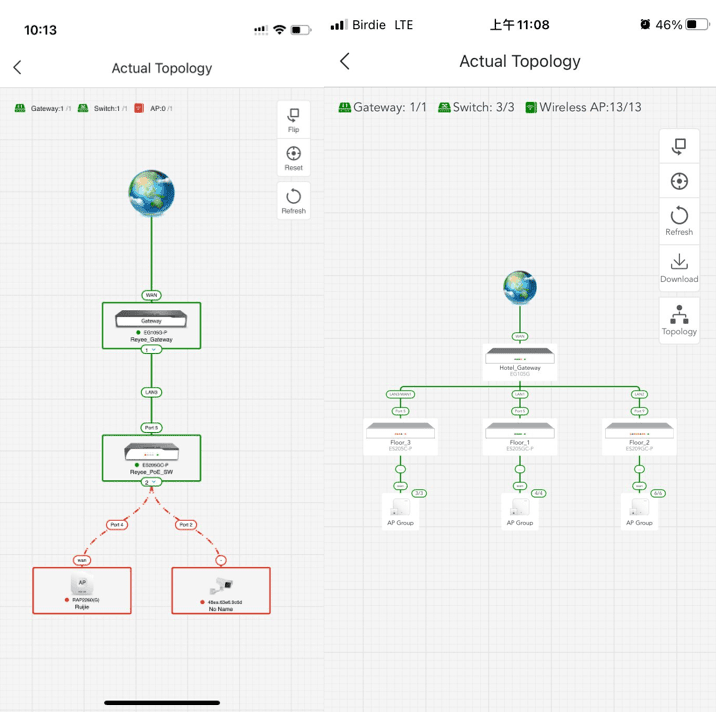
 

▲Ruijie Cloud 自動 discover Reyee 和 Camera,紅色連結代表有問題


手機網絡管理 遙遠設置

企業級的管理系統,由於功能複雜和定位原因,多數需要用獨立軟件或 Web GUI 登入系統去操作,就算有手機 App 也只會提供整體資訊為主 。Ruijie Cloud 給用家驚喜的地方是它的手機 App,除了必有的整體資訊如網絡狀態、設備的使用資料和用家使用量外,更加貼心地提供設備的內裡資訊,比如每一個網埠的連結應用和使用狀況,使管理者可以更快地偵查到每台設備的實際情形。
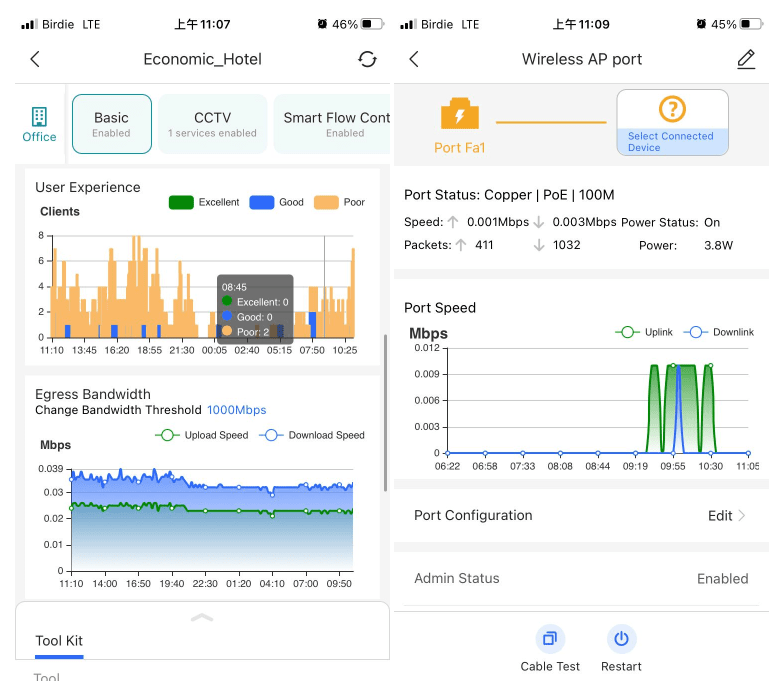
▲ Ruijie Cloud 提供豐富網絡資訊


系統的 alarm system 可以設計不同門檻和組合,當有異常時,就透過 EMAIL 和 App pop up 主動去通知管理者,再進入 App 裡查看設備狀況。App 裡已經有常用的 Wi-Fi 設置,網絡限制等設定,管理者可以於手機 App 內作出即時調整,十分方便。如果項目需要其他技術人員協助管理,亦設有 Share Tenant 功能,可以提供到 Read/Write 和 Read only 的選擇,共同管理項目。
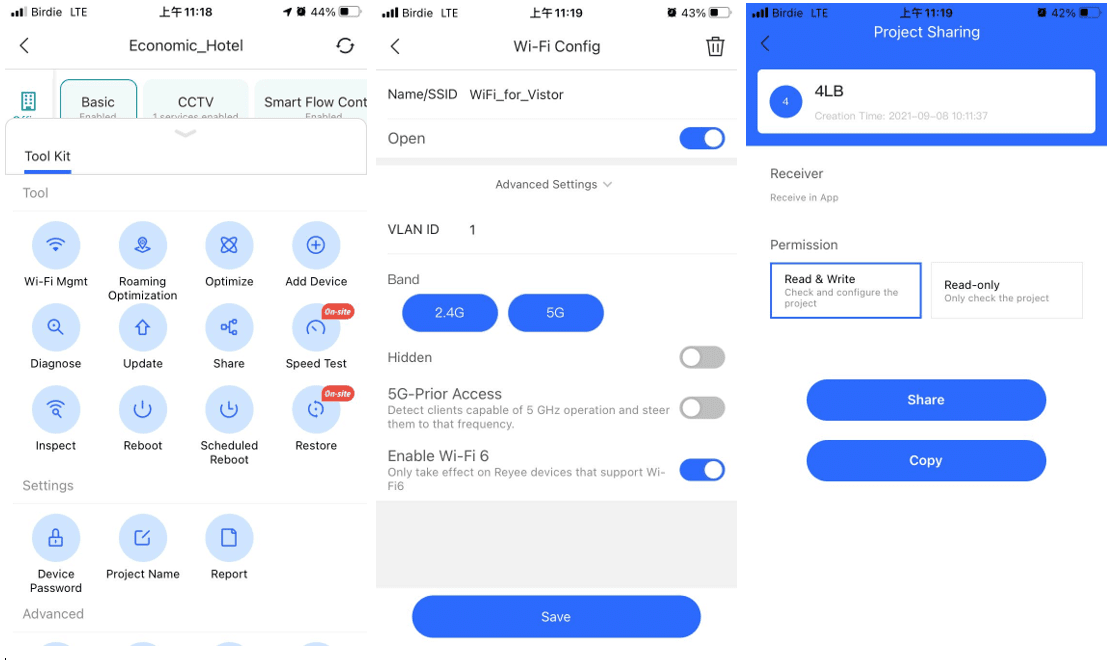
▲ 全面企業級功能


企業功能 節省運維成本

上面已介紹過 Ruijie Cloud 有提供企業級功能讓中小企使用,另外他們有幾個貼地功能,相信不少中小止都有這需求 :

Remote PoE Reboot : 當終端設備如 Wi-Fi 或者 CCTV Camera 有不穩定時,一般的做法是派遣工程司到現場做 onsite inspection,但這樣做的成本十分高昂,而且 8 成的不穩定問題都只需要重啓設備就可以。若果使用 Ruijie Cloud,當管理者知道終端設備有異常時,可以先透過 Cloud 去重啓該設備的網絡電接阜,如果問題解決就可以省郤派遣工程司到現場處理,這樣就更有效率,減省運維成本。


Long Distance : 眾所周知一般 PoE LAN 的傳輸距離限制是 100 米,如果要連接超過 100 米,就需要添加 PoE 交換機,增加運維成本。Ruijie Cloud 有一個 Long Distance 功能,可以把連接阜的傳輸速度限制於 10MB 內,換來達到 200 米的傳輸距離。對於一些有特別距離需求的 CCTV 項目,這功能就會大派用場。


AI Optimization / Diagnose : 網絡不穩定或者異常,有可能是設置問題,也有可能是外在因素影響,但一般情況下,如果没有相關專業知識者或者現場做詳細測試的話,是很難檢測到問題所在。Ruijie Cloud 有一個 AI Optimization 功能,可以一鍵幫助改善設備的配置,比如用大數據分析選擇最暢通的網絡頻普,調較合適的訊號強弱等等。另一個功能是 AI Diagnose,它可以協助你分析從手機直至 Internet 間的連接是否有硬體或者設置異常,並且提供解決建議,尤如一名專業網絡工程師從旁協助。
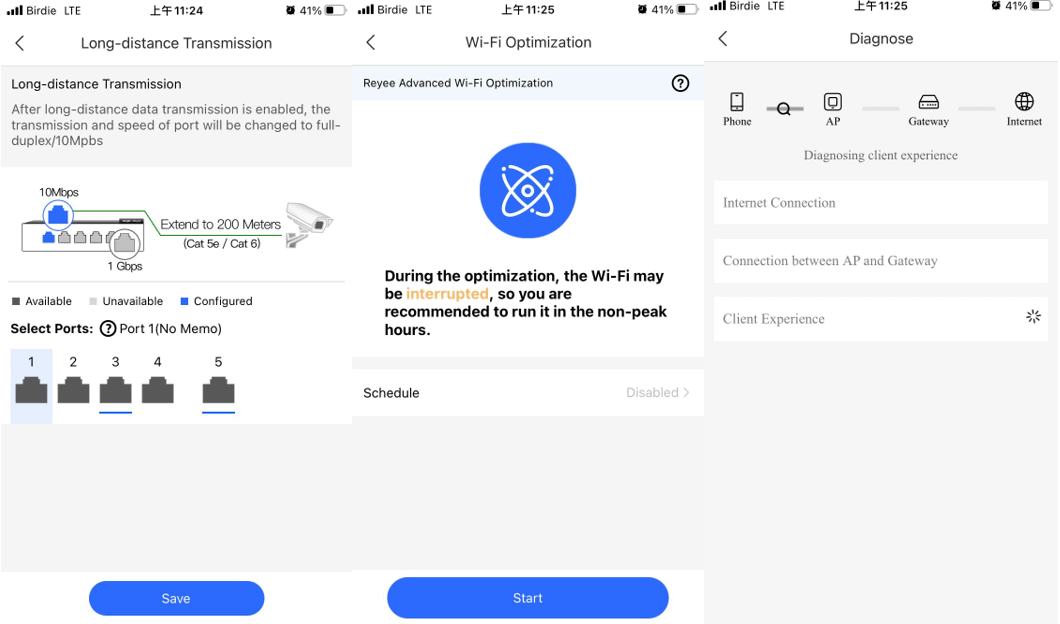
▲ 一鍵偵查和改善系統配置


Ruiji Cloud license 終身免費

很多品牌的雲端管理是需要額外收取 License Fee,每年以 Subscription 型式或者按產品型號和數量去收取費用。而 Ruijie cloud 則向所有客戶提供終身免費設備無上限,和企業級功能的網絡雲端管理系統,這策略十分關顧只用上有限設備的中小企業,幫助他們大大減輕運維成本。
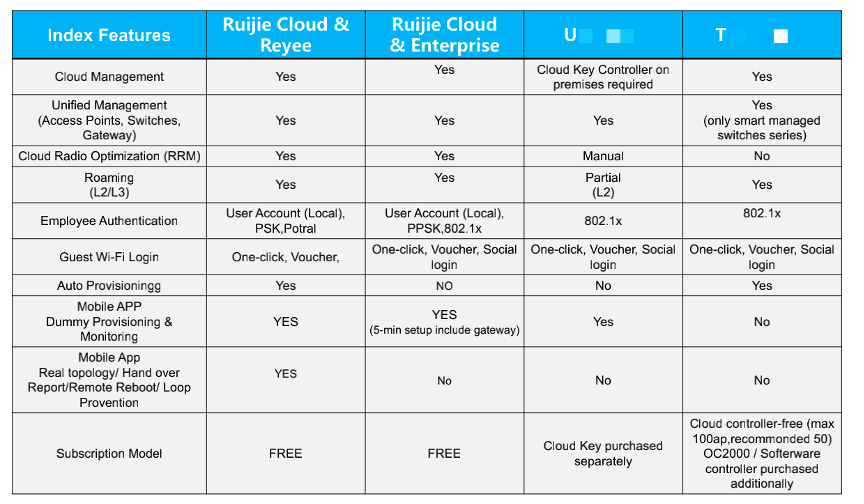
▲ Ruijie Cloud 比巿場對手牌子的雲端有更強大的功能且免費


Google 雲端系統 保證安全性

雲端管理的無間斷服務能力和資料安全一向是大眾關注焦點。香港區所使用的 Ruijie Cloud 是設置於 Singapore Google 內, 已通過 99.99 的認證,另外於俄羅斯亦有設置高可用性解決方案,雲端系統的穩定性有所保證。對於某些行業如酒店和銀行有著高度嚴格的私人條例規範,Ruijie Cloud 亦已經通過歐盟對私隱保障的嚴格需求 (GDPR),客戶不用擔心資料外洩。


總結

有賴於 Ruijie Cloud 的友善介面,產品設置和測試過程都可非常順利,相信網絡新手都能夠輕易掌握。而 Ruijie Cloud 是完全免費和無上限使用,所以中小企業若使用 Ruijie Reyee 產品的話,只需付上硬件費用就能用 Ruijie Cloud,整個配套相當吸引。


測試產品:

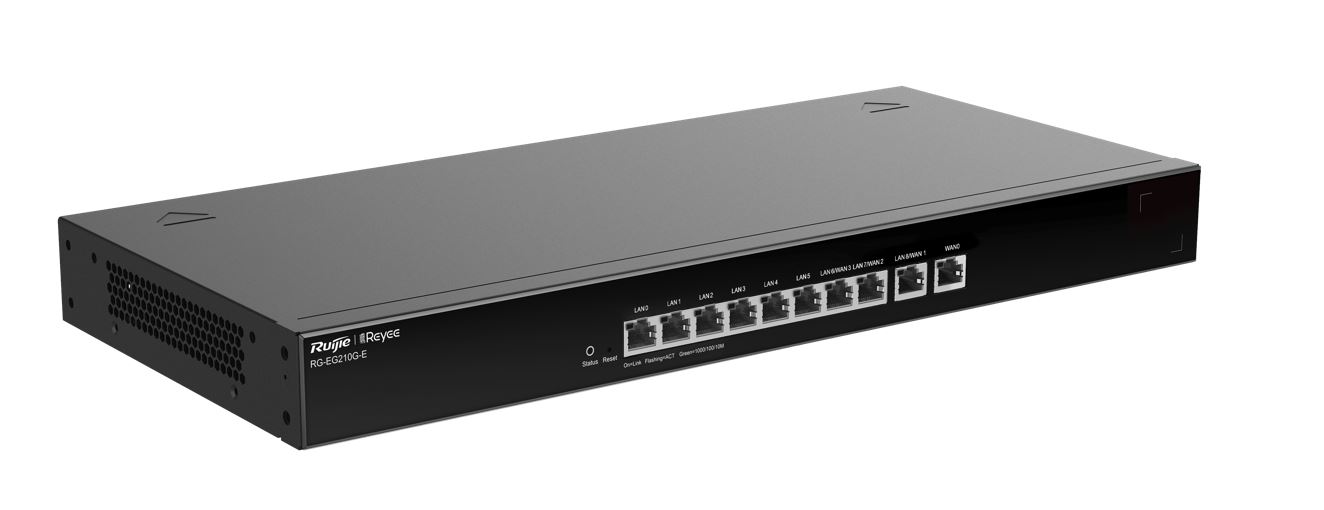
RG-EG210G-E

  • 10 個 Gigabit Port,uplink 1000Mbps
  • 最大支援 200 台設備同時使用
  • 預設 2 WAN,最大支援 4 WAN
  • 預設三個網段
  • 支援網絡流量控制,行為管理
  • 支援 IPSec VPN,DDNS


▲ RG-EG210G-E 全能中小企 Router


RG-ES209GC-P

  • 8 個 Gigabit PoE/PoE+ Port,1 個 Gigabit Uplink Port
  • 120W 最大 PoE 輸出功率
  • 支援 Ruijie cloud
  • 4K MAC 容量
  • 支援 Loop Prevention、Remote PoE Reboot、Long Distance 功能
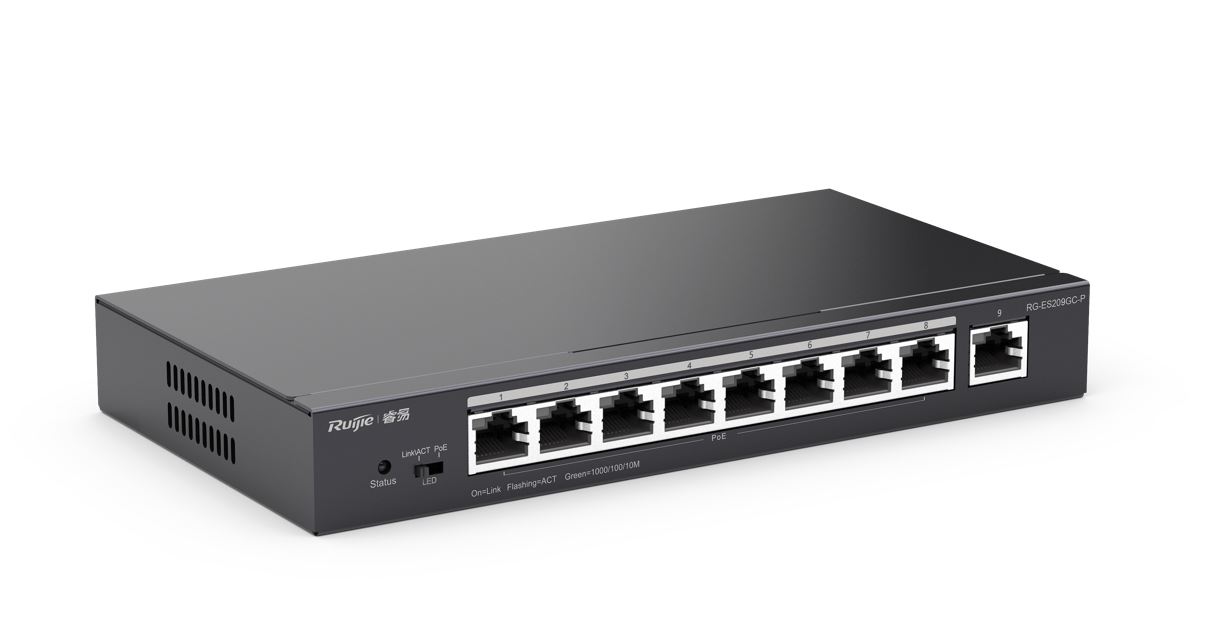


▲ RG-ES209GC-P 高性能交換機


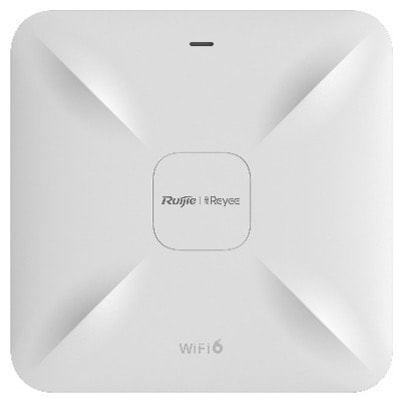
RG-RAP2260(G)

  • 2 個 Gigabit LAN Port
  • AX1800 Wi-Fi 6 ,2×2 MIMO
  • 4G : 574Mbps / 5G : 1201Mbps,共提供 1.775Gbps
  • 內置藍牙 0
  • 支援 Layer 2,3 Roaming


▲ RG-RAP2260(G) 全能中小企 Gateway
 

閱讀文章
IT 基建人工智能雲端服務

Microsoft 退出英國 AI 數據中心計劃 23,000 顆 NVIDIA GPU 部署計劃受阻

現代化數據中心建築,玻璃外牆反映天空與周圍環境.

現代化數據中心建築,玻璃外牆反映天空與周圍環境.

Microsoft 已退出英國 AI 雲端基建公司 Nscale 位於 Essex 郡 Loughton 的大型數據中心項目,終止原定租用 NVIDIA GPU 算力的合作。該項目原定於 2027 年投入運作,但當地電網營運商預計最快要到 2030 年代初至中期才能提供足夠電力。Nscale 表示仍會繼續推動項目,並研究其他供電方案。

原定部署約 23,000 顆 NVIDIA GB300 GPU

Nscale 與 Microsoft 於 2025 年宣布合作建設 Loughton AI Campus,計劃首階段提供 50MW 算力基建容量,日後可擴展至 90MW。按照同年 10 月的合作公告,設施原定於 2027 年首季起部署約 23,000 顆 NVIDIA GB300 GPU,為 Microsoft Azure 雲端服務提供算力。

該計劃亦是 Microsoft 於 2025 年公布、涉及 220 億英鎊的英國整體投資方案其中一部分。英國政府當時將 Loughton 項目列為推動本土 AI 基建的重要發展。

項目進度早已受到質疑。《衛報》於 2026 年 3 月實地調查發現,原定建設數據中心的土地當時仍被用作棚架物料場。Nscale 其後清理場地,但供電問題仍未解決。

電網接駁延後 Nscale 研究自行發電

負責倫敦及英格蘭東南部配電網絡的 UK Power Networks(UKPN)已向 Nscale 表示,當地電網預計要到 2030 年代初至中期才有足夠容量支援項目。這與原定 2027 年投入運作的時間表相差數年。

Microsoft 尚未公開詳細解釋終止合作的原因,但英國媒體及 Reuters 均指出,長期供電延誤是這次退出項目的主要背景。

Nscale 發言人表示,公司仍致力推進 Loughton 項目,正研究其他電力來源、場內發電方案,以及加快電網接駁的可能性。公司亦正評估英國境內其他擴展地點。

早於 2026 年 7 月,已有報道指 Nscale 曾與 Bloom Energy 商討使用固體氧化物燃料電池,在正式電網接駁完成前為數據中心提供電力。不過相關方案仍未確認正式落實。

Microsoft 跨國合作未受全面影響 Nscale 上市計劃添變數

Microsoft 退出的是 Loughton 項目,而非全面終止與 Nscale 的合作。雙方此前已公布涵蓋美國、葡萄牙、英國及挪威的 AI 基建合作,涉及合共約 200,000 顆 NVIDIA GB300 GPU。

Nscale 表示與 Microsoft 的長期合作關係仍然穩固,其他合約未受今次供電問題影響。據《衛報》報道,Microsoft 預計仍會參與 Nscale 位於挪威的數據中心項目。

對 Nscale 而言,失去 Loughton 項目唯一已公開的主要客戶,亦令其美國上市計劃面臨更多不確定性。外媒報道指公司正尋求在紐約上市,目標估值可能達 350 億美元,但相關估值並非已落實的交易價格。

英國數據中心接駁需求急增 監管機構提出改革

Loughton 項目的困境亦反映英國大型數據中心面對的電力基建限制。英國能源監管機構 Ofgem 於 2026 年 7 月公布,當地電力需求接駁申請規模由 2024 年 11 月的 41GW,急增至 2025 年 6 月的 125GW,增長主要由數據中心項目帶動。

Ofgem 已就數據中心接駁改革展開諮詢,提出引入接駁承諾費及更嚴格的項目進度審核,要求發展商提供實際客戶、設備採購和財務能力等證明,以減少缺乏落實基礎的申請長期佔用電網容量。截至目前相關方案仍待最終監管決定。

對採購大型 AI 算力服務的企業而言,Loughton 事件反映預訂 GPU 容量與數據中心能否如期提供服務之間存在實際差距。即使發展商已取得客戶合約及建設資金,電網接駁時間仍可能影響算力交付及相關長期合約的執行。

資料來源:
GIGAZINE、
The Guardian、
Nscale、
Ofgem

閱讀文章
IT 基建資訊保安雲端服務

Broadcom 推 VMware HyperArmor 應對月度修補 ESX 多重認證須另付費

VMware HyperArmor 提供多層防禦以保護ESX免受最新AI攻擊威脅.

Broadcom 宣布推出 VMware HyperArmor,為 VMware Cloud Foundation(VCF)增加虛擬修補、主機程式執行限制及 SSH 多重認證功能,協助企業在測試及部署安全更新期間抵禦攻擊。隨著 VCF 9.1 引入每月 Express Patch 更新機制,企業需要更頻密處理漏洞修補,但 HyperArmor 屬額外付費產品,並未包含在基本 VCF 授權內。


VCF 9.1 改用每月 Express Patch 減輕更新停機影響

Broadcom VMware Cloud Foundation 產品營銷副總裁 Prashanth Shenoy 表示,AI 工具協助發現的軟件漏洞愈來愈多,促使 VMware 加快更新頻率。企業雖然需要盡快修補漏洞,但正式部署前仍須測試更新是否影響現有系統,令 IT 團隊承受更大維運壓力。

VMware 早前公布,VCF 9.1 採用每月發布 Express Patch 的機制,針對重大安全漏洞及軟件缺陷提供更新,管理員可經 VCF Operations 下載及部署,毋須每次等待整套系統的大型版本更新。

更新機制亦加入減少停機的技術,包括可在符合條件下毋須重新啟動主機的 ESX Live Patching,以及縮短 vCenter 更新停機時間的 Quick Patching。不過並非所有更新都適用於 Live Patching,涉及主要版本或驅動程式修改的更新,仍可能需要傳統維護模式。

HyperArmor 虛擬修補先阻擋攻擊 毋須等待正式補丁

HyperArmor 主要針對 VMware ESX 虛擬化管理層,支援 ESX 8.x 及其後版本,提供 3 項防護能力。

首先是虛擬修補(Virtual Patching)。當系統存在已知漏洞,但正式修補程式尚未安裝時,HyperArmor 可以偵測及阻擋利用漏洞的惡意操作,無須立即重新啟動主機或升級軟件。這讓管理員有時間完成相容性測試,但底層漏洞仍然存在,最終仍須安裝正式安全更新。

其次是 Positive Host Security Guardrails。系統會盤點 ESX 主機現有的程式及指令碼,建立獲允許執行的清單,並阻擋未經批准的程式。管理員需要執行新程式時,可以批准並更新相關規則。這項機制可限制攻擊者取得主機權限後執行惡意程式的能力。

第三項功能是直接整合至 ESX SSH 登入程序的多重認證(MFA)。管理員除輸入 SSH 憑證,還須提供與另一身份連結的限時一次性驗證碼,降低高權限帳戶憑證被盜用後,攻擊者直接取得主機命令列存取權限的風險。

Broadcom 表示,HyperArmor 在主機層運作,不需要在每部客戶虛擬機器內安裝額外代理程式。

SSH 多重認證納入付費產品 企業需另計授權成本

HyperArmor 將作為 VCF 的可選購附加產品銷售,意味著企業若希望使用上述主機層防護,包括內建 SSH 多重認證,需要額外購買服務。

VCF 本身已提供集中身份管理、資料加密及 Live Patching 等基本安全能力。HyperArmor 新增的則是主機程式執行控制、虛擬修補及 SSH 多重認證,企業需要分清兩者的功能及授權範圍。

據 TechTarget 報道,HyperFrame Research 分析師 Stephanie Walter 質疑,特權管理員使用的 MFA 是否應該列為額外收費功能。Broadcom 回應指,HyperArmor 針對需要更高安全保護的環境,並非所有 VCF 客戶都需要這套額外防護,因此採用選購模式。

Broadcom 尚未公開 HyperArmor 的具體售價。TechTarget 引述產品資訊指出,HyperArmor 預計於 Broadcom 2027 財政年度首季交付,該財政年度將於 2026 年 11 月開始。

虛擬修補不等於漏洞已解決 企業仍須維持更新測試

HyperArmor 可縮短漏洞暴露於攻擊的時間,但不能代替正式修補程序。對管理大量虛擬機器的企業而言,月度更新代表需要更頻密安排測試、變更審批及維護工作。

企業評估 HyperArmor 時,除了額外授權費用,亦須考慮如何將主機執行白名單、SSH 多重認證及漏洞修補紀錄納入現有維運流程。對於需要長時間保持服務運作的環境,虛擬修補可以提供測試緩衝時間,卻不代表系統管理員可以無限期延後正式更新。

資料來源:
Broadcom 官方公告
VMware Cloud Foundation 技術說明
TechTarget
SiliconANGLE

閱讀文章
IT 基建人工智能雲端服務

Google AI Pro 訂閱加入 Colab GPU 算力 有用戶獲 A100 80GB 及 200 運算單元

Google AI Pro Colab GPU 訂閱方案,提供 A100 80GB 和多個運算單元選項.

Google 正式將 Colab 進階運算權益納入 Google AI 付費訂閱方案,讓符合資格的 Google AI Pro 用戶在原有 Gemini 等 AI 服務之外,也能使用雲端 GPU 和 TPU 資源進行模型開發及測試。有用戶表示帳戶獲得 200 個 Compute Units,並成功使用 NVIDIA A100 80GB GPU,但 Google 未保證所有訂閱戶均可取得相同配額或硬件。

9 月起分階段推出 原有訂戶毋須額外購買 Colab

Google 早於 9 月 22 日宣布整合安排,並表示相關權益將於隨後數星期逐步向 Colab 支援地區的 Google AI 訂閱戶開放。

根據官方說明,符合資格的 Google AI 付費方案將獲得每月 Colab 運算單元,以及優先存取較高效能 GPU 和 TPU 的權益。用戶毋須另外訂閱 Colab Pro,相關權益會自動套用至同一 Google 帳戶。

Google AI Ultra 訂閱戶則有額外權益,包括 Premium GPU 存取及背景執行功能,讓長時間訓練工作可在關閉瀏覽器分頁後繼續運行。

現有 Colab Pro 或 Pro+ 訂閱亦不受影響。用戶可以同時持有 Google AI 與 Colab 訂閱,兩個方案的運算單元將計入同一帳戶餘額。

有用戶獲 A100 80GB GPU 型號及運算時數沒有保證

社交平台近日有用戶分享,Google AI Pro 帳戶獲得 200 個 Compute Units,並能連接配備 80GB 顯示記憶體的 NVIDIA A100 GPU。對於需要執行大型 AI 模型的開發者,這類硬件可用於模型推論、量化測試及 LoRA 微調等實驗。

A100 80GB 的主要優勢是較大的 GPU 記憶體容量,容許開發者載入較大型的模型權重,或在訓練時容納更多中間運算資料。實際可執行的模型規模,仍取決於模型架構、權重量化方式、上下文長度及訓練設定。

不過 Google 官方公告沒有承諾 Google AI Pro 固定提供 A100 80GB,也未在相關公告列明所有 Pro 帳戶均可獲得 200 個 Compute Units。官方 FAQ 明確指出,Colab 會動態調整可用 GPU 型號、用量限制及硬件供應,即使是付費用戶,也不能保證隨時取得指定 GPU。

Compute Units 亦並非固定運算時數。不同 GPU 及運行配置的消耗速度可以不同,運算單元耗盡後,帳戶便須遵守免費方案的相關限制,或另行購買額度。

降低模型實驗門檻 企業正式部署仍須另作規劃

這項整合讓已訂閱 Google AI 的開發者,可以利用現有訂閱進行更多 AI 模型實驗。對需要評估 Gemma 等開放權重模型的技術團隊而言,Colab 可用於初步驗證模型能否運行、比較量化配置,以及測試微調流程,減少為短期實驗而額外準備高階 GPU 硬件的需要。

不過 Colab 本身屬於共享雲端運算環境,執行階段有生命週期限制,GPU 供應亦會隨時變化。因此這項新權益較適合開發、學習及概念驗證,企業不能單憑 Google AI Pro 訂閱便假設取得具備固定硬件規格及可用性保證的生產環境。

Google 官方指出,需要保證資源的用戶可考慮 Colab Enterprise 或其他受控雲端運算部署方式。


如何檢查帳戶是否取得新權益

已訂閱 Google AI Pro 的用戶可以使用同一 Google 帳戶登入 Colab,進入「設定」中的「訂閱」頁面,檢查目前已啟用的訂閱及運算單元餘額。

用戶亦可在筆記本的執行階段設定中查看可選用的硬件加速器。能否選擇特定 GPU,取決於帳戶權益及當時資源供應。

Google 指出,相關權益只適用於符合資格的 Google AI 付費方案,單純訂閱 Google One 儲存空間方案不包括 Colab 進階權益。免費試用期間亦不包括相關福利,須待合資格付費訂閱正式生效。

資料來源:Google Developers Blog、Google Colab 官方 FAQ、Threads 社群帖文

閱讀文章
人工智能資訊保安雲端服務

Splunk AI 首次進駐本地機房 Cisco 同時推 Tokenomics 追蹤成本

展會現場有多位參觀者在Splunk展台前交流.

思科宣布,透過 Splunk 推出多項 AI 技術突破,讓客戶能在機器數據所在環境中運行、防禦及監測 AI,同時擴大與 NVIDIA 合作,將 Splunk AI 延伸至本地部署客戶。這次發布核心,是要解決企業導入 AI 代理時最大顧慮——並非技術能力不足,而是缺乏信心:客戶需要確信 AI 安全可靠、治理得宜且物有所值,才會放心大規模部署。

思科全球總裁兼首席產品總監 Jeetu Patel 表示,目前企業應用 AI 最大障礙之一是部署難度過高,客戶普遍想了解 AI 能否勝任工作、成本能否負擔,以及安全性能否確保。他強調,透過在既有可信基礎架構上運行 Splunk AI,企業能更快、更有信心地將 AI 融入業務營運,並能充分掌控。這次發布涵蓋四大方向:思科 AI POD for Splunk 正式推出、Splunk Agent Observability 新增 Tokenomics 成本追蹤功能、代理資訊安全監控中心(Agentic SOC)能力全面升級,以及思科與 AWS 正式簽訂多年合作協議。

敏感數據不必離開機房也能用 AI

對於無法將敏感數據遷移至雲端的客戶而言,Splunk AI 過往一直遙不可及,直到思科與 NVIDIA 擴大合作才出現轉機。雙方正為 Splunk Enterprise 客戶提供可自主管理的 AI,覆蓋本地部署、私有雲端及實體隔離(air-gapped)環境。

這項合作具體成果是 Cisco Secure AI Factory with NVIDIA 參考架構,由思科 AI PODs 打造而成,其中最新配置的思科 AI POD for Splunk,結合全新 AI 運行時軟件、思科基礎架構、NVIDIA 加速運算,以及基於 Kubernetes 的架構,將 Splunk AI 引進本地部署客戶。這些功能均已經過預先驗證,並針對 Splunk AI 工作負載進行最佳化,目前已正式推出。對擁有自身基礎架構的客戶而言,Accenture、bitsIO、Wipro 及 World Wide Technology 等合作夥伴已準備就緒,可協助客戶完成部署。

現已推出的 Splunk AI Assistant,與預計今年稍後推出的 Agent Launchpad,均可在這套架構層上運行。兩者結合後,能為本地數據中心運行 Splunk 的團隊提供即時代理式調查,並針對涵蓋 Agentic SOC 的廣泛應用場景建構自訂代理功能。客戶亦可在 Splunk Enterprise 工作負載中,自行託管多款開放及專有生成式 AI 模型,包括思科 Deep Time Series Model、Google Gemma 4 及 OpenAI GPT-OSS 20B,未來數月內還將支援 NVIDIA Nemotron 開源模型,團隊無需將數據傳送至外部環境,即可因應實際需求選用最合適模型。

NVIDIA 企業 AI 平台副總裁 Justin Boitano 表示,當安全及數據主權要求關鍵工作負載必須保留在本地環境時,企業需要在數據所在環境中部署 AI。透過在 NVIDIA 加速運算平台上運行 Splunk AI 工作負載,並結合 NVIDIA Nemotron 開源模型,思科與 NVIDIA 攜手將 AI 代理直接引入 Splunk,為企業提供高效能全端基礎架構,讓企業無論在何處運行基礎架構,都能支援代理式安全營運。  

一個畫面看清 AI 代理表現與 Token 帳單

AI 代理行為模式往往難以完全預測,相關成本也可能在帳單出現之前一直未被察覺。針對這個問題,Splunk Agent Observability 推出全新 Tokenomics 功能,讓企業即時掌握 AI 代理運作表現及 AI Token 開支,團隊可以清楚了解成本在何處及為何持續累積,及早避免對預算造成壓力。

Splunk Agent Observability 最初為本地部署方案,現已擴展至 Splunk Observability Cloud 及思科雲端控制(Cisco Cloud Control),讓採用思科產品組合的客戶能獲得更全面可視度。該方案可評估 AI 代理及模型的行為表現、監測整個 AI 技術堆疊運作情況,並於執行期間設置防護機制,阻止幻覺、敏感資料外洩等不準確或不安全行為。

作為 Splunk Agent Observability 一部分,全新 Tokenomics 解決方案將可視度進一步延伸至成本管理層面,追蹤並分析不同 AI 代理,以及員工使用 Claude Code、Codex 和 Cursor 等程式編碼代理的 Token 開支。方案亦利用 Cisco Deep Time Series Model 預測使用模式,並於賬單週期結束前預測開支趨勢,助企業及早掌握成本變化,建立並落實 Tokenomics 管理框架,將 AI 投資與實際業務成果更有效緊密連結。

此外,思科亦透過減少影響自主故障排查的可視度盲點及成本門檻,助企業增強基礎架構韌性。Observability Studio 讓團隊從應用程式開發初期便具備「原生可觀測」特性;全新 Network Intelligence App 將思科的網絡拓撲、設備健康狀況及事件資訊整合至 Splunk 平台;Observability Cloud 亦全新推出 Essentials 及 Premier 版本,簡化企業部署及擴展可觀測度能力過程。

資安監控中心要用機器速度對抗 AI 攻擊

AI 驅動攻擊速度正超越傳統由人類主導的安全營運所能應對極限。要有效抵禦 AI 時代威脅,企業需要建立具備代理式能力的資訊安全監控中心(Agentic SOC),以機器速度進行推理及防禦,同時兼顧企業對數據主權及人類管治要求。

Splunk 正透過結合企業級遙測數據,以及由領先前沿模型和特定領域模型驅動的專屬 AI 代理,推動 Agentic SOC 發展。全新代理能力進一步擴展 Splunk Agentic SOC Workforce,模擬頂尖安全團隊運作模式,涵蓋偵測工程、主動威脅獵捕、自主調查、協調應變及政策管治等工作。透過關聯分析橫跨網絡、雲端、應用程式及身份管理環境的豐富全端式機器數據,這些 AI 代理能進行深度推理並提供透明且可解釋的分析結果,從而減少警報雜訊,並縮短平均修復時間。

攻擊者現正利用 AI 大規模搜尋漏洞,持續且無差別地探測基礎架構、應用程式及身份系統。近期多宗攻擊事件顯示,全面掌握風險暴露狀況已成為企業董事會層面重要議題。全新升級的風險暴露分析功能,透過更廣泛資產覆蓋範圍、歷史變更追蹤及針對特定業務情境的風險洞察,協助企業全面了解風險暴露情況。透過連結風險暴露資訊與 Splunk、思科及廣泛第三方生態系統中的即時安全活動數據,團隊能夠掌握 IT 環境全貌,而非僅限於單一供應商所涵蓋範圍。

全新 Splunk Enterprise Security Essentials 功能,將代理式安全營運能力及更為自主化功能帶給更多安全團隊;Splunk Enterprise Security Premier 則進一步提供更深入代理式自主能力,以及 Splunk Enterprise Security 完整功能。

與 AWS 攜手共建代理式企業

面對 AI 驅動攻擊不斷加速趨勢,Splunk 與 AWS 正進一步加深合作,雙方擴展合作規模,透過一項多年合作協議,將聯合進行產品開發,共同推動代理式資訊安全監控中心發展,以更快速應對 AI 驅動攻擊。

AI 驅動攻擊正以超越人類應變流程速度演變。要有效應對這些威脅,企業不僅需要更深入安全洞察能力,亦需要具備即時採取行動的規模化能力。Splunk 提供安全團隊一直依賴的數據平台及深度威脅偵測能力,而 AWS 則提供全球級雲端擴展能力。雙方將攜手為安全分析人員提供代理式支援,涵蓋威脅偵測、事件調查及應變等關鍵工作。安全團隊不會為追求更快速度而放棄監督與管治,展望未來,實現大規模代理式行動將成為企業發展趨勢,同時確保企業所需治理機制與分析師管控能力。

這次發布整體反映出思科正試圖以「本地部署可行性、成本可視度、代理式資安」三大支柱,回應企業對 AI 大規模啟動的核心疑慮,讓客戶能在自己信任的基礎架構上,安全且具成本效益地擴展 AI 應用。


資料來源: Press Release

閱讀文章
人工智能企業趨勢雲端服務

巴克萊報告:AI 公司每賺 100 美元 雲端巨頭抽走近四成收入

AWS、Azure 和 Google Cloud 雲端平台標誌並列展示.

AI 模型公司每賺 100 美元,約有 35 至 40 美元最終落入亞馬遜 AWS、微軟 Azure 及 Google 雲端平台三大巨頭手中,而雲端商可保留的營業利潤約 10 至 20 美元,利潤率介乎 35% 至 45%。這是巴克萊 8 月 28 日發表 AI 產業單位經濟研究報告的核心結論。報告同時揭示推理業務利潤率出現爆炸式增長,以及不同 AI 實驗室因收入結構差異而出現的財務落差。

推理利潤暴漲 訂閱與 API 走向兩極

巴克萊指出,AI 實驗室付費推理業務的毛利率已從 2025 年的低雙位數,急升至 2026 年的 50% 至 65% 甚至更高,主要由企業客戶與智能體工作流帶動,議價空間隨之收窄。記者整理多家財報後發現,市場對「AI 燒錢」的印象正被推翻——Anthropic 第二季度收入 115 億美元(約港幣 897 億元),首次實現整體盈利,API 業務毛利率逼近八成。不同產品線差異懸殊:訂閱型產品如 Claude Code 利潤率約 70%,是利潤率最低的一類;開發者按量付費的直接 API 業務利潤率已超過 80%,是變現效率最高的環節。

會計方式差異放大財報可比性問題

巴克萊虛構「實驗室 A」與「實驗室 B」作對比:A 實驗室七成收入來自 API,毛利率約 55%;B 實驗室八成收入依賴訂閱,毛利率僅約 38%,差距達 17 個百分點。這種落差被類比為 Uber 與 Lyft 的財報差異——收入確認方式不同,對外披露數字就可能天差地別。現實中已有案例:月之暗面正與微軟、亞馬遜、Google 洽談 Kimi K3 模型的雲端收入分成,尋求最高三成分佣,正是「實驗室 B」模式的寫照。

對雲端商而言,實驗室 A 帶來約 35 美元收入、11.8 美元利潤、34% 利潤率;實驗室 B 則因分佣機制創造 41 美元收入、19.1 美元利潤、47% 利潤率,但巴克萊提醒此舉會人為墊高賬面利潤率,預計 2028 年後逐步取消。

從 7 億到 6,900 億美元的三年爆發軌跡

巴克萊預測全球 AI 實驗室總收入將從 2024 年的 70 億美元(約港幣 546 億元),飆升至 2026 年的 1,370 億美元(約港幣 1.07 兆元),2028 年進一步衝上 6,900 億美元(約港幣 5.38 兆元);年化經常性收入則從 2026 年底約 2,000 億美元(約港幣 1.56 兆元),升至 2028 年底 7,820 億美元(約港幣 6.1 兆元)。背後動力是訓練成本佔比快速下降——由 2024 年 96% 降至 2027 年 35%、2028 年 30%,意味推理利潤將逐漸超越訓練支出。

與此同時,雲端商 AI 收入相對實驗室收入的比例,也將從 2024 年 153% 降至 2028 年 73%,顯示雲端商的「分佣議價力」正逐步減弱。短期而言,三大雲端商仍佔優勢:2026 年 AWS 約 73% 的 AI 收入來自 OpenAI 與 Anthropic 兩家,Google Cloud 第二季度收入暴增 82% 至 248 億美元(約港幣 1,934 億元),營業利潤率由 21% 躍升至 36%。

巴克萊預計未來兩年三大雲巨頭的算力市場佔有率大致穩定,但 2028 年起 AI 實驗室自建的專屬算力上線後,佔有率可能逐步流失。摩根大通資產管理則警告,許多 AI 服務目前定價低於成本,靠廠商補貼換取市佔率,一旦算力費用上漲,企業客戶利潤空間將首當其衝。對企業客戶而言,選擇 AI 供應商時不能只看價格,還須留意雲端依存結構與會計處理方式。當分佣格局在 2028 年後重新洗牌,今天佔盡優勢的雲端巨頭能否維持話語權,將是決定下一輪 AI 競爭的關鍵。

資料來源:財聯社、Moomoo News、Forbes、Reuters、WebProNews

閱讀文章
人工智能企業趨勢雲端服務

微軟八年雲端轉型終章 Azure 營收比重首破千億美元 Windows 淪零頭

微軟Azure雲端服務圖像,展示雲端計算和數據傳輸的數字化概念.

微軟公佈的 2026 財年業績顯示,Windows 作業系統在集團收入結構中的地位持續被邊緣化,Azure 雲端服務全年營收首度突破 1,000 億美元,按年增長 41%,成為微軟歷來最大單一產品線。這份財報於 7 月 29 日公佈,由行政總裁 Satya Nadella 與財務總監 Amy Hood 主持的分析師電話會議中一併披露,涵蓋全公司五大業務板塊的收入與利潤分配,反映雲端與人工智能才是推動股價單日創下歷史新高升幅的核心引擎。

雲端收入規模拉開差距

微軟將 Windows 客戶端、Surface 硬件、Xbox 與 Bing 等業務歸入「更多個人計算」部門,該部門全財年營收 540 億美元,營業利潤 144 億美元。市場分析普遍估算,其中 Windows 客戶端本身的營收僅約 170 億美元、利潤約 100 億美元,佔集團總營收比重不到 5%。相比之下,Azure 在第四財季按年增長 43%,超越市場預期的 39.98%,帶動整體 Microsoft Cloud 業務季度營收達 593 億美元,按年增長 27%。這種規模落差意味着,Windows 即使維持穩健的利潤率,其增長曲線已無法與動輒 40% 以上增速的雲端業務相提並論。

供給追不上需求

Nadella 在電話會議中直言,Azure 的客戶需求持續超越可用運算容量,失衡狀態短期內未見緩解,公司正透過 CPU 與 GPU 機隊效率提升來填補缺口。財務總監 Amy Hood 補充指出,效率提升是本季 Azure 增速加快的關鍵原因之一。另一派觀點則聚焦傳統業務的風險:Guggenheim 分析師 John DiFucci 在財報前提醒,Windows 原始設備製造(OEM)與裝置業務的下滑幅度雖不如公司先前預測的「中高雙位數百分比」般嚴峻,但仍是投資者需要持續監控的變數。

八年戰略佈局延續

追溯時間軸可發現,微軟對 Windows 的「降權」早在 2018 年 3 月已見端倪。當時 Nadella 宣佈解散原有的 Windows and Devices Group,將大部分工程團隊併入由 Scott Guthrie 領導的雲端與企業事業群,Windows Server 甚至被歸入「Cloud + AI Platform」旗下。有分析師當時已形容這是「Windows 稱王時代的終結」,微軟自此將雲端訂閱與 AI 服務視為長期現金流主軸,而非依賴一次性作業系統授權費。時間推進到 2026 年,這套邏輯進一步延伸:微軟正將商業模式由「按席位收費」轉向「按席位加按使用量」雙軌制,試圖擴大可觸及的市場規模。


資料來源:cnBeta.COM、CNBC、The Register、MarketWatch、The Seattle Times


閱讀文章
人工智能應用方案業界消息雲端服務

AMD Advancing AI 2026 全面佈局 Helios 機櫃級系統量產 與多家 AI 巨頭深度合作

女性科技專家在舞台上展示AMD最新AI技術.

AMD 於 Advancing AI 2026 年度大會上,正式推出涵蓋數據中心、個人電腦、邊緣及嵌入式處理器的全新 AI 基建與實體 AI 產品組合。核心為全球最強大的 AI 機櫃級系統 AMD Helios,目前已投入量產並獲多家 AI 企業展開 Gigawatt 級部署。AMD 董事長兼行政總裁蘇姿丰博士表示,AI 下一階段將涵蓋前沿模型、代理式 AI 及實體 AI,需要整個產業共同努力才能實現這一願景。

Helios 機櫃樹立效能標準

AMD Helios 機櫃級解決方案採用 72 個 AMD Instinct MI455X GPU 及 18 個第 6 代 AMD EPYC「Venice」CPU,透過 AMD Pensando 前端網絡連接,並以 ROCm 開放軟件加速,較領先競爭方案提供高達 30% 的每美元 Token 產出優勢。OpenAI、Anthropic、Meta、微軟、Oracle 等雲端與 AI 實驗室已選用該架構,系統將由 Bull、HPE、聯想、Supermicro 等 OEM 廠商及 Sanmina、緯穎等基礎設施夥伴提供。

重點合作夥伴進展

多家 AI 巨頭在大會上詳述與 AMD 的深度合作:

Anthropic:將於 AMD Helios 機櫃部署高達 2 Gigawatts 的 MI455X GPU,並運用 Claude 加快 AMD 軟件與 ROCm 開發。

OpenAI:結合 Triton 框架與 ROCm 優化 GPT 級工作負載,預計 2026 年第 4 季導入 Helios,2027 年全面加速部署。

Meta:針對 Gigawatt 級部署聯合設計,正驗證第 6 代 EPYC CPU 平台及 Helios 機櫃。

Cerebras:結合超低延遲 AI 運算與 Helios 高吞吐量基礎設施,提升推論服務效率。

AT&T 與思科:分別展示電訊領域專用開源模型 OTel 2.0 部署及企業級混合式 AI 管治方案。

CPU 與 GPU 產品線全面升級

第 6 代 AMD EPYC 處理器主打代理式 AI 場景,具備領先業界的單核心效能與最高執行緒密度,確保加速器維持滿載運作。GPU 陣容方面,AMD Instinct MI455X 較 MI355X 提供高出 34 倍的 Token 吞吐量,MI430X 則為 HPC 及主權 AI 市場提供高達 288 TFLOPS 的硬件原生 FP64 效能,而 MI350P 透過每美元 Token 數提升高達 4.2 倍,為現有基礎設施帶來無縫 AI 加速能力。

產品路線圖延伸至 2030 年

AMD 公布最新藍圖:基於「Zen 7」架構的 Florence、Ferrara 及 Fidenza CPU 將於 2028 年推出,「Zen 8」架構的 Ravenna CPU 則預計 2030 年登場;GPU 方面,MI500 系列將於 2027 年推出,MI600 系列則於 2028 年跟進,同步將有 Helios 500 與 Helios 600 機櫃級解決方案配套發布。

實體 AI 與邊緣布局

AMD 推出 Kria AI 系統模組及機械人開發平台,將 AI 感知、推理與代理式決策控制整合於單一平台,並結合 CPU、GPU、NPU 及 FPGA 運算能力,協助開發人員加速機械人系統從原型走向量產。全新 Ryzen AI Embedded X100 處理器及 Ryzen AI Halo 開發平台,將 AI 延伸至 PC 與邊緣裝置,AMD 預估此舉將推動其 2030 年潛在市場規模上升至約 2 兆美元。


資料來源: press release

閱讀文章
人工智能資訊保安雲端服務

Cisco Connect 香港 2026 : 網絡流量、安全與跨境合規 如何重寫企業 AI 的 TCO 估算

兩位男士在思科AI技術展覽會場合影.

不少企業誤以為 AI 轉型勝負只取決於大模型參數與 GPU 數量,然而隨著 Agentic AI 進入全天候自主營運的新階段,隱藏在演算法背後的網絡容量飽和、保安防禦及跨境合規風險,正悄然重寫企業的 TCO 估算。Cisco 在 Cisco Connect 香港大會上為業界敲響警鐘:企業 AI 預算正迎來從「應用模型」向「營運底座」的結構性轉移。基座不穩再先進的 AI 代理也只會淪為企業的營運與合規隱患。以下深度拆解企業決策者重組 AI 投資回報(ROI)的核心關鍵。

AI 預算由模型轉向營運基座

企業引進 AI 的競爭焦點,正迅速從大模型能力、GPU 數量及應用開發,延伸至網絡容量、保安控制、營運可視度及服務韌性。Cisco 在 Cisco Connect 香港大會上指出,過往的生成式 AI(GenAI)主要被動等待員工下達指令;而全新發展的 Agentic AI 則能自主讀取數據、調度工具、對接企業系統,甚至全天候執行業務流程。

這項轉變代表 AI 正從單純的「軟件工具」,轉化為企業核心營運架構的一環。管理層在評估投資回報(ROI)時,不能只計算模型授權費、算力資源和開發人手,更必須把網絡升級、停機損失、保安監察、跨境數據合規及 SaaS 持續訂閱費用納入其中。企業能否成功擴大 AI 規模,最終取決於整個數碼基座(Digital Foundation)能否承載 AI 代理的持續運作,而非單看模型能力。

AI 代理持續運作,傳統網絡容量規劃面臨失效

Cisco 與 Foundry 聯合訪問了全球 15 個國家、超過 3,400 名 IT 及網絡決策者,結果顯示:由生成式 AI、代理式 AI 及實體 AI(Physical AI)共同驅動的園區與分支網絡流量,預計在未來 3 年內暴增 209%(相當於目前的 3.1 倍)。同時 85% 的受訪機構預期在未來兩年擴展代理式 AI 應用;76% 坦言現有網絡必須升級;更有 73% 預計網絡容量將在兩年內達到飽和極限。

Cisco 廣東、香港及澳門區解決方案工程主管兼首席架構師 Philip Wong 解釋,人類使用系統時會有閱讀、思考與休息的停頓,網絡流量呈「間歇突發式(Spiky)」;然而 AI 代理卻能全天候自主獲取資料、進行推理並調用多個系統,產生的數據交易量與頻率遠超一般員工。企業過去單憑員工人數、辦公時間及平均流量制定的網絡容量規劃,將嚴重低估 AI 代理投入正式營運後的實質負荷。

對決策者而言,網絡升級已非單純改善網速的 IT 項目。若頻寬、無線網絡、分支網絡(Branch Connection)或後台系統無法承載 AI 代理的持續運作,再強悍的模型也無法穩定投入生產,甚至可能直接威脅業務連續性(Business Continuity)與客戶體驗。

AgenticOps 有助降低停機風險,但 SaaS 隱性成本不容忽視

目前多數企業仍由網絡、保安、應用與運算團隊各自管理獨立系統。一旦服務變慢或中斷,跨部門往往需要逐一比對日誌(Logs),再透過繁瑣的工單與會議排查,嚴重拖慢修復進度。調查顯示,71% 受訪企業坦言網絡監察與可視度的盲點正在增加,反映傳統分割式的營運模式,已無法應付大量 AI 代理之間高頻、複雜的自動化交易。

為此 Cisco 推出 Cisco Cloud Control 統一平台,將網絡、保安、運算、可觀察性(Observability)及協作數據整合至單一營運環境;配合 AI Canvas,IT 人員能與多個 AI 代理共享相同的情境資訊,快速進行事故診斷與驗證。然而,評估這類 AgenticOps 方案時,不應只問「能省下多少 IT 人力」,而應著眼於縮短平均修復時間(MTTR)、降低跨部門協作成本、避免業務中斷損失,以及驗證 AI 的決策建議是否具備完整的可審計性(Auditability)。

Cisco 指出,Cloud Control 及 AI Canvas 目前已包含在現有的 Essential 或 Advantage 產品訂閱中,不另收平台費;但這並不代表整個營運堆疊(Ops Stack)沒有持續性成本。例如網絡可視性平台 ThousandEyes 採用年度訂閱制,費用會隨著監察測試的類型、頻率及代理數量而變動;而大數據平台 Splunk 則依據數據攝取量(Data Ingestion)或搜尋/分析所需的運算與儲存資源進行計費。

當 AI 代理 24 小時不間斷地產生網絡遙測、工具調用、審計日誌及保安事件時,數據攝取量和保存成本將顯著上升。CEO 與 CFO 應以 3 至 5 年的週期來計算整體 TCO,將產品訂閱、數據攝取、分析運算、儲存與技術支援,同硬件採購、人力及停機風險放在同一個財務模型中評估,而非僅比較首年的硬件採購價。

AI 代理成為企業新身份,大灣區跨境數據流向亦要受控

Cisco 廣東、香港及澳門區董事總經理莊銓盛(Wilson Ching)指出,未來的企業工作團隊(Workforce)是由人類、模型與 AI 代理共同組成的混合架構。AI 代理擁有存取文件、呼叫 API、連接 MCP 伺服器並與其他代理對話的權力。因此企業必須為每個代理設定明確的可識別身份(Identity)、最小權限(Least Privilege)、可用工具邊界、數據存取範圍及操作時限。管理層也必須釐清:誰擁有該代理、誰核准其權限、誰能在緊急時終止其操作,以及事故發生後能否完整重現其決策鏈。

保安機制絕不能只框限在代理本身。由於代理必須頻繁接觸外部工具、MCP 伺服器與企業內部數據,一旦接收到遭污染的內容(Contamination)或惡意指令,代理極可能成為攻擊者的入侵入口。Cisco 將代理保安劃分為三大防禦方向:防止代理執行越界行為、保護代理免受外界操控或污染,以及以機器速度偵測並處理威脅。其中,Cisco 開源的 DefenseClaw 安全框架,現階段能為代理提供外掛(Plugins)、技能及 MCP 連接的動態掃描、運行時監察(Runtime Monitoring)與政策強制執行。

對於香港及大灣區企業而言,代理的身份與權限控制必須延伸至數據地理分佈(Data Residency)。AI 代理可能會自動將資料傳輸至內地數據庫、香港雲端、海外大模型或外部 MCP 服務;若企業只管控「可否讀取資料」,卻忽略了「資料能流向何處」,敏感數據就極可能在無人察覺的情況下流出境外。

雖然《粵港澳大灣區(內地、香港)個人信息跨境流動標準合同》提供了自願採用的便利安排,但企業仍須進行個人信息保護影響評估(PIPIA),並於合同生效後 10 個工作天內完成備案。更關鍵的是,接收方不得將資料轉移給大灣區以外的機構或個人,且香港《個人資料(私隱)條例》依然適用。如果企業未能管控好 AI 代理,任由其將相關資料發送給大灣區以外的模型或外部服務,將直接面臨重大的法律合規風險。

Switch 內置 Firewall 節省成本雙位數百分比

調查指出,92% 的受訪企業認為 AI 讓保安威脅更難應付,90% 表示 AI 相關保安事件已對業務造成實質影響。黑客正利用 AI 代理加速偵察、漏洞測試及憑證竊取。Anthropic 於 2025 年 11 月披露,一個具備國家背景的黑客組織利用 Claude Code 展開網絡間諜行動,AI 自主完成了 80% 至 90% 的進攻工作,高峰期每秒發起多次請求,這種「機器速度(Machine Speed)」的自動化攻擊已徹底顛覆傳統的保安防禦時間差。

Philip Wong 指出,企業在發現漏洞(CVE)後,通常需要花費大量時間進行測試、協調維護窗口並忍受停機升級。對於金融、零售、交通等 24/7 全天候營運的機構而言,幾乎是無法安排的痛點。Cisco 推出的 Cisco Live Protect 技術,能直接在設備運行期間於內核(Kernel)層建立「虛擬防護盾(Shielding)」,無需重新啟動設備、無需停機升級(Zero Downtime),能極大化縮短漏洞公開至完成正式修補之間的風險暴露窗口,為 IT 團隊贏得寶貴的緩衝時間。(註:此虛擬盾牌旨在防禦,不能完全取代後續的正式更新。)

此外 Cisco 透過將 DPU(Data Processing Unit)晶片整合至智慧交換機(Smart Switch)中,將部分 Layer 4(第四層)防火牆與流量控制功能直接融入交換硬件。Philip Wong 在 Q&A 環節透露,海外已有銀行採用此架構,在特定的邊緣及上雲(Cloud Edge)場景中,成功省下雙位數百分比的總體成本,並精簡了大量獨立防火牆硬件;香港亦有大型客戶正進行評估。這種設計將保安能力下沉,在僅需 Layer 4 控制的場景中直接由交換機處理,而涉及應用層深度檢查(Deep Packet Inspection)及進階威脅分析的環境,則交給 Layer 7 高級防火牆負責,實現成本與保安的最佳化配置。

統一平台仍有邊界,量子保安先由資產盤點開始

統一平台固然能簡化 IT 管理,但無法在一夕之間解決「多供應商(Multi-Vendor)」環境的割裂問題。雖然 Cisco Cloud Control 能透過 Cloud Control Studio 對接第三方工具,但現場 Q&A 明確揭示,Cisco 目前推出的 Cisco IQ 平台在現階段主要僅能管理 Cisco 自身的資產(進行設備盤點、配置查看、漏洞掃描及支援壽命管理),對非 Cisco 設備尚未提供完整支援。企業在採購時,必須分清平台究竟只能「看見」第三方資產,還是能「理解」其配置並「直接執行」修正,同時要評估長期下來的供應商鎖定(Vendor Lock-in)與系統遷移成本。

在保安防禦的前瞻部署上,Cisco IQ 的 Quantum Ready Assessment(量子就緒評估)服務,能協助企業盤點面對未來「先收集、後解密(Harvest Now, Decrypt Later)」風險的資產,排定更新、升級或調整加密算法的優先順序。而 Cisco 通用量子交換器(Cisco Universal Quantum Switch)則是用於室溫及現有電訊光纖上連接不同供應商量子電腦的研究原型,屬於未來量子互聯網(Quantum Networking)的探索,與企業當前迫切需要進行的後量子密碼學(PQC)遷移是兩回事。

量子保安的首要工作,是資產盤點,而非盲目購買昂貴的量子硬件。企業應優先清查現有的加密協議、設備使用壽命、敏感數據的保存年期以及現有供應商的 PQC 升級路線圖。若一味觀望、等量子計算技術完全成熟才倉促處理,企業將被迫在極短時間內更換大量舊系統,屆時成本與營運中斷風險將呈指數級飆升。

香港及大灣區企業應重排 AI 投資次序

Wilson Ching 坦言,此次 Foundry 調查雖無單獨拆分出香港的數據,但本地企業所面臨的網絡容量、保安威脅與運作壓力,與全球主要市場完全一致。同時本地企業更高度關注數據合規、治理架構及 AI 生態衍生的連帶風險。美心集團(Maxim’s Group)資訊科技高級總監馬慶和也強調,集團在利用代理式 AI 自動化工作流程及提升營運效率的同時,必須同步建立完善的管治、保安與端到端可視性機制。


結語:從「算力競賽」回歸「架構基本功」

AI 轉型已正式告別單純的模型參數比拼,進入考驗基礎架構與營運韌性的實戰下半場。當「AI 代理」成為企業工作團隊的新成員,底層網絡的承載力、零停機的安全防禦,以及大灣區跨境數據的流向控制,都將直接決定 AI 是能轉化為真正的生產力,還是淪為無法預測的營運地雷。

面對「代理式企業」的新時代,CEO 與 CFO 必須徹底扭轉傳統「重應用、輕架構」的預算思維,以 3 至 5 年的長遠週期重新評估 AI 的整體 TCO 模型。畢竟 AI 應用的勝負手,從來不在於企業購入了多少酷炫的工具,而在於能否建立一個安全、合規、具經濟效益且能完全審計的數碼底座,讓 AI 代理在可控的架構內平穩運行。這才是企業在 AI 時代安心創新、行穩致遠的唯一路徑。


閱讀文章
人工智能業界消息雲端服務

1,450 億美元押注 AI 未見回報 Meta 裁員重組引發內部動盪

Meta AI 與語音技術展示,強調人工智能與語音應用.

Meta 行政總裁 Mark Zuckerberg 上週在內部大會上承認,人工智能代理(AI agent)的開發速度明顯落後預期,過去 4 個月發展並未出現預期中的加速。他同時承認,早前大規模架構重組的時機計算有誤,裁員與調整過程亦「並不乾淨」,是他少有對內部策略作直接檢討的時刻,變相承認 Meta 在 AI 布局上,短期仍未找到穩定節奏。

公司原本希望透過重組,將更多資源集中到 AI 代理及超級智能相關項目,但目前組織重塑尚未轉化為可見成果。Zuckerberg 雖然沒有詳細交代落後原因,但仍強調 Meta 正朝「通往超級智能之路」前進,預期未來 3 至 6 個月可望見改善。這種一邊承認問題、一邊維持長線信心的說法,反映管理層正試圖在市場預期與內部士氣之間尋找平衡。

裁員重組未消化 士氣壓力上升

Meta 今年 4 月起啟動約 8,000 人裁員計劃,並將另外約 7,000 名員工調配至不同 AI 部門,包括專責代理技術的團隊。重組原意是加快 AI 產品化步伐,但 Zuckerberg 在內部會議承認計劃至今未見成果,反映組織調整與實際執行之間仍有明顯落差。對員工而言,裁員陰霾未散,工作方向又突然轉向 AI 優先,士氣自然受挫。

從外部觀察,Meta 這次調整不只是縮減成本,而是高風險的資源再分配。公司在壓縮部分傳統團隊的同時,將更多人力和算力押注在 AI 代理上,意味着若技術進展短期內未能兌現,內部壓力只會繼續累積。這亦解釋了為何 Zuckerberg 在會議中雖然仍保持樂觀,但語氣明顯比以往保守。

巨額資本開支 回報仍待驗證

儘管進度未達標,Meta 今年仍計劃將最多 1,450 億美元(約港幣 1.13 萬億元)投入 AI 基礎設施,包括數據中心及相關運算能力擴充。財務總監 Susan Li 早前表示,公司一直低估運算需求,因此需要持續提高資本開支預算。這代表 Meta 並未放慢投資步伐,反而在成果未明之際繼續加碼,策略上帶有極高押注意味。

問題在於,agentic AI 本身比一般生成式 AI 更難落地,因為它要求模型不只生成內容,還要處理多步驟任務及更複雜的推理流程。這種技術門檻意味着,單靠增加算力未必能即時換來產品突破。對 Meta 來說,資本開支上升與商業化回報之間的時間差,正是外界最關注的風險。

監控爭議加深不信任

同一場內部大會上,技術總監 Andrew Bosworth 回應了備受爭議的員工監控計劃「Model Capability Initiative」。該計劃曾要求美國員工在工作電腦安裝監控軟件,記錄鍵盤輸入、滑鼠移動及螢幕截圖,用作 AI 訓練相關研究。不過,計劃其後因安全漏洞及員工反彈而暫停,並引發逾 1,500 名員工聯署抗議。

Bosworth 表示,安全審查確認並無員工資料被實際用於訓練 AI 模型,若日後重啟,計劃將改為自願參與,不再強制執行。這項讓步雖有助緩和部分憂慮,但事件本身已削弱管理層與員工之間的信任。在裁員、重組與技術進展放慢同時發生的情況下,任何涉及監控與私隱的安排,都更容易被視為高壓管理的延伸。

後續觀察重點

Meta 未來 3 至 6 個月的 AI 表現,將直接影響外界對其整體戰略的評價。若 agentic AI 真的開始提速,巨額投資與重組成本仍有機會被合理化;但若進展持續落後,公司或需重新檢討資源分配與執行節奏。在 AI 競賽越來越激烈的環境下,Meta 面對的不只是技術問題,更是組織管理與信任重建的長期考驗。

資料來源:Reuters;CNBC;BBC;Reuters;CNBC


閱讀文章
人工智能業界消息雲端服務

AI 熱潮衝擊電力供應? 2026 年全球 IT 支出達 6.3 萬億美元

Gartner 最新預測顯示,2026 年全球 IT 支出將達 6.31 萬億美元(約港幣 49.2 萬億元),按年增長 13.5%。當中增長最快的是 AI 數據中心系統,相關支出將急升 55.8%,反映全球科技企業正大規模投入 AI 運算基建與高效能晶片。

對科技業而言,這代表 AI 已從「新功能」變成基礎設施競賽。從 Nvidia、Microsoft 到 Amazon 與 Google,均正加速興建 AI 數據中心及採購 GPU,以支援生成式 AI 與 AI Agent 運作。

據 Gartner 4 月發布的報告,AI 工作負載快速增加,正帶動高效能運算與高頻寬記憶體需求急升。Gartner 副總裁分析師 John-David Lovelock 指出,AI 基建已成為目前 IT 市場最具吸引力的投資領域。

數據中心支出暴增 55.8% AI 晶片與記憶體成最大贏家

2026 年增長最快的 IT 類別是數據中心系統,預計支出將達 7,879.9 億美元(約港幣 6.15 萬億元),按年增長 55.8%。相比之下,裝置設備增長只有 8.2%,反映市場資金正集中流向 AI 基建。

Gartner 指出,超大型雲端服務商對 AI 伺服器的需求,正推高 GPU、高頻寬記憶體與液冷系統價格。市場對 Nvidia AI GPU 的需求持續超過供應,亦令記憶體價格創新高。Nvidia 副總裁 Bryan Catanzaro 表示,其團隊的 AI 運算成本已超越人類員工薪酬,顯示 AI 模型營運已進入高耗能、高資本開支階段。

AI 熱潮開始衝擊電力與基建 能源或成下一個瓶頸

AI 基建急速擴張,亦開始帶來能源與供應鏈壓力。近期多份市場研究指出,大型 AI 數據中心耗電量遠高於傳統機房。部分 AI 伺服器機櫃功耗可達 60kW 以上,是一般數據中心的數倍。

TechRadar 引述分析指出,全球 AI 投資規模已超越歷史上的阿波羅登月計劃與國際太空站總和,單是 2026 年 AI 相關投資便可能高達 2.5 萬億美元。市場亦開始擔心 AI 基建擴張是否可持續。除了 GPU 與記憶體短缺,電力供應與冷卻系統亦可能成為限制 AI 發展的新瓶頸。

香港與亞洲市場同受影響 雲端與 AI 服務成本或持續上升

對香港企業與用戶而言,AI 基建競賽將直接影響雲端服務與企業 AI 工具成本。由於亞洲區大量 AI 運算資源依賴 Nvidia GPU 與海外雲端平台,若全球 AI 基建需求持續高企,企業使用 Microsoft Azure、AWS、Google Cloud 等服務的成本亦可能進一步增加。

同時,AI 數據中心建設亦將帶動亞洲半導體供應鏈受惠,包括台灣晶圓代工、高頻寬記憶體與伺服器代工市場。市場分析認為,未來數年 AI 基建仍會是全球科技投資核心。目前 AI 熱潮已從軟件競爭,正式演變成晶片、能源與數據中心的全面軍備競賽。下一階段市場焦點,將會落在 AI 投資何時開始真正轉化成企業盈利,以及全球電力與供應鏈能否支撐這波高強度擴張。


資料來源:

Gartner

快科技

CIO Dive

TechRadar


閱讀文章