Microsoft Research 發表研究系統 StudentSim,以公開的學習紀錄為每名學生訓練一個 AI 模擬器,讓 AI 補習老師在接觸真實學生前,先測試自己的指導能否令學生理解並改正錯誤。在國際象棋測試中,StudentSim 的行為擬真度為 0.5150,以提示詞驅動的 GPT-5.4 只有 0.2316。論文及程式碼已公開,但 Microsoft 表明 StudentSim 不是產品,沒有在課室部署,亦無意取代老師。這項研究反映評估 AI 教學工具的標準,開始由「答案對不對」轉向「學生有沒有學會」。
只看答案對錯,量度不到 AI 補習老師教得好不好
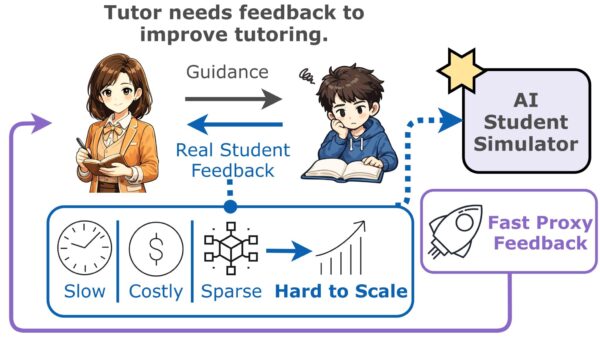
Microsoft 指出,AI 補習老師的教學質素不能只看它給出的答案。補習老師要知道學生收到指導後有甚麼變化:學生有沒有改正原本的錯誤,提示是幫學生推理出答案還是透露太多,另一名學生又會否需要不同的支援。要回答這些問題,最直接的方法是找真實學生做研究,但這類研究既慢又貴,難以配合模型快速迭代。
用 AI 扮學生是替代方法之一,惟現有做法各有缺陷。直接要求大型語言模型扮演學生,模型可以模仿年幼學生的語氣,運用的知識及推理卻遠超該學生的水平;模擬學生太聰明,補習老師就會顯得比實際有效,回饋反而誤導訓練。用來追蹤學生掌握程度的傳統知識追蹤模型亦不合用,因為這類模型大多不能接收以自然語言寫成的指導,回答不到「學生聽完這句提示後會怎樣」。
每名學生一個模擬器,先學共性再學個人
StudentSim 為每名學生建立個人化模擬器,模擬該學生怎樣回答問題,以及收到補習老師指導後答案怎樣改變。單一學生的紀錄通常不多,所以系統分 2 個階段訓練:第一階段以同一範疇多名學生的合併紀錄訓練,學習常見作答格式、常見錯誤及學生收到指導後的常見修改方式;第二階段再以個別學生自己的紀錄作專門化訓練,令模擬器貼近該學生的習慣。
技術上有報道指,程式碼為每個範疇訓練一個 LoRA(低秩微調)adapter,再按每名學生的紀錄繼續訓練;另有報道指底層模型是小型指令調校模型 Qwen3-4B-Instruct。訓練數據方面,Microsoft 表示研究只使用為研究用途公開、已去除身份識別的學習者數據集,任何階段都沒有用上個人識別資料。
國際象棋測試:擬真度比 GPT-5.4 高逾 1 倍
要判斷模擬器像不像真學生,Microsoft 借用心理學家 Vygotsky 的「近側發展區」概念,即學生獨立作答與獲得指導時的表現差距,並由此定出 2 項指標。行為擬真度(behavioral fidelity)量度模擬器在未見過的題目上,是否與某名學生的實際紀錄相符;指導反應度(guidance responsiveness)則量度模擬器讀完補習老師的指導後,會否更新答案。Microsoft 表示兩項指標互相補足:前者檢視模擬器能否維持學生原本的水平,後者檢視它會否對教學作出反應。
研究團隊同時推出基準測試 StudentSimEval,涵蓋國際象棋、英語作為第二語言寫作及數學 3 個範疇,共 60 名學生,據報道分佈為國際象棋 30 名、英語寫作及數學各 15 名。國際象棋的結果如下:
| 模型 | 行為擬真度 | 指導反應度 |
|---|---|---|
| StudentSim | 0.5150 | 0.9067 |
| GPT-5.4(提示詞驅動) | 0.2316 | 0.7186 |
| Maia2(國際象棋專用) | 0.4535 | 0.2721 |
以上數字由 Microsoft Research 於 2026 年 10 月公布。按數字計,StudentSim 的行為擬真度約為 GPT-5.4 的 2.2 倍。另一個對照是國際象棋專用的人類棋步預測模型 Maia2,它的擬真度略低於 StudentSim,指導反應度卻只有 0.2721,意味它較能預測學生會下哪一步,卻甚少因應指導而改變。據論文摘要,StudentSim 在 3 個範疇的 2 項指標上都勝過 GPT-5.4。
用模擬學生訓練補習老師,專家評分達 90.5%
模擬器的另一用途,是反過來為 AI 補習老師提供訓練訊號。Microsoft 以國際象棋做強化學習實驗:補習老師看到棋局及學生之前走錯的一步後提供指導,參數已凍結的 StudentSim 讀完指導後給出修改後的棋步,再由 Stockfish 棋類引擎按棋步質素的進步計算獎勵。換言之,補習老師要令模擬學生真的下得更好才會得分,指導寫得漂亮並不足夠。
國際象棋專家在不知道訓練方式的情況下評分,以 StudentSim 獎勵訓練的補習老師準確度達 90.5%,比沒有做強化學習的監督式基準(75.7%)高出約 15 個百分點;以 GPT-5.4 作模擬學生訓練的補習老師則只有 71.6%。
GPT-5.4 版本的表現比完全不做強化學習更差,呼應 Microsoft 對模擬學生太聰明的憂慮:模擬學生能力太高,可能無論收到甚麼提示都走出好棋,獎勵便難以分辨指導的好壞。對開發團隊而言,這反映選錯模擬學生,額外投入的訓練成本可能換來反效果。
開發 AI 培訓工具,要先問學員能否改正錯誤
StudentSim 針對學生學習,但同一套思路亦可能適用於企業內部的 AI 培訓及知識助手。開發 AI 補習工具的教育科技公司、企業學習與發展(L&D)主管,以及負責採購學習平台的 IT Manager,評估產品時除了看答案準確度,可以要求供應商說明怎樣量度學員收到提示後有沒有改正錯誤、提示會否直接透露答案,以及系統能否按不同程度的學員調整支援。
團隊如打算用大型語言模型扮學員做內部測試,就要留意模擬學員太聰明會高估工具成效,宜先以真實學員的紀錄對照。StudentSim 的論文及程式碼已在 GitHub 公開,據報道以 MIT 授權發佈,技術團隊可參考其評估方案;惟 Microsoft 強調模擬只是早期研究訊號,學習成效、安全及易用度仍要以真人測試確認,亦有評論指出 2 項指標並非直接量度學習成效。
AI 教學工具過去比拼誰答得對,StudentSim 則把問題推前一步,問學生聽完之後有沒有學會。如果這類評估方法獲業界採用,模擬學生可能成為 AI 教學工具部署前的一個測試環節。


