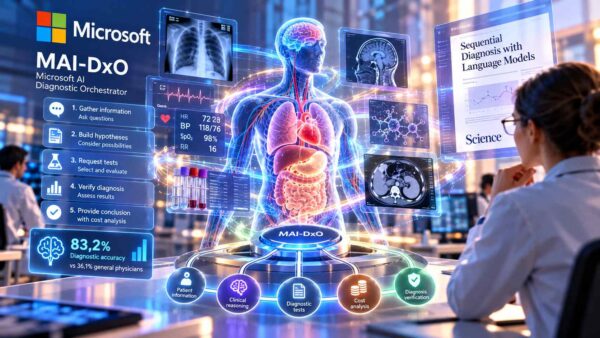
Microsoft AI 近日在《Science》發表診斷協調器 MAI-DxO(Microsoft AI Diagnostic Orchestrator)的研究。系統模擬虛擬醫生小組,逐步問診及選擇檢查。公司公布,在 304 宗複雜病例中,系統準確率達 83%;醫生不用參考資料時為 22%,可用參考資料時為 36%。過往急診個案測試亦錄得 80% 對 47% 的差距。公司另稱估算檢查成本可降至一半甚至三分一,但系統尚未經真實病人驗證。醫療機構評估這類工具,要分清基準分數、模擬成本與臨床責任。
虛擬醫生小組逐步問診,每項檢查都計成本
MAI-DxO 採用多代理架構,由有限病情資料開始,讓不同代理提出可能診斷、選擇病史問題或檢查,再互相質疑。系統經多輪討論,隨新證據更新判斷,同時衡量每項檢查的預期價值與成本。相對於一次過接收全部病例資料的模型,這種設計更着重如何取得足夠證據,以及何時作出診斷。
研究同時推出逐步診斷評估基準 SDBench(Sequential Diagnosis Benchmark),記錄診斷準確率、系統要求取得的資料,以及估算檢查成本,連診斷過程一併評分。Microsoft 亦宣布開源部分《New England Journal of Medicine》(NEJM)病例的評估資源,包括基準、Gatekeeper、Judge 及成本估算程式碼,供研究人員重做測試。
準確率達 83%,比較對象並非專科醫生
Microsoft 公布的 304 宗 NEJM 複雜病例測試中,MAI-DxO 準確率為 83%,約為不用參考資料醫生(22%)的 3.7 倍;醫生可以使用教科書及網上資料時,準確率升至 36%,系統的相對優勢便收窄至約 2.3 倍。因此「勝過醫生多少」取決於比較條件,不能把最有利的一組差距套用到所有醫療工作。
較常見的急診個案則取自 MIMIC-IV-ED 資料庫,涉及美國波士頓 Beth Israel Deaconess Medical Center 的過往入院資料。公司公布系統準確率為 80%,醫生平均為 47%,系統約為醫生的 1.7 倍;惟這是回顧性數據測試,並非在急診室即場處理病人的結果。
比較對象亦影響分數的解讀。參與比較的是內科或普通科醫生,沒有專科醫生或多專科團隊。外國傳媒指出,這類複雜病例在實際醫療環境通常交由專科醫生或團隊處理,因此現有結果尚不能回答系統相對這些團隊的表現。
成本減半屬估算,底層模型貢獻須分清
Microsoft 稱系統透過減少檢查,以一半甚至三分一成本取得正確診斷;其中一個較着重成本的設定,在 NEJM 病例取得 81% 準確率,估算檢查成本不到比較系統的一半。這些數字來自 SDBench 按美國價格估算的模擬檢查成本,並非醫院實際開支,也未包括系統授權、運算、整合及人手成本。
TechCrunch 對論文數據的分析則指出,表現改善很大部分來自底層模型:GPT-5 單獨配合簡單提示,在複雜病例的準確率已有 78.9%,每宗估算檢查成本約 8,400 美元(約港幣 HK$65,500);加入協調器後,每宗成本減少約 3,000 美元(約港幣 HK$23,400),準確率只增加約 4 個百分點。採購時因此可多問一個問題:協調層相對直接使用模型,究竟增加多少效益。
該分析亦指,在急診個案中,協調器相對單用 GPT-5 的準確率或成本增益不大;換用 GPT-5.5 後,兩種配置的準確率均約為 85%,較弱模型從協調層得到的改善較大。Microsoft 發言人回應稱協調層有助平衡準確率與成本。公司另表示,論文中的系統以 GPT-5 驅動,換用包括 GPT-5.5 在內的較新模型重做評估,即使不改協調方法,增益仍然存在甚至提高。
真實病人研究未開始,醫生仍是核心
基準測試尚未回答系統能否在真實臨床環境維持表現,Microsoft AI 行政總裁 Mustafa Suleyman 亦承認系統需要臨床驗證。截至發稿時,公司與 Beth Israel Deaconess Medical Center 合作的前瞻性研究仍未開始;計劃讓病人直接使用系統,再將結果與醫生的獨立判斷比較。所有病人會照常接受標準治療,同意參與者另外使用系統。
Microsoft AI 健康業務負責人、研究合著者 Dominic King 表示研究很可能在未來幾個月內展開,但沒有確實時間表。MAI-DxO 仍屬研究階段系統,未有商用版本,公司亦未公布推出時間、方式或定價。
King 強調醫療業監管及合規要求嚴格,須負責任地推出系統;Suleyman 則堅稱人類臨床醫生會一直是病人護理的核心。從病人維持標準治療、AI 結果另作比較的研究設計來看,臨床決定仍由醫生作出,但這不等於產品已訂明醫生與供應商在診斷出錯時的責任分配。
醫療機構評估 AI 診斷,先看臨床數據
對醫院、診所及醫療集團管理層而言,評估同類方案時,應先要求真實病人的前瞻性研究結果,並問清比較對象是普通科醫生、專科醫生還是醫療團隊。測試應分開底層模型與協調層的貢獻,並檢視模型升級後協調層是否仍有額外效益;美國病例的結果亦需要在本地病人身上驗證。
成本評估應將基準內的估算檢查費,與本地實際檢查價格、系統費用、運算及整合人手分開計算,待 SDBench 資源可取得後再重做評估。採購文件及內部流程則應列明 AI 建議的用途、由哪位醫生作最終判斷,以及出錯後如何保留紀錄和追查,而非直接把較高準確率換算成可部署的決定。